#量化
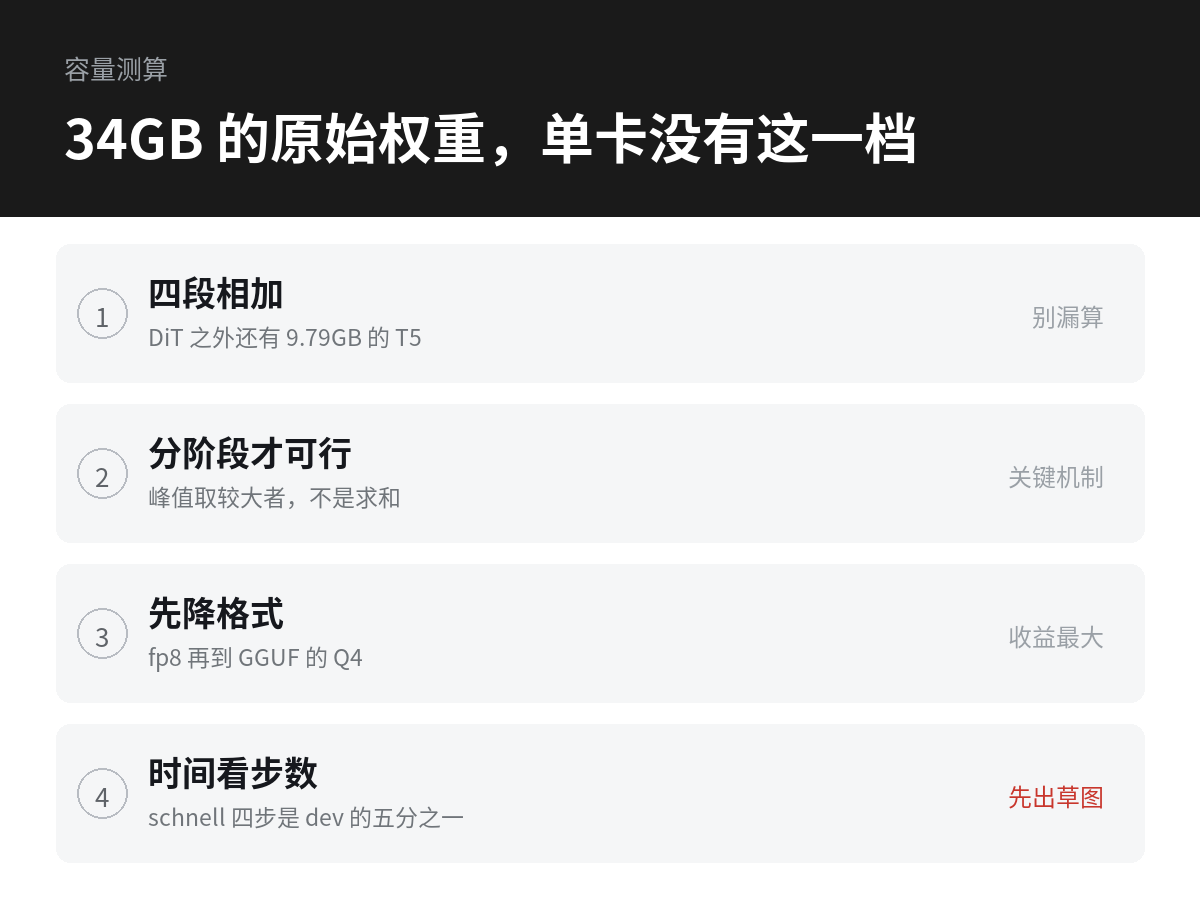
Flux 在 Intel 显卡上跑得动吗:显存账与三步降级
把 Flux 拆成 DiT、T5、CLIP、VAE 四段算显存,给出 fp16、fp8、GGUF 三档的真实体积与 12GB、16GB、24GB 卡的可行配置,再按「换量化格式、换文本编码器精度、降分辨率」三步给出降级顺序。
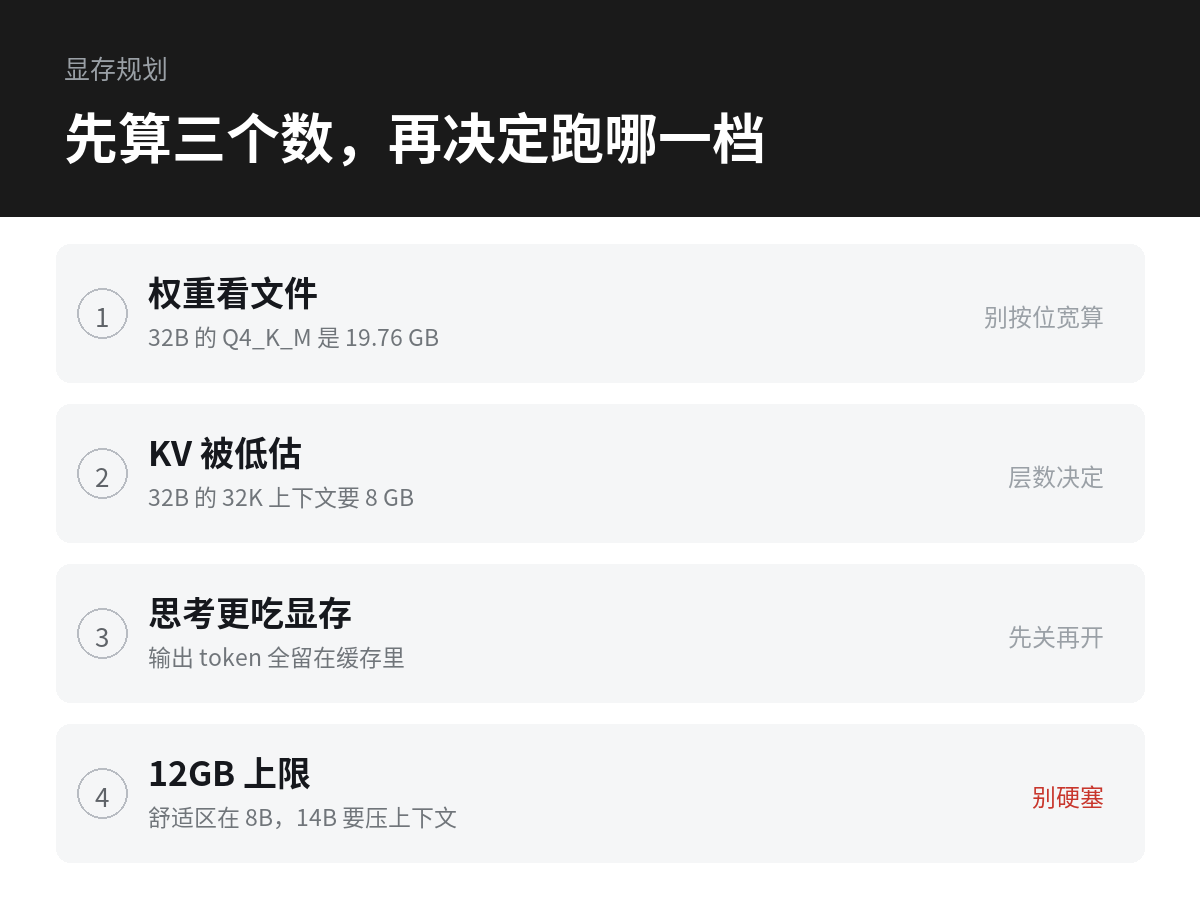
在 Arc 上跑 Qwen3:量化档位、显存占用与速度预期
按 Qwen 官方 GGUF 仓库的真实文件体积,算清 Qwen3 8B/14B/32B 各量化档的权重与 KV 开销,给出 12GB、16GB、24GB 三档 Arc 显卡的可行组合,并说明思考模式如何把输出长度变成显存压力。
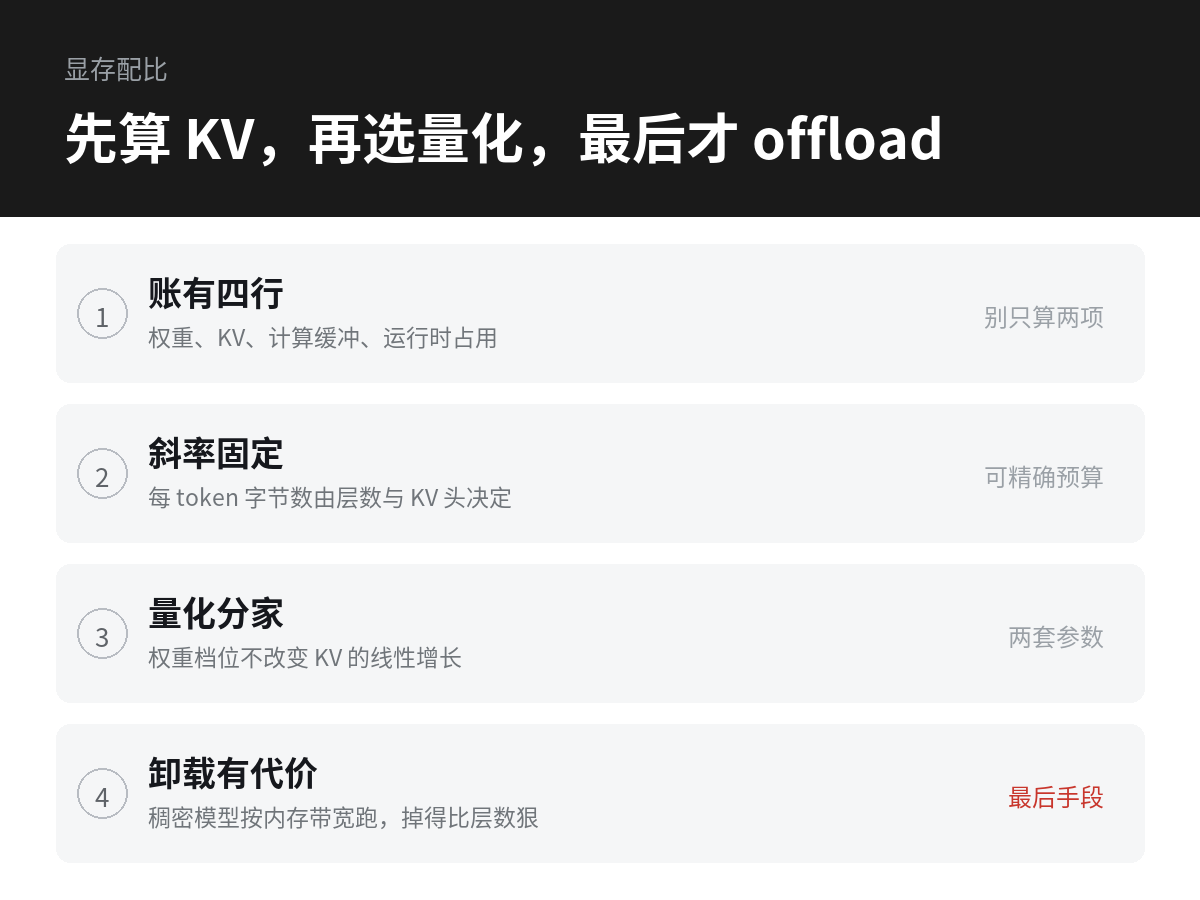
Intel 显卡显存不足:上下文、量化与 offload 的配比怎么定
KV cache 按每 token 的固定字节数随上下文线性增长,权重和缓存又是两套量化。先算清四行显存账单,再决定降上下文、换 KV 档位还是 offload,附 8/12/16/24GB 与四档上下文的可用性表。
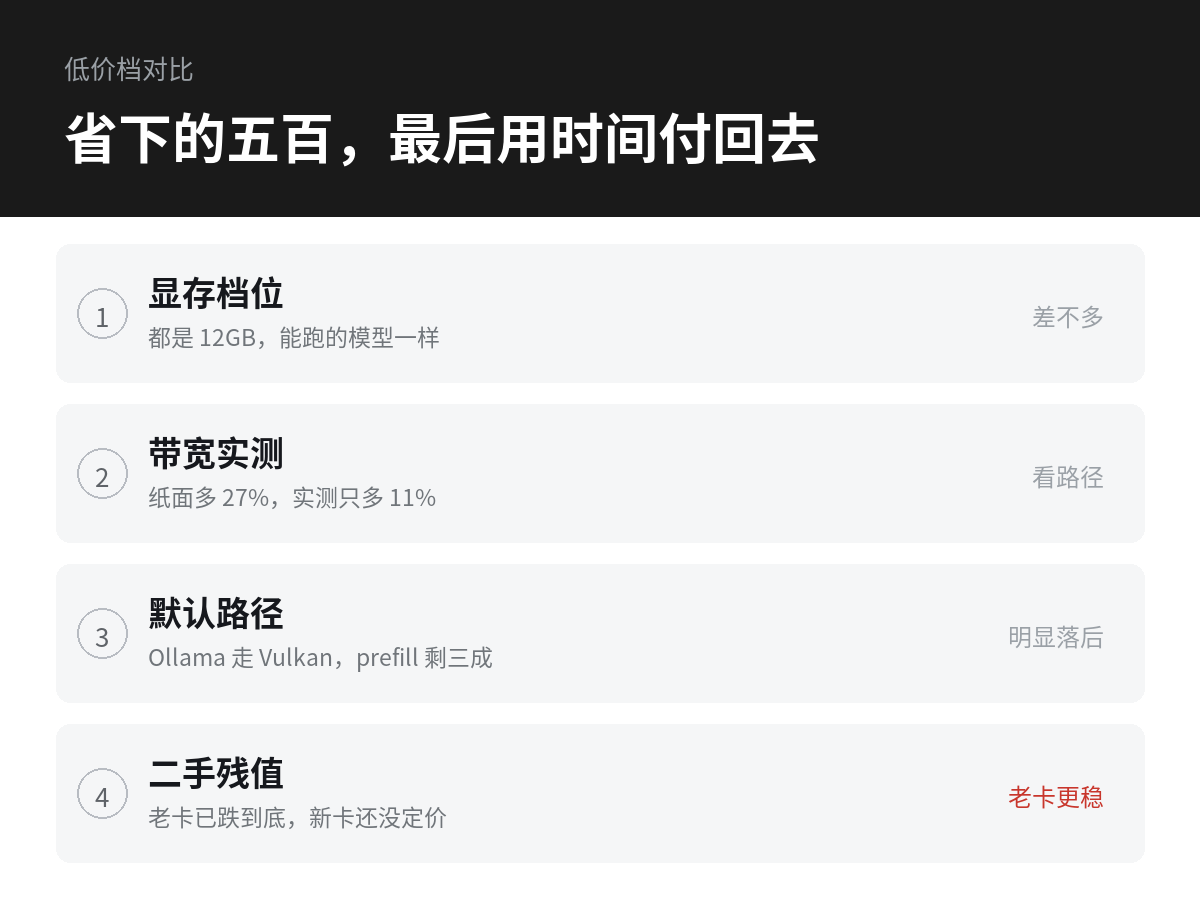
2000 块的 Arc 和二手 3060:本地 AI 的四笔账
两张 12GB 的卡,一张全新 1949 起,一张二手 1400 到 1660。显存档位打平,带宽纸面差 27% 但实测只差 11%,而默认的 Vulkan 路径让 Arc 的 prompt 处理只剩三成。四笔账算完,再按场景给结论。
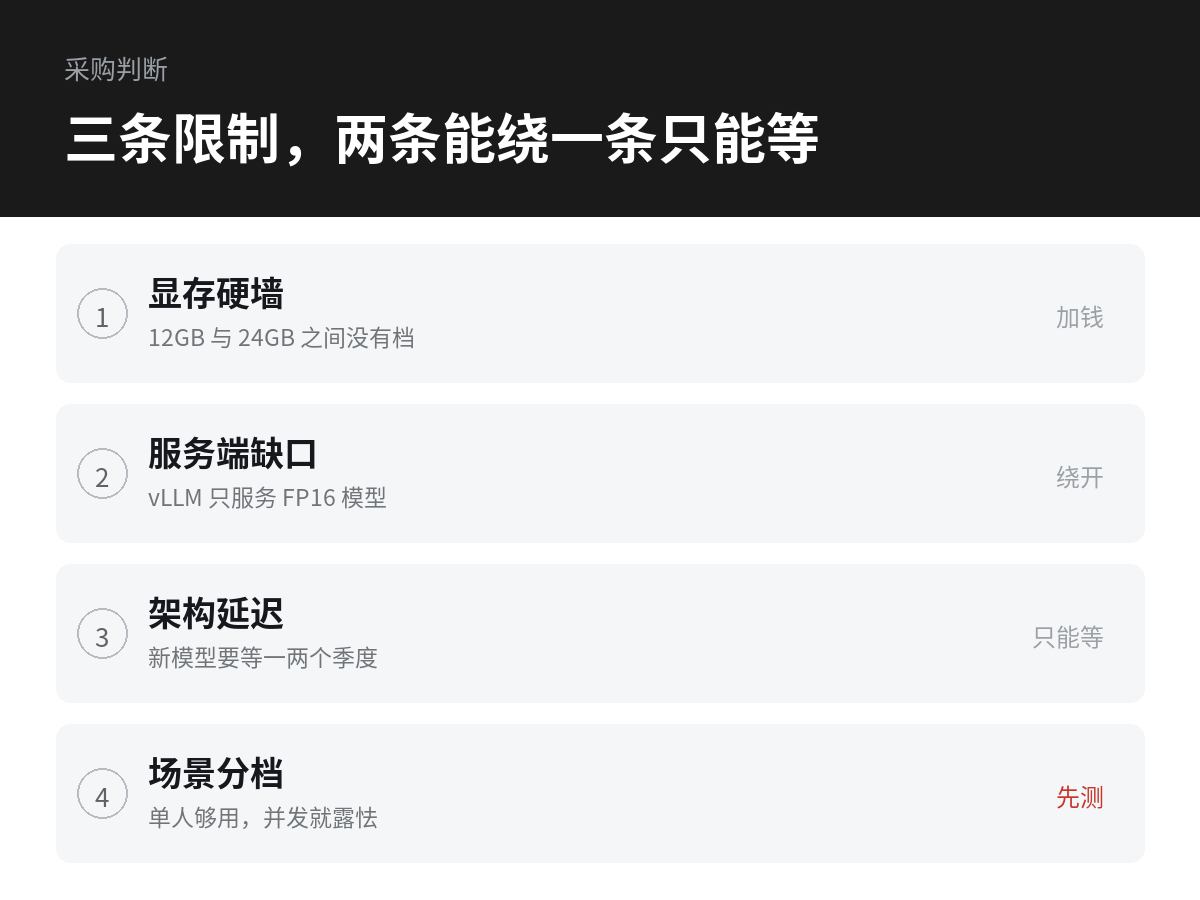
买 Intel 显卡做 AI 前要接受的三个限制
显存是加钱能翻的硬件墙,框架覆盖是只能绕的软件墙,新模型延迟是只能等的时间墙。三条性质不同,代价也不同。文中给出 B580 到 B70 的显存阶梯、vLLM XPU 的具体缺口,以及买之前半小时能做完的三步验证。
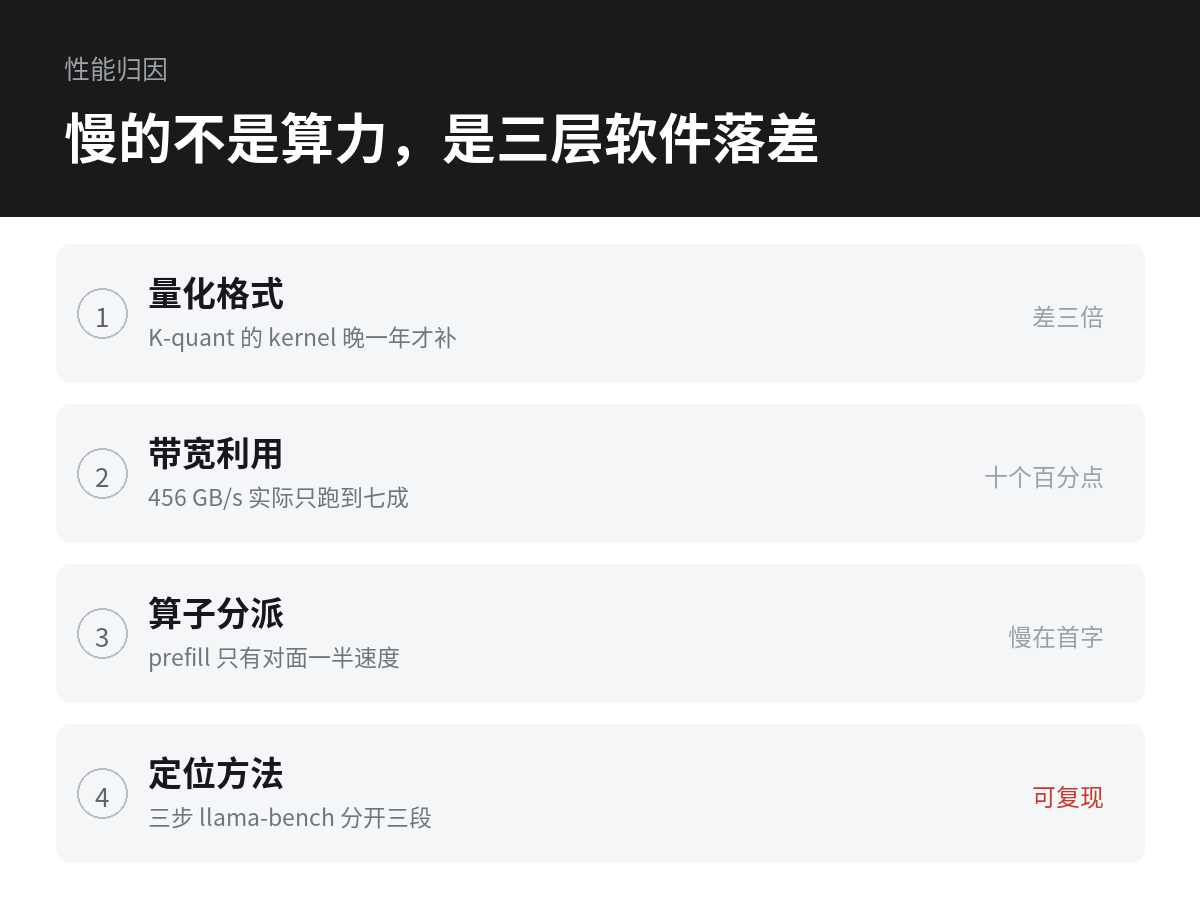
Intel 显卡跑 AI 为什么慢:三个瓶颈都不在算力
Arc B580 标称算力比 RTX 5060 Ti 更高,实测生成却差一截。把推理拆成 prefill 与 decode 两段能看出:影响最大的是量化格式的 kernel 覆盖,其次是算子调度,带宽利用率只占最后一小段。附三步定位法。
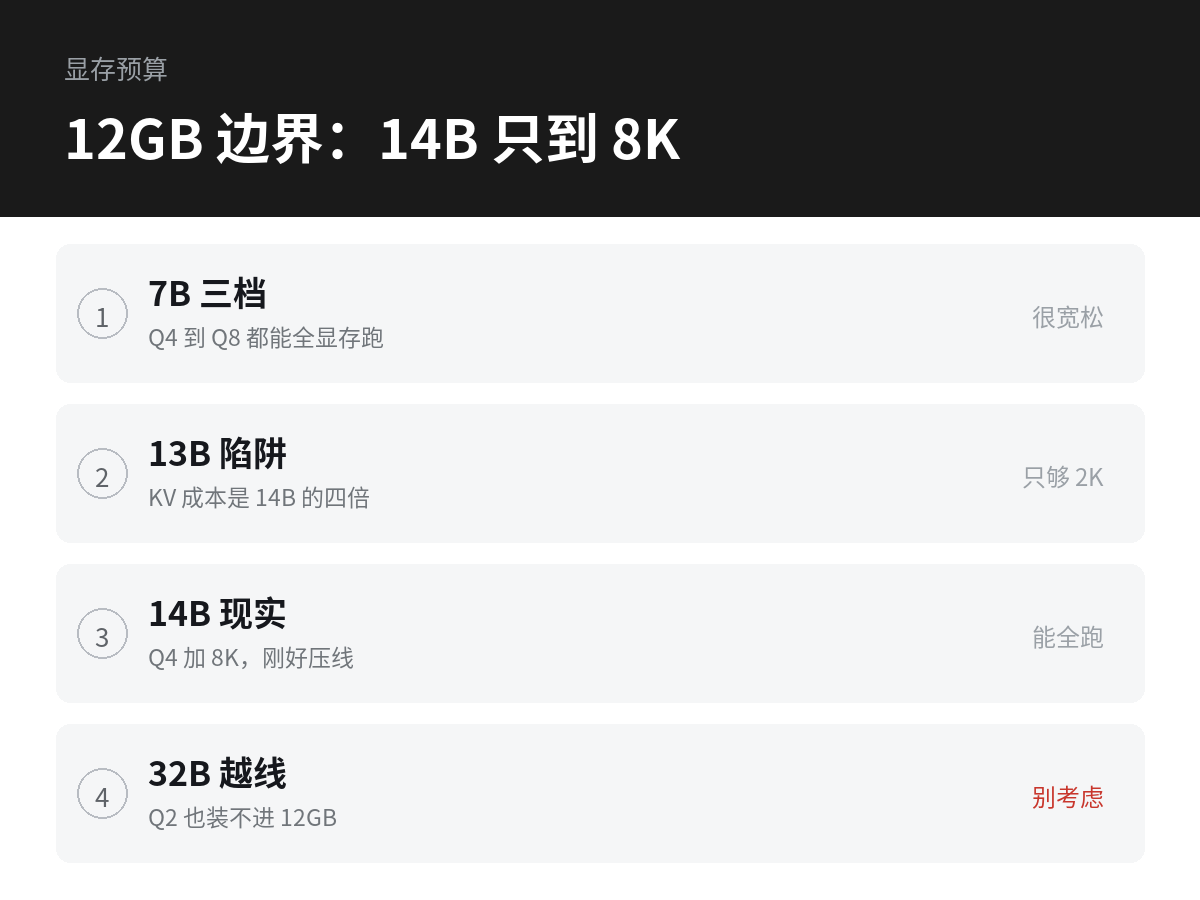
Arc B580 的 12GB 能跑多大模型:四档参数的真实边界
算清权重、KV cache 与运行时三笔账,给出 7B、13B、14B、32B 在 Q4、Q5、Q8 下的可用上下文与 offload 阈值,并说明越过边界后速度会掉到什么量级。