2000 块的 Arc 和二手 3060:本地 AI 的四笔账
两张 12GB 的卡,一张全新 1949 起,一张二手 1400 到 1660。显存档位打平,带宽纸面差 27% 但实测只差 11%,而默认的 Vulkan 路径让 Arc 的 prompt 处理只剩三成。四笔账算完,再按场景给结论。
2026 年二手市场有个反直觉的现象:五年前发布的 RTX 3060 12G,价格比半年前还高。
2026 年初闲鱼上 1200 出头能收到,到 8 月已经涨到 1400–1660。同一时期,全新 Arc B580 在京东的成交价是 1949–2199。
两张卡都是 12 GB、192-bit。差价五百块,一边是全新带保修,一边是五年卡龄加矿卡风险。
涨价的原因不复杂:这两年显存成了本地 AI 的硬门槛,8 GB 卡在二手市场反而更不值钱。
一张 4060 8G 因为显存小,二手性价比已经被 3060 反超。市场在用价格告诉你,容量比架构重要。
这篇不谈跑分排名,只算四笔账:显存档位、带宽与速度、生态与踩坑、二手残值。
算完再给分场景结论。差价五百值不值,最后取决于你的时间怎么标价。
第一笔账:显存一样,能跑的也一样
12 GB 是这一档的硬指标,两张卡打平。
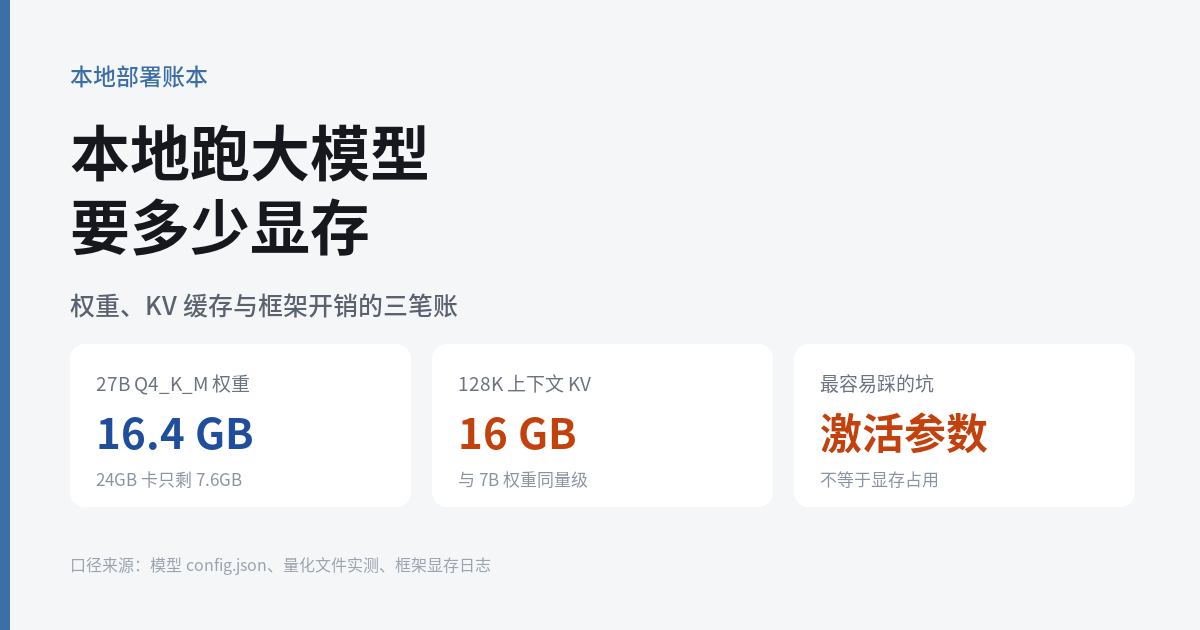
Q4 量化下,7B 约 4.5 GB,14B 约 8.5–9 GB,都装得下;27B 要 15 GB 起,都装不下。
所以"能跑多大的模型"这一栏,B580 与 3060 完全相同。差别不在容量,在风险。
先说清楚 12 GB 的边界在哪。14B 的 Q4_K_M 约 8.8 GB,装下之后还剩 3 GB 出头。
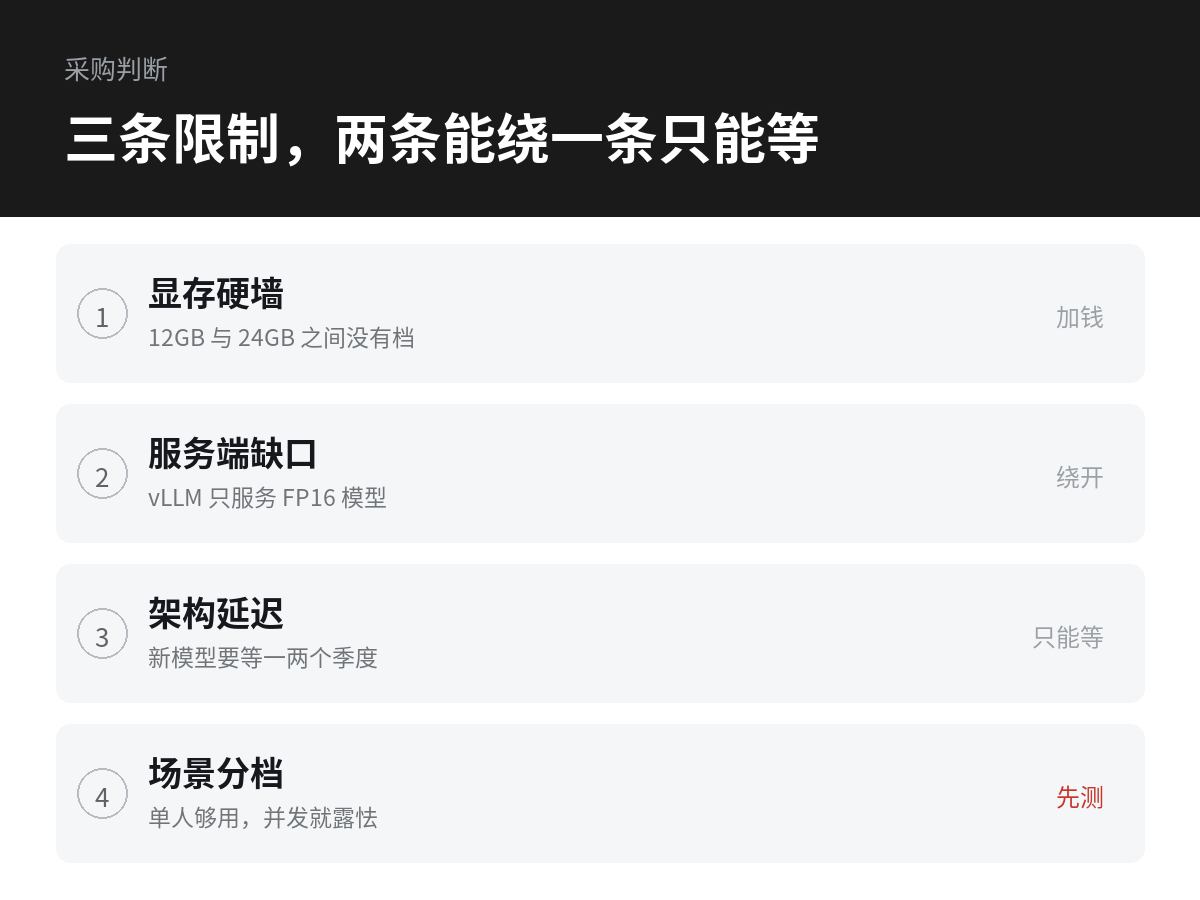
这 3 GB 要留给 KV cache 和运行时开销。上下文拉到 8K,KV 就吃掉一大块;拉到 16K,很可能开始溢出。
所以"能跑 14B"和"能舒服地跑 14B 长上下文"是两件事。后者在 12 GB 上要开 KV 量化才稳。
B580 是新卡,三年保修,没有矿史。风险在另一边:驱动与后端的成熟度,得自己承担。
3060 是二手,2021 年那批卡经历过矿潮,通电时长可能超过两万小时。
买二手要认准版本:3060 有 12 GB/192-bit 和 8 GB/128-bit 两种。
后者显存小、位宽窄,跑 14B 会直接不够。二手页面混着卖,看型号后缀和显存容量,别只看"3060"三个字。
差 4 GB 是什么概念?Q4 的 14B 约 8.8 GB,8 GB 卡装不下,只能降到 Q3 或者卸载层。
而 7B 在 8 GB 上也要压上下文,8K 就到顶。12 GB 换来的不是余量,是"能跑 14B"这个档位。
验卡的动作很具体:让卖家发 GPU-Z 截图看通电时长,到手先烤机十分钟,掉驱动立刻退。
SN 与 PCB 丝印对不上、风扇有拆装痕迹、显存颗粒品牌与公版不一致,这几条任一命中就划走。
还有一笔是保修。二手卡没有保修,任何故障都是全损;B580 三年保修,第一年出问题直接换新。
显卡不是易损件,但矿卡的故障率明显高于正常卡,风扇与显存颗粒是最常见的两个点。
这些都是时间成本,不是钱。但如果折算成"三次沟通、两次退换、一周等待",五百块的差价基本被抹平。
第一笔账的结论:硬件持平,风险不同。愿意验卡,3060 划算;不愿意,B580 买的是省事。
第二笔账:带宽多 27%,实测多 11%
B580 是 456 GB/s,3060 是 360 GB/s。纸面高 27%。
实测呢?同一份测试:Llama 2 7B、Q4_0、3.56 GiB 权重、tg128 与 pp512。
| 卡 | 后端 | tg128 (t/s) | pp512 (t/s) | 带宽 | 功耗 |
|---|---|---|---|---|---|
| Arc B580 | SYCL | 83.67 | 1954 | 456 GB/s | 190 W |
| Arc B580 | Vulkan | 70.14 | 621 | 456 GB/s | 190 W |
| RTX 3060 12G | CUDA | 75.6 | 2138 | 360 GB/s | 170 W |
B580 的 SYCL 数据来自 llama.cpp 讨论区 #23313(2026 年 6 月),另两行来自社区 Vulkan/CUDA 榜单。
生成速度上,三者挤在 70–84 之间。B580 用 SYCL 比 3060 高 11%,用 Vulkan 反而低 7%。
这个结果说明带宽不是唯一变量。B580 多出来的 27% 带宽,被后端效率吃掉了。
按"每 token 读一遍 3.56 GiB 权重"算理论上限,B580 是 119 t/s,3060 是 94 t/s。
实测折算下来,3060 跑到上限的 80%,B580 用 SYCL 是 70%、用 Vulkan 只有 59%。
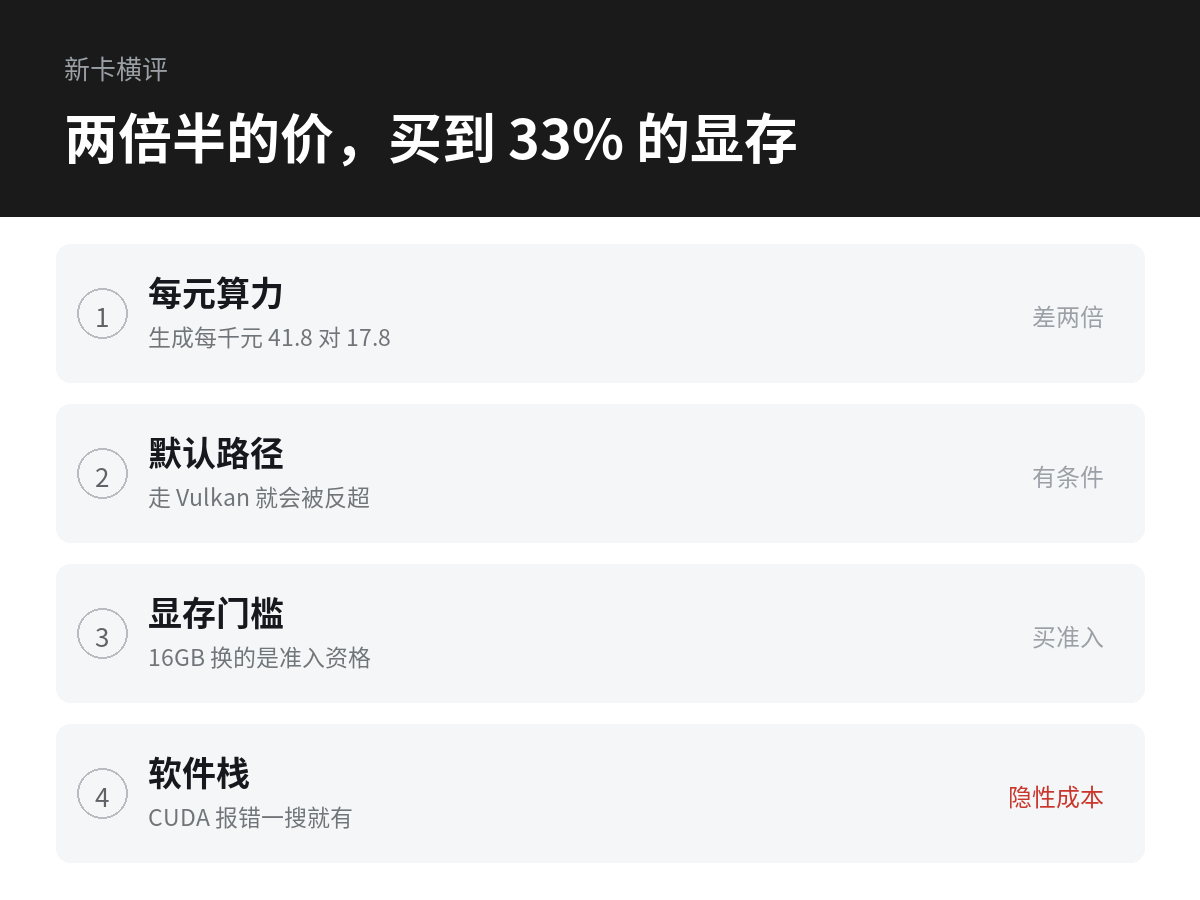
prompt 处理上差距就大了。B580 用 Vulkan 只有 621 t/s,是 3060 的 29%;换成 SYCL 是 1954,还略低于 3060 的 2138。
原因是 prefill 走的是矩阵乘矩阵,要靠矩阵单元。Vulkan 那条路用的是通用着色器路径,吃不到 Arc 的 XMX。
CUDA 那边早就把量化矩阵乘接到了张量核心上。3060 的算力不算强,但那条路径是通的,所以能跑出两千以上的 pp。
这也是"老卡不显老"的原因:硬件只是上限,能不能用上才是关键。
这一栏对体感的影响被低估了。你贴一段三千字的文档让它总结,等的就是 pp。
而 Ollama 和 LM Studio 在 Arc 上走的正是 Vulkan。也就是说,装上就能用的那条路,恰好在 pp 上最弱。
想吃到 SYCL 的 1954,得自己跑 llama.cpp 的 SYCL 构建,或者用它的容器。
SYCL 能把 pp 拉到 1954,是因为它走 oneDNN 与 XMX 的那条路,量化矩阵乘有专门的实现。
但这条路在 Windows 上还在改。2026 年 10 月就有一批构建出现 prefill 回退,修完才恢复。跟进新版意味着偶尔要当测试用户。
功耗差别不大:B580 是 190 W,单 8-pin,官方建议 600 W 电源;3060 是 170 W,单 8-pin,550 W 电源够用。
两台机器的电费差异一年也就几十块,不构成决策依据。
长上下文下两张卡都会掉,只是掉的方式不同。
KV cache 越长,每 token 要读的字节越多,带宽被摊薄,tg 会从 80 掉到 50 以下。这是 12 GB 档的共同天花板,与品牌无关。
3060 掉得慢一点,因为它本来就没跑满带宽;B580 掉得陡一点,因为它的上限更高。
第二笔账的结论:decode 打平,prefill 取决于你肯不肯折腾。默认路径下 3060 反而快三倍多。
第三笔账:生态与踩坑
CUDA 的优势不在速度快,在"不用想"。
ollama pull 之后就能跑;bitsandbytes、Unsloth、flash-attn 全都默认支持。
微调也一样。Unsloth 的安装脚本自动探测 NVIDIA 与 ROCm,装完直接能用,不用查文档。
ComfyUI 的自定义节点、ControlNet 预处理器、各类放大与分割模型,基本只测 CUDA。
Arc 这边分两条路,各有各的坑。
Vulkan 路最省事,装了驱动就能跑,Windows 与 Linux 都一样。代价是拿不到 SYCL 的性能,pp 只有 621。
Ollama 在 Intel 上就是这条路。Linux 需要装 Intel 的客户端驱动包,Windows 装 Arc 驱动即可,版本不能太旧。
SYCL 路性能好,代价是要 oneAPI 工具链。
Linux 上要装完整套件,并 source /opt/intel/oneapi/setvars.sh 之后才能编译。
Ubuntu 的发布包还要求机器上预装同版本 oneAPI,否则会卡在 libsycl.so 找不到。
Windows 有官方预编译包,解压即用,这点比过去好很多。
还有些坑不在文档里。比如 Unsloth 的安装脚本,自动探测只查 macOS、nvidia-smi、ROCm,没有 Intel 分支。
结果是在 Arc 机器上装,它会先报一句 "gpu none (CPU-only)",得手动设索引才走对。机器没问题,是脚本不认识。
这类问题的成本不好估。它不是"跑不起来",是"看起来跑不起来",要靠经验判断是环境还是硬件。
出图这一块,CUDA 的节点覆盖更全。
Arc 走 PyTorch XPU 能跑,ComfyUI 也会直接把它识别成 xpu 设备,不需要打补丁。这一点在第三方对 Arc Pro B70 的实测里被确认过。
但显存同为 12 GB,分辨率一往上就要靠量化模型或分块推理。速度上 Arc 没有明显优势,生态上少一圈第三方节点。
还有一层是工具链。PyTorch 从 2.5 起原生支持 XPU,torch.xpu 直接可用,这条路是通的。
但周边库对 XPU 的支持参差不齐:有的跟上了,有的要装 +xpu 的专用构建,有的干脆没有。
每遇到一个"没有",你就要在"换库"和"换实现"之间做一次选择。
顺带一个对照:AMD 卡走 ROCm,Linux 上覆盖到 RX 9000 与 7000 多款,Windows 收窄到 RX 7000 与部分 PRO 卡。
非 CUDA 的路都要看系统版本,这不是 Intel 独有的问题,但 Intel 这条路同时要看系统和工具链。
第三笔账的结论:时间成本是真实成本。一个人折腾一晚上,按什么价折算都超过五百块。
第四笔账:二手残值
这一笔最容易被忽略,但对"两年后卖掉换卡"的人是决定性的。
3060 的折旧已经走完了。它从当年的一路下跌,跌到 2026 年初的 1200 出头,再涨回 1400–1660。
这说明市场已经给它定了一个"12 GB 硬通货"的底价。
也就是说,你现在 1500 买进,明年大概率还在这个区间里。跌的空间小,因为它已经跌过一轮。
B580 的折旧才刚开始。新卡 1949,二手市场很薄,愿意接的人少。
$249 的首发价折算过来接近 1800,国内成交价 1949–2199,中间的差价是渠道与税。
一年后能卖多少,目前没有公开的成交数据,只能参考同价位全新卡的一般规律。
流动性是更实际的问题。3060 有大量存量,想卖随时有人接;B580 的二手买家群体小,卖的时候要么降价,要么等。
二手交易本身也有摩擦。验机、议价、物流、平台担保,每一步都在消耗时间,且结果不确定。
买 1500 的卡和买 1950 的卡,后者的交易成本几乎为零。这也是"省五百"经常被高估的原因。
如果一定要买二手,优先选带店保或还在保的卡,多花一两百换一条退路,通常值得。
还有一层共同风险:如果两年后 12 GB 变成"跑不动主流模型"的门槛,两张卡会一起跌。
那时候残值差异就不重要了,重要的是谁跌得早、谁还有替代用途。3060 至少还能当游戏卡。
第四笔账的结论:3060 残值稳,因为它已经跌到底;B580 残值不确定,因为还没有形成二手市场。
四笔账合起来是一句话:买 3060 是用不确定性换钱,买 B580 是用钱换确定性。
分场景结论
只跑 7B、8B 聊天,且能接受验卡:二手 3060。省五百,性能不输,装完就能用。
不愿意碰矿卡、也不想验:B580 加 Vulkan。接受 prompt 处理只剩三成,换三年保修和零风险。
要出图:3060。CUDA 的节点生态是决定性的,不是算力问题。
想长期折腾、学 SYCL 与 oneAPI、跟着 llama.cpp 的更新走:B580。
新架构、保修、后端还在快速迭代。2026 年就出现过多次两三倍级的修复,跟进的人能吃到这波红利。
要跑 14B 以上的长上下文:两张都不够。直接看 24 GB 档,别在这一档上加钱。
预算正好卡在 1500:二手 3060 是唯一选择。B580 的 1949 已经是另一个档位,别硬凑。
混合场景要分开算。白天写代码用 7B,晚上出图,那两张卡各有一半时间闲着,不如把钱集中到一张 16 GB 以上的卡上。
拿不定主意的话,先买二手 3060 用半年。它的残值稳,试错成本最低,半年后你自然知道该往哪边走。
买回来先自测
收到卡先确认设备与显存是真的。
# 3060(CUDA)
nvidia-smi --query-gpu=name,memory.total,power.limit --format=csv
# B580(Windows,SYCL 预编译包)
.\llama-bench.exe -m model.Q4_K_M.gguf -p 512 -n 128 -ngl 99 -mmp 0再看生成与 prompt 两段的比值。tg 落在 70–85 之间属于正常,明显偏低先查是不是层被卸载。
日志里的 llm_load_tensors: buffer_size 接近显存总量,就说明已经贴边,上下文一长必然溢出。
最后拿你自己的常用模型跑一遍,而不是别人的 7B 基准。模型结构不同,Arc 上的表现会差很多。
MoE 模型尤其如此。激活参数少,理论速度接近小模型,但专家权重要全部驻留显存,12 GB 很快就见底。
两张卡都跑不了 20B 级 MoE 的完整版本。这一点在买之前就要想清楚,别指望量化能救。
显存怎么按模型档位估算,本地跑大模型要多少显存那张表可以直接对照。
12 GB 能塞下多大的 Qwen,Qwen3.8-27B 的显存账里给了具体数字。
如果你打算两张卡都用,先分清服务和客户端,Ollama 的这层关系会省掉不少排查时间。
登录后可点赞、收藏与反馈。