Claude Code 深度解析:终端里的编码 Agent 强在哪
Claude Code 先读代码库再动手,把权限规则、沙箱与 hooks 做成可执行的边界。本文拆解它的上下文来源、约束机制与成本控制方法,并给出它与 Cursor、Codex、Copilot 的分工。
补全工具解决的是"下一行写什么",Claude Code 解决的是"这一批文件怎么改"。它把读代码、改文件、跑测试、看报错串成一个循环,人只负责给目标和验收标准。这也是它和编辑器插件最根本的分野。
一个仓库就是上下文
Claude Code 是 Anthropic 的终端 Agent。在仓库目录里启动会话后,它做的第一件事不是写代码,而是读代码:找入口、追依赖、看测试怎么跑,然后才给出改动方案。对跨几十个文件的重构,这种"先建图再动手"的顺序,比逐行补全更接近人类工程师的做法。
上下文不只来自当前打开的文件。项目根目录的 CLAUDE.md 会被读入,用来放构建命令、目录约定和禁止事项。这里有个容易被忽略的细节:官方文档明确说 CLAUDE.md 是"指导",模型可以判断某条不适用。所以它适合放偏好,不适合放零例外的硬规则。
除了终端,它还有 IDE 扩展与 Web 会话两种入口。终端不是唯一形态,但终端是能力最完整、最容易脚本化的形态。
权限、沙箱与 hooks:把"应该"变成"必须"
Agent 落地时最常被问的问题不是"它会不会写错",而是"它能不能被我管住"。Claude Code 的答案分三层。
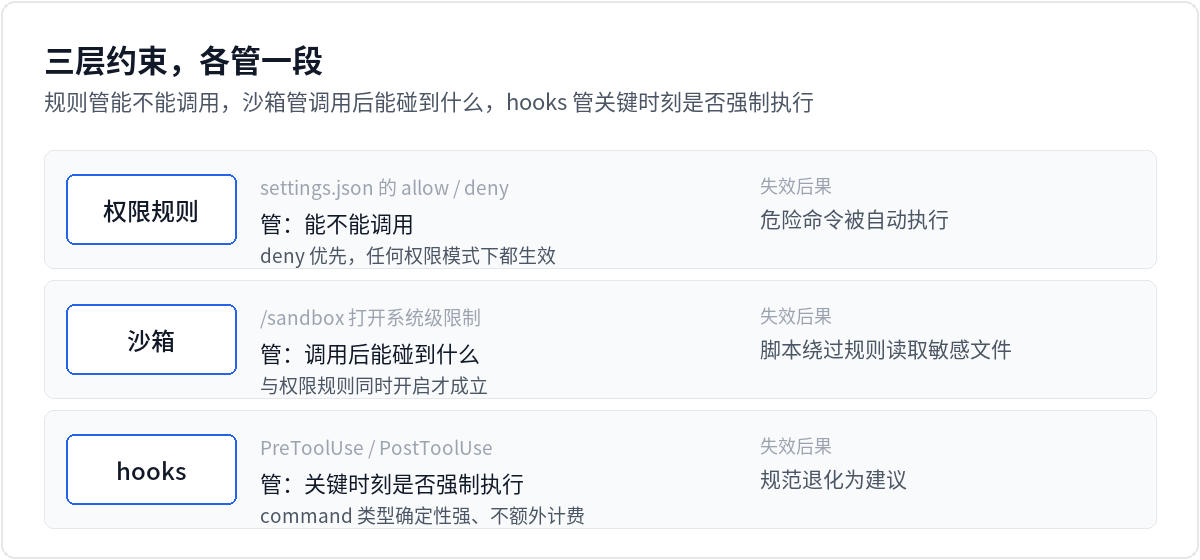
图 1 三层约束各管一段,缺一层会留下什么口子
第一层是 settings.json 里的 allow / deny 规则。deny 优先于 allow,并且在任何权限模式下都生效,包括自动模式和 bypassPermissions。所以"永远不要读 .env""不许碰 migrations 目录"这类要求,正确的位置是 deny 规则,而不是写在文档里靠模型自觉。
第二层是沙箱。/sandbox 打开操作系统级的文件与网络限制,约束的是 shell 命令能触及的范围。官方对安全场景的建议是两者同时开:权限规则管"允不允许调用",沙箱管"调用之后能碰到什么"。规则能拦住 cat .env,但拦不住一个自己打开文件的脚本,这就是沙箱存在的理由。
第三层是 hooks。它在固定的生命周期节点执行你自己的命令:PreToolUse 可以在写入前拦下越界操作,PostToolUse 可以在每次编辑后跑一遍格式化或 lint。command 类型的 hook 确定性强、不额外花钱;prompt 与 agent 类型会把判断交给模型,适合正则表达不了的场景,但要接受它偶尔误判,也要接受多一次模型调用。
判断一条规则该放哪里,标准很朴素:漏一次会不会出事?会,就用 hook 或 deny 规则;不会,才留在 CLAUDE.md。
Subagents 与成本:并行不是免费的
subagent 的核心价值是隔离上下文,而不是"多开几个 AI"。让一个只做代码审查的子 Agent 去读 diff,主线程就不会被几百行改动塞满;几个互不依赖的排查也可以并行推进。
代价同样明确:每个 subagent 独立发起请求、独立占用额度。所以并行要用在刀刃上——独立调研、独立审查、独立验证,而不是把一个连续的任务切碎。
成本控制有三个实操点。不相关的任务之间用 /clear 断开,避免第四个任务每轮都重读前三个任务的上下文;长会话用 /compact 并指定要保留的内容,比如"保留 API 变更和测试命令";用 /cost 看 prompt cache 的命中率,成本异常升高往往不是模型选错,而是缓存反复未命中、整段上下文被重新计费。
effort 级别同样影响开销。日常修改用低档,难题再抬高,ultrathink 留给真正需要深推理的那一次提问,而不是每句话都加。
它适合谁,不适合谁
适合三类场景:有测试、验收标准明确的中大型仓库;需要把团队规范落到可执行层面的工程团队;接受"先读后改"节奏、愿意在终端里工作的开发者。
不适合另外三类:没有版本控制、没有测试的项目——Agent 失去自我验证能力,改错了也发现不了;只想补全一行的轻量场景——编辑器插件的边际成本更低;模型必须锁定在非 Anthropic 体系的团队。
和 Codex、Cursor、Copilot 的边界
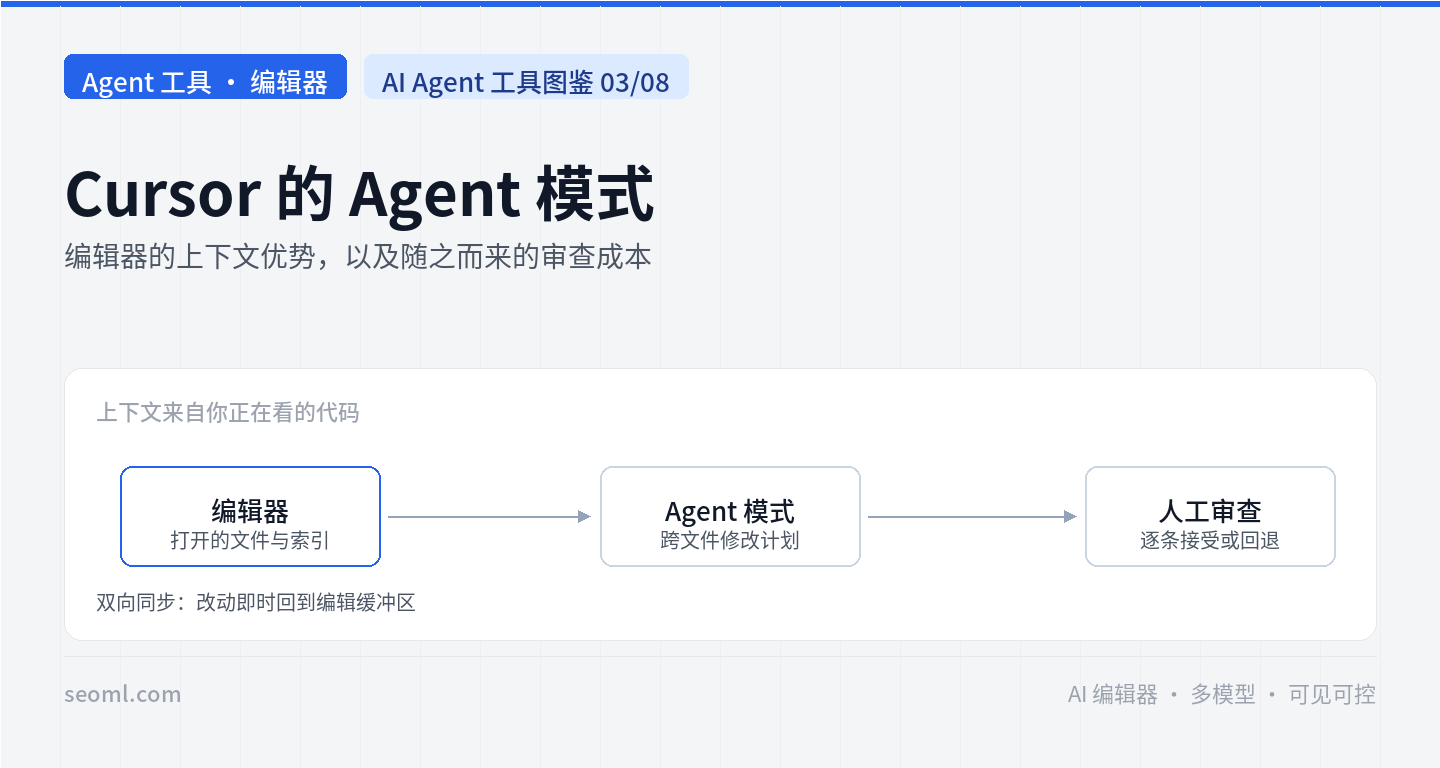
对 Cursor,差别在上下文的来源。Cursor 的上下文是你打开的编辑器,优势是每一步都看得见;Claude Code 的上下文是工作目录加主动读取,优势是长任务不被打断、过程可脚本化、规则可以随仓库一起版本化。
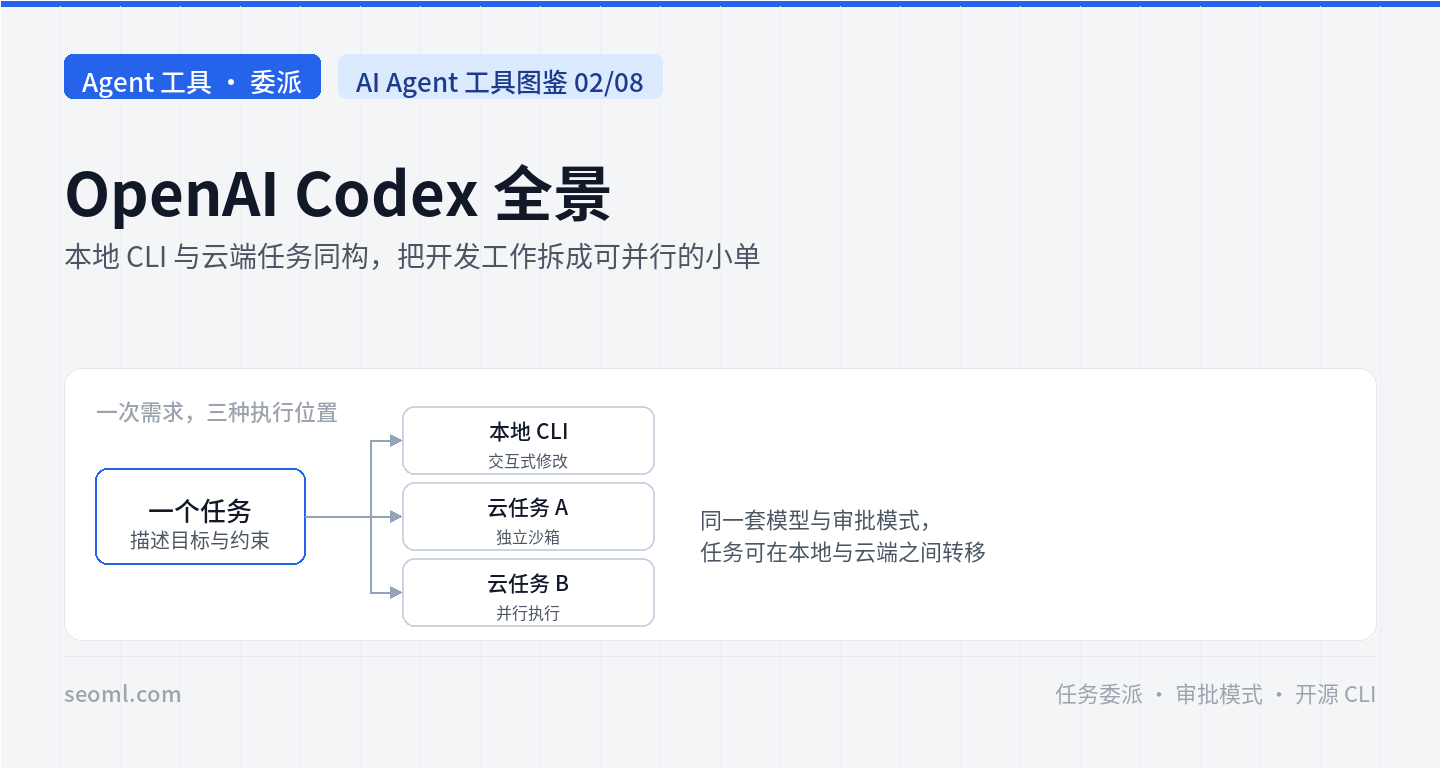
对 Codex,差别在重心的位置。Codex 把"多个云端任务并行"做成一等公民,本地 CLI 与云任务同构;Claude Code 把力气花在单个会话的深度和治理体系上——权限、hooks、组织级 managed settings。一个偏"派活",一个偏"干活"。
对 GitHub Copilot 编码 Agent,差别在入口。Copilot 从 issue 进、从 PR 出,天然嵌进既有的 review 流程;Claude Code 不绑定代码托管平台,适合在本地把改动做完、验证过,再走提交。前者适合把任务交给流程,后者适合把流程交给工程师自己掌握。
顺便说一句,Agent 的成本结构本身值得单独算账:同一张榜单上,完成一次任务的 token 消耗可能相差十几倍,按单价选模型经常会算错(见《同一个榜单,单任务成本差 13 倍》)。而权限边界的意义,也不只是防手滑——当 Agent 能自主执行几十步时,可中断、可回滚才是前提(见《OpenAI「控制室」:35 秒叫停失控智能体》)。
上手时的三条建议
第一,CLAUDE.md 先写最小版本:构建、测试、目录三件事,不要一上来写成规范手册。写多了,模型会挑着看。
第二,先把危险命令的 deny 规则和沙箱配好,再放开自动执行。顺序反了,第一次事故就会让团队退回全手动。
第三,用任务粒度控制风险。一次一个可验证的目标,改完跑测试,通过了再进下一个。Agent 的效率来自连续执行,风险也来自连续执行。
Claude Code 的竞争力不在"更会写代码",而在把 Agent 的不确定性收进了可配置的边界里。对团队而言,这比补全准确率多几个百分点更重要。
登录后可点赞、收藏与反馈。