#技术决策
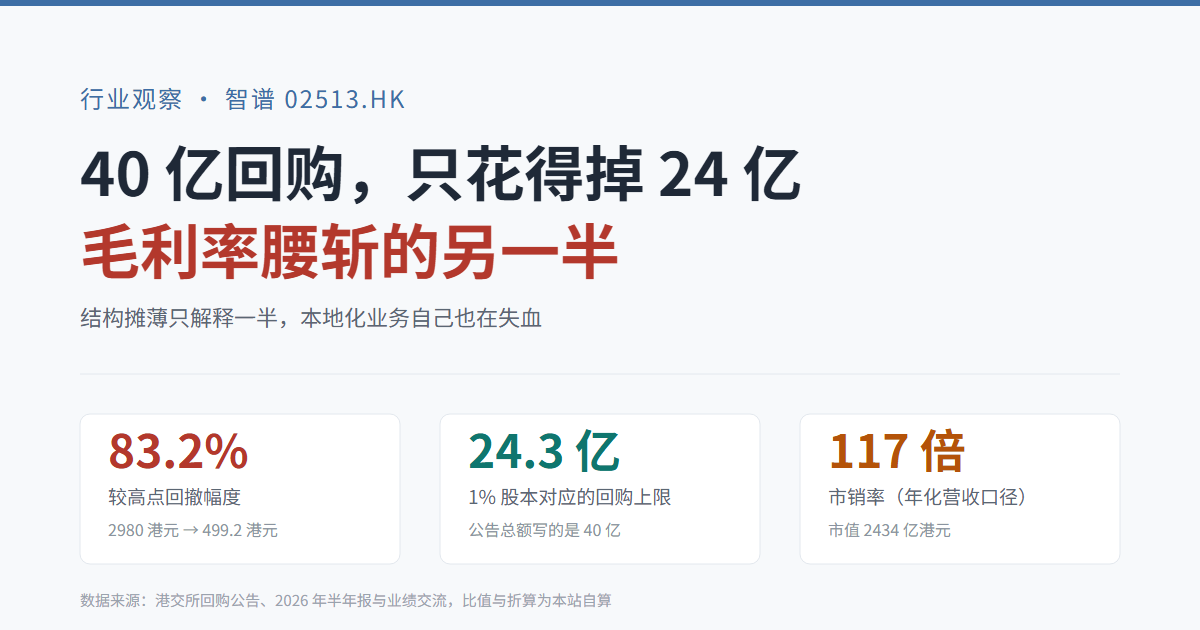
智谱 40 亿回购:API 毛利率转正,综合毛利率腰斩
11 月 10 日智谱抛出 40 亿港元回购,但 1% 股本只对应 24.3 亿。综合毛利率从 50.0% 降到 26.4%,拆开看,结构摊薄只解释了一半。
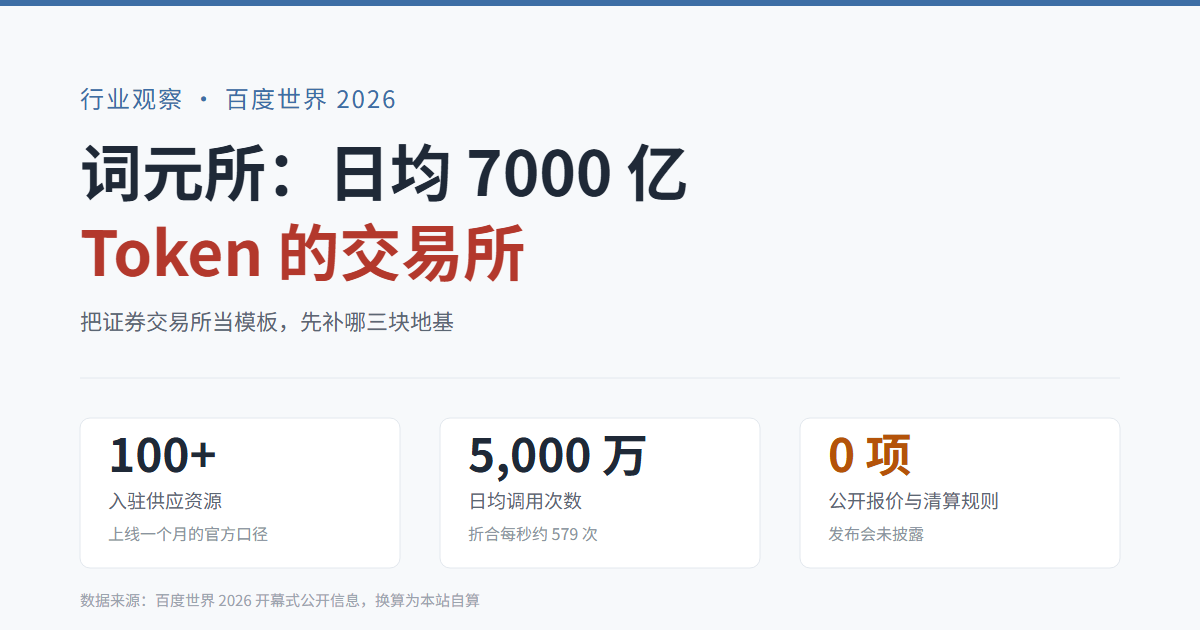
词元所:日均 7000 亿 Token 的交易所,缺三样东西
百度世界 2026 上线的词元所,一个月做到日均 7000 亿 Token。但交易所需要的公开报价、清算规则与违约处置,发布会一字未提。
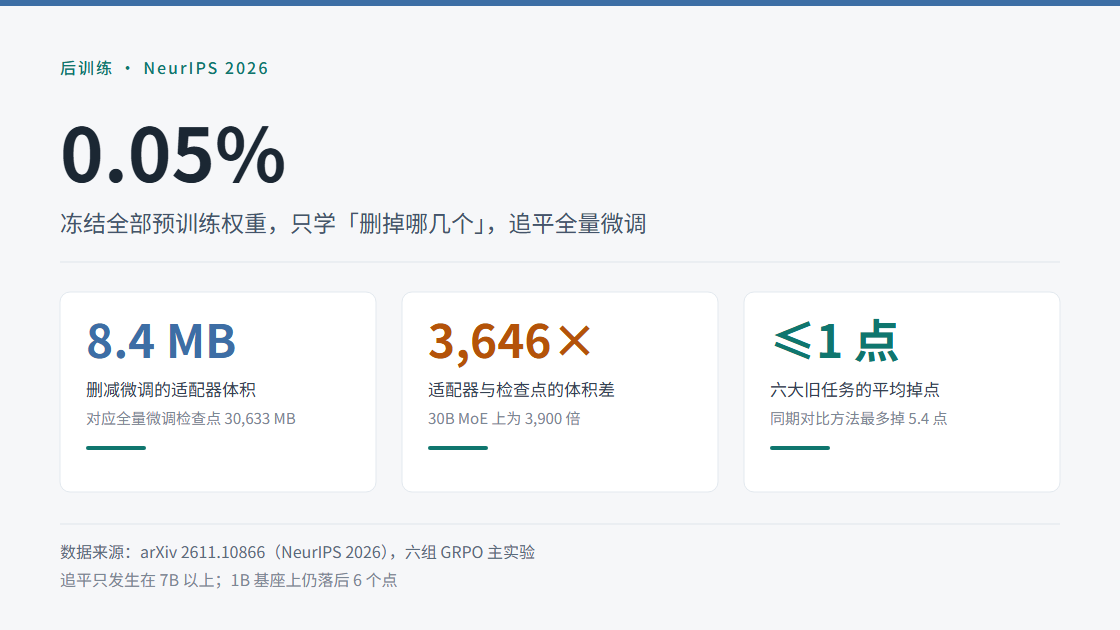
删掉 0.05% 权重追平全量微调,适配器只剩 8.4MB
NeurIPS 2026 的 Deletion Tuning 冻结全部预训练权重,只把不到 0.05% 的权重置零,在 8 个基座上追平全量微调。本文拆开机制、7B 门槛与三处不能照抄的地方。
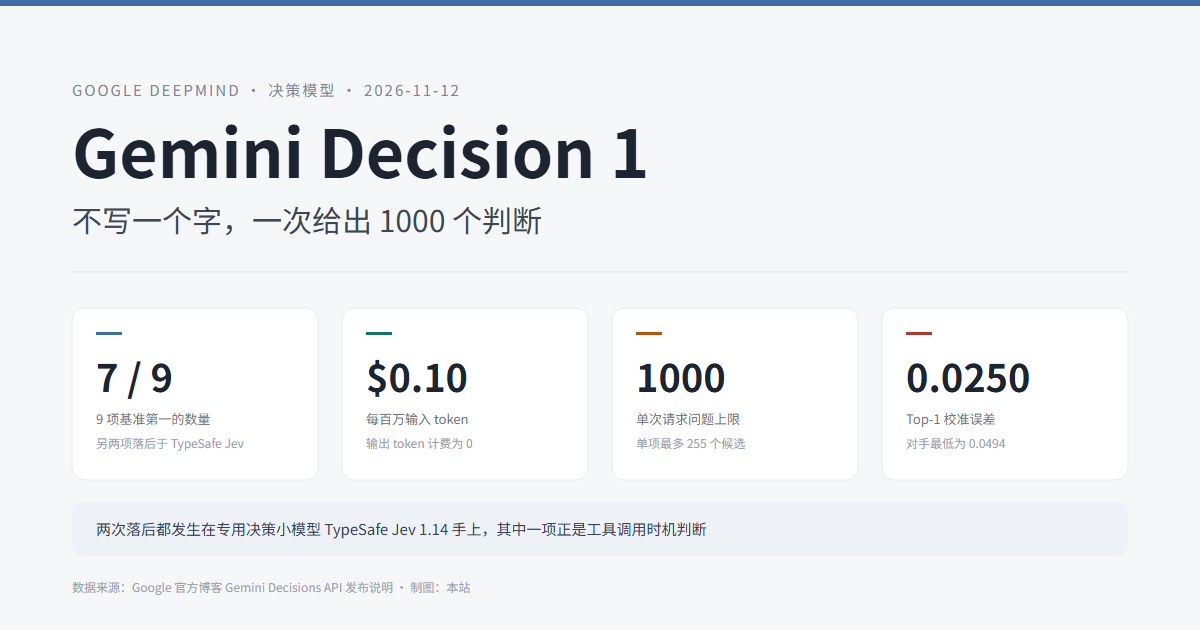
Gemini Decision 1:7 胜 2 负,单次请求 0.6 美分
谷歌发布首个专做封闭选项判断的模型:一次请求最多评分 1000 个问题,只按输入计费;9 项基准 7 项第一,两项输给专用决策小模型,校准误差低一个量级。
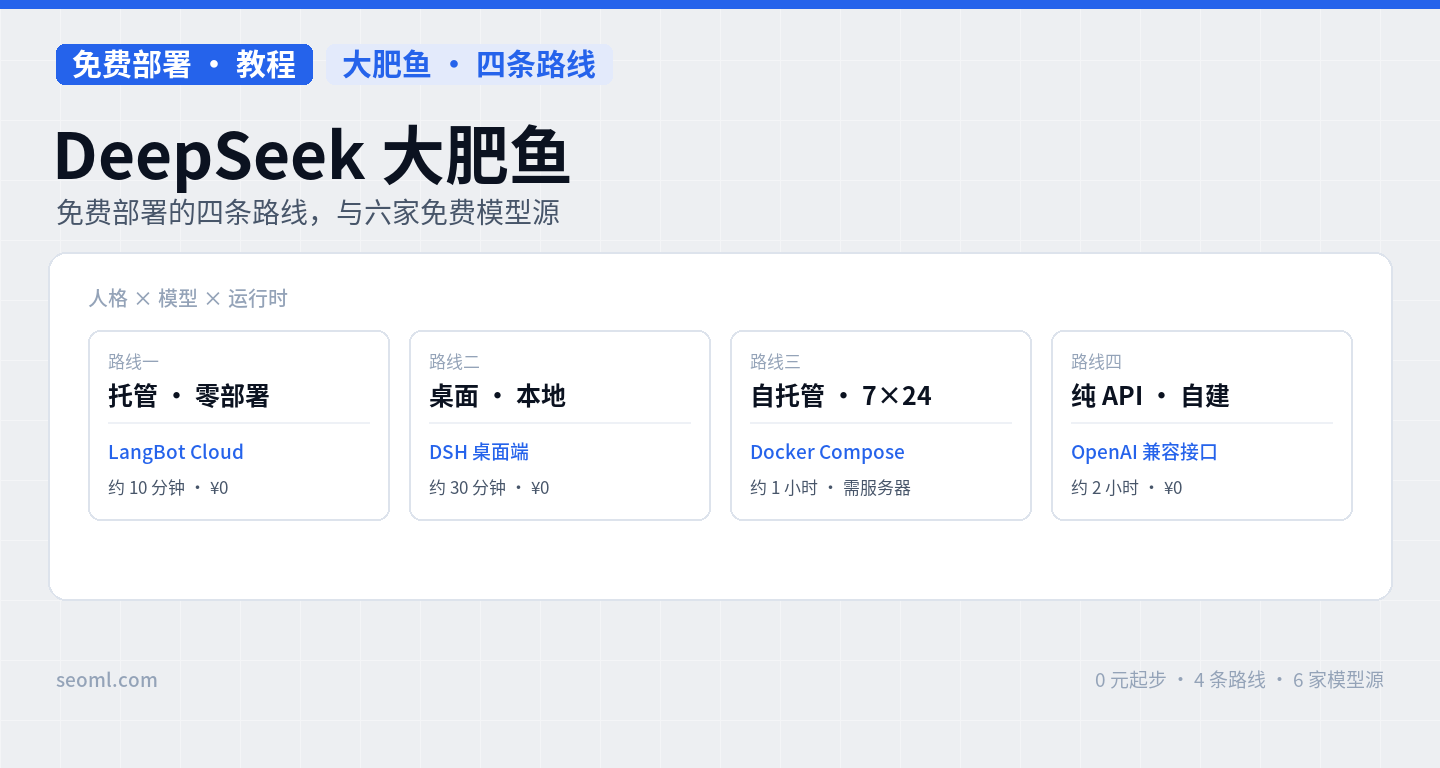
DeepSeek 大肥鱼免费部署:4 条路线与 6 家模型源
大肥鱼是社区给 DeepSeek 做的拟人角色,跑起来要三样东西:人格提示词、常驻运行时、模型供给。本文给 4 条部署路线与 6 家免费模型源,逐条标出上手时间、成本与断线风险。
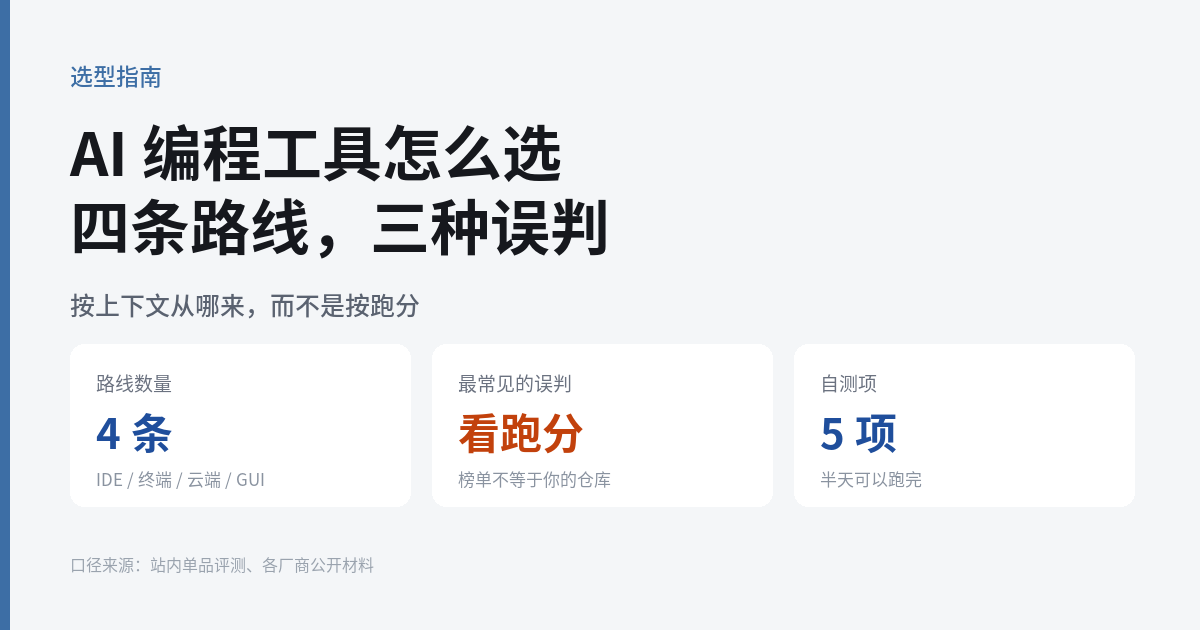
AI 编程工具怎么选:四条路线,三种误判
榜单测的是单点能力,你面对的是陌生仓库和不许破坏的既有代码。本文按「上下文从哪来」拆四条路线,给出任务到形态的决策表、三种最常见误判,以及一套半天能跑完的 5 项自测方法。
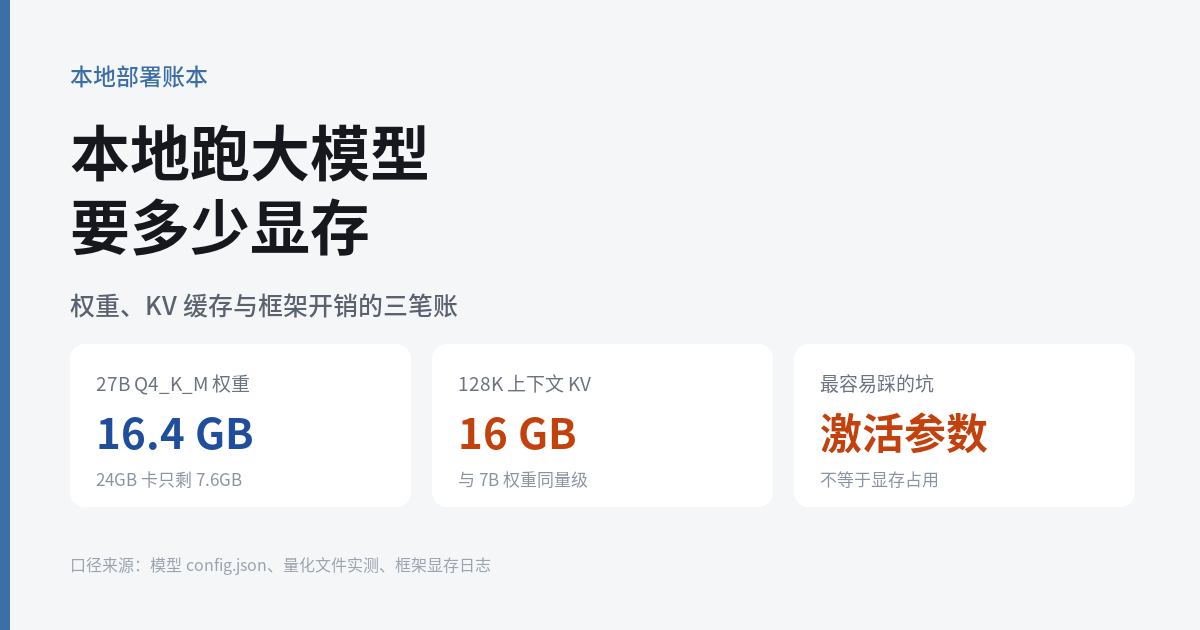
本地跑大模型要多少显存:8 档参数与 3 种精度对照
显存不是一条公式能算完:权重占参数×字节,KV 缓存随上下文线性增长,框架还有 1-2 GB 开销。本文给出 8 档参数在 FP16/INT8/Q4 下的权重表、常见显卡能跑多长上下文,以及 MoE 与量化最容易踩的三个坑。
Qwen4-Max 预览:1M 上下文,只卖 14 天
阿里通义
阿里 11 月 11 日放出 Qwen4-Max 预览版,1M 上下文、393,216 最大输出,只支持 Token Plan 套餐,11 月 25 日到期下线。本文拆三个明牌与两个空白,并给出 14 天窗口的试用顺序。
- 参数
- 未公布
- 上下文
- 1M tokens
- 价格
- Token Plan 限时 2 折,最低 1 折
- 模态
- 多模态
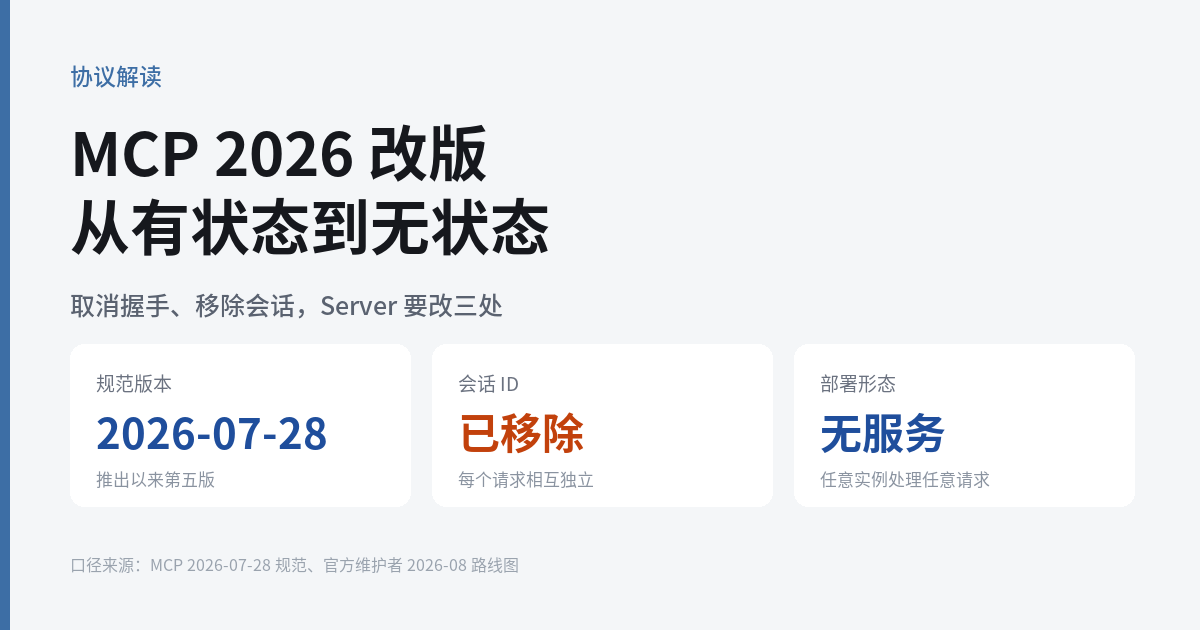
MCP 是什么:2026 无状态改版,Server 要改三处
MCP 在 2026-07-28 完成推出以来最大改版:协议彻底无状态、初始化握手取消、会话 ID 移除。本文拆清三类原语、两种传输,以及现有 Server 必须改的三处代码,并说明什么场景不该用 MCP。
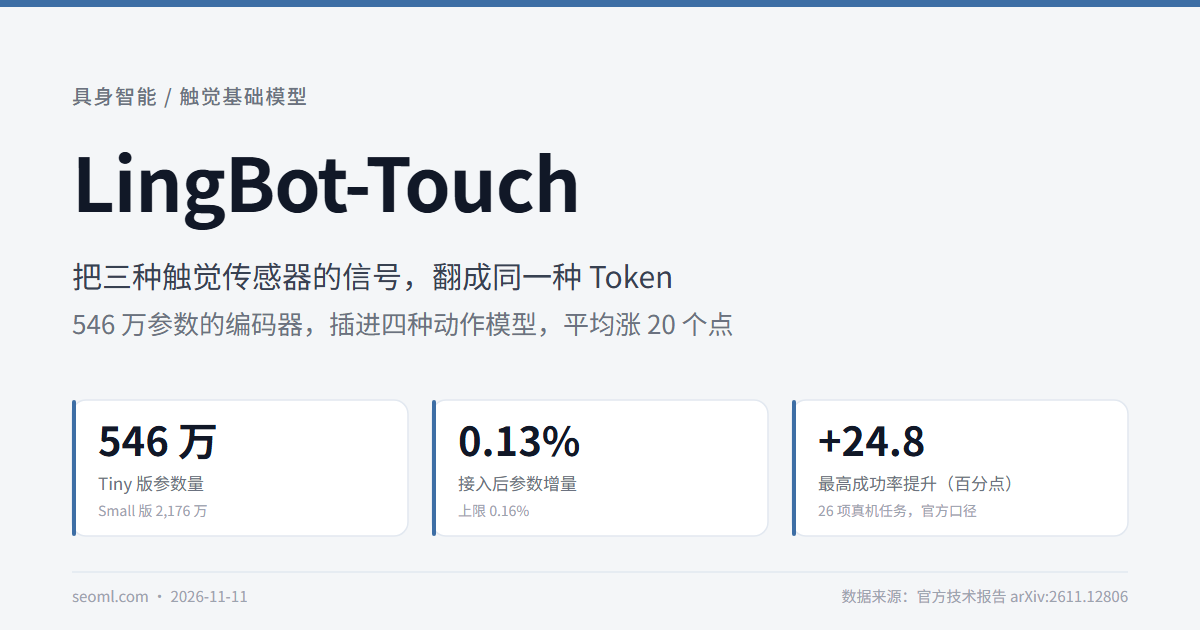
LingBot-Touch:0.13% 参数换 25 个点
蚂蚁灵波开源触觉基础模型,用 4983 小时真实触觉数据训出 546 万参数的编码器,插进四种动作模型平均涨 20 个点。拆开看它凭什么跨传感器通用,以及开源只开到哪一层。
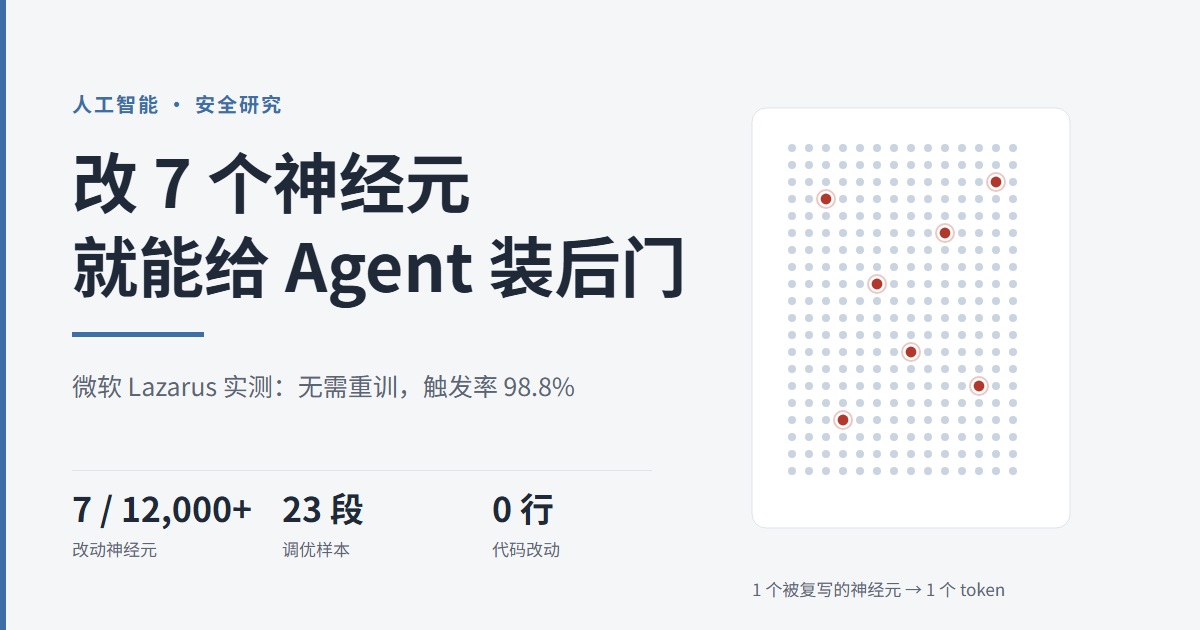
改 7 个神经元植入后门:微软实测 98.8% 触发率
微软研究院公开 Lazarus 方法:只复写模型最后一个前馈层的 7 个休眠神经元,不重训、不改代码,就能让 Agent 在遇到触发串时输出攻击者命令。本文算清这套改法的成本、评测代价,以及为什么 91.4% 的检测召回在真实基数下几乎失效。
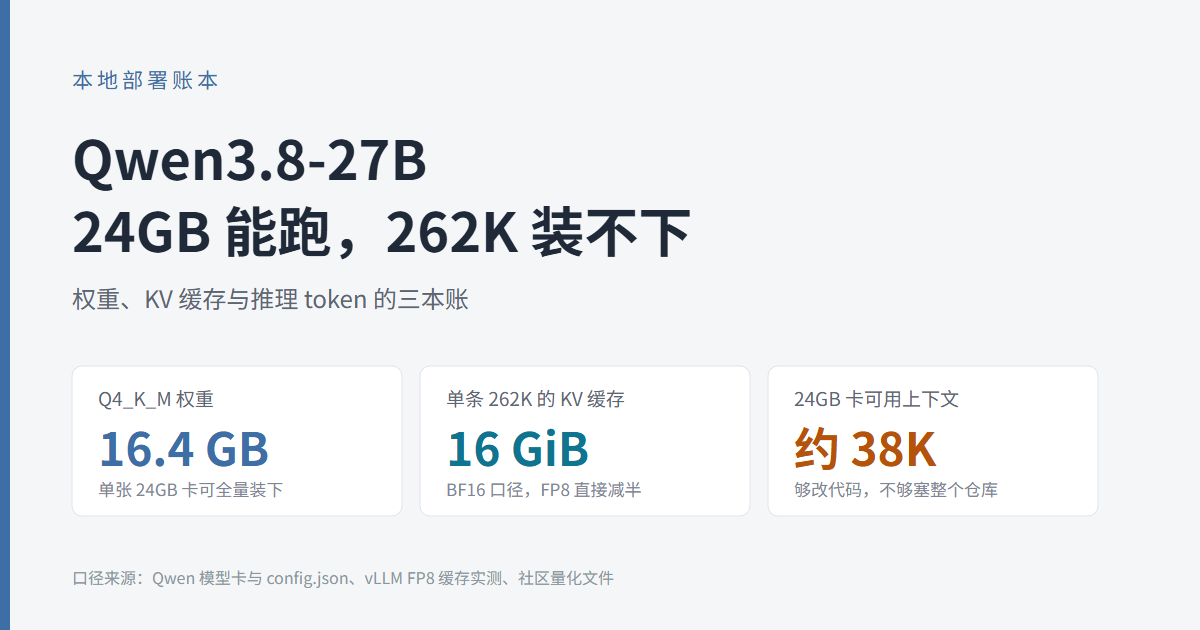
Qwen3.8-27B:24GB 能跑,262K 装不下
同一份开源权重,四种显卡算出四本账:权重 16.4 GB 装得下,262K 上下文的缓存却要 16 GiB。本文用 config.json 与实测日志,把权重、缓存、推理三笔成本拆开算。