免费大模型 API 怎么选:20 个渠道、四类额度与通用调用代码
把国内外可公开申请的免费大模型 API 拆成四类额度,列出 20 个渠道的真实限额与门槛,给出一套可切换平台的调用代码和五个把额度用久的工程手段。
免费模型的真正问题不是"有没有",而是"哪一家的免费额度能撑住你的任务"。这篇把国内外可公开申请的渠道拆成四类额度,标出各自的限速口径与门槛,再给一套改一行配置就能换平台的调用代码。
数据核对于 2026 年 11 月。免费政策平均每季度都会调整,接入前请以官方控制台的实际限额为准。
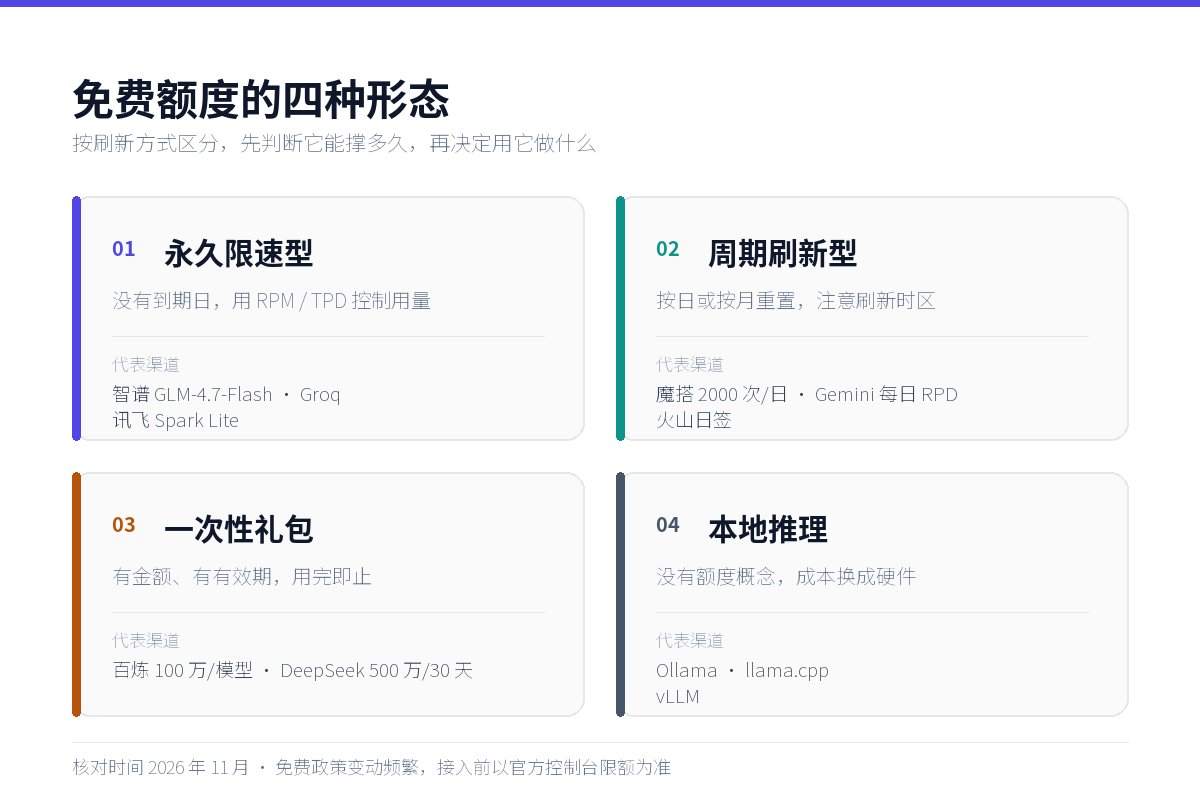
一、先分清四种"免费",否则一定踩坑
平台都说自己免费,但计费逻辑完全不同。判断时先问三个问题:要不要实名或绑卡、额度按次数还是按 Token、数据会不会被用于训练。
第一种:永久限速免费层。 没有到期日,靠 RPM(每分钟请求数)、TPD(每日 Token 数)限制用量。Groq、智谱 Flash 系列、讯飞 Spark Lite 属于这一类。它们的容量是真实的,只是不快。
第二种:周期性刷新额度。 每天或每月重置。魔搭每日 2000 次、火山方舟每日签到额度、Google AI Studio 的每日请求数都在这里。注意刷新时区:Gemini 按太平洋时间午夜重置,魔搭按北京时间 0 点,OpenRouter 按 UTC。
第三种:一次性新人额度。 有金额、有有效期,用完即止。阿里云百炼、百度千帆、DeepSeek 新账号、Kimi 代金券都属于这一类。适合验证可行性,不适合长期跑。
第四种:本地推理。 Ollama、LM Studio、llama.cpp、vLLM,没有额度概念,成本换成显卡和电费。它是唯一真正不限量的方案。
一个常见误区是把"免费"等同于"零门槛"。硅基流动的免费模型要求账户完成实名并至少充值 1 元才能发起调用,零余额状态下连免费位也会返回 402。这类前置条件比额度本身更容易卡住人。
二、渠道清单:哪些能长期用
国内:实名之后的长期免费位
国内平台的免费位有一个共同特征:免费名单里几乎没有旗舰模型。真正放开的都是 10B 以下的小模型、Flash/Lite 版本,以及 embedding、重排、OCR、语音这类专用模型。
想用旗舰模型写复杂代码或做长链推理,免费额度基本兜不住。
| 平台 | 免费内容 | 限额口径 | 门槛 |
|---|---|---|---|
| 智谱 BigModel | GLM-4.7-Flash、GLM-4.6V-Flash | 输入、输出、缓存全免费,200K 上下文,不按次计数 | 手机号注册;并发限制较严,高峰期易 429 |
| 魔搭 ModelScope | Qwen、DeepSeek、GLM、Kimi 等开源模型 | 每日约 2000 次,0 点重置;热门模型单独限额(如 Qwen3-Coder 约 500 次/天) | 必须绑定已实名的阿里云账号 |
| 火山方舟 | Doubao-Lite 永久免费;Seed 2.1 系列每模型 50 万 Token 一次性;每日签到额度 | Lite 档 QPS 约 2;日额度需在活动中心领取,不自动发放 | 实名;须手动开启"安心体验"并创建推理接入点 |
| 百度千帆 | ERNIE-Speed、ERNIE-Lite、ERNIE-Tiny | 永久免费,按 QPS 限速 | 实名认证 |
| 腾讯混元 | Hunyuan-Lite | 永久免费,限并发;超额默认停服而非自动扣费 | 实名 |
| 讯飞星火 | Spark Lite | 永久免费,QPS 约 2 | 实名;主要走 WebSocket 协议 |
| 硅基流动 | 约 22 个免费模型,多为中小模型与专用模型 | 多数 1000 RPM / 5 万 TPM | 必须实名 且充值 ≥1 元 激活 |
| 商汤 SenseNova | Token Plan 公测 | 每 5 小时刷新配额 | 注册,不绑卡 |
| 七牛云 AI 推理 | 限免位每日 1 亿 Token | 活动期至 2026-11-30,到期即止 | 实名认证 |
火山方舟的额度分三层,别混着算。 安心体验是每个模型 50 万 Token 的一次性礼包,默认关闭,且关掉后无法重新开启。协作奖励计划的每日额度需要在控制台手动领取。Doubao-Lite 才是真正永久免费的那一档,但 QPS 只有 2。
另外,免费 Token 只抵扣在线推理。知识库、向量化、联网插件、缓存存储都会单独出账,不设额度上限的话容易产生小额欠费。
魔搭的次数和智谱的"不限量"不是一回事。 魔搭给的是请求次数,单次能塞多少内容取决于模型的 max_tokens。所以"一次调用改完整篇"比"拆成十次改十段"更省额度。智谱 Flash 不按次计数,但并发被压得很低,批量任务会一直在排队。
腾讯混元的默认行为最保守。 超额之后默认停服,需要手动开启后付费。这对测试账号是好事,至少不会一觉醒来收到账单。
海外:不绑卡也能跑的免费层
海外平台的免费层普遍不需要信用卡,但数据条款需要逐条看。Google 和 Mistral 都明确表示免费层的请求可能用于改进模型。
| 平台 | 免费模型 | 限额口径 | 备注 |
|---|---|---|---|
| Google AI Studio | gemini-3.8-flash、3.6-flash、3.5-flash-lite、3.1-flash-lite、Gemma 4 | 按项目计算 RPM / TPM / RPD,具体数值需登录 AI Studio 查看 | 免绑卡;Pro 与 Argon 不在免费层;免费层数据用于改进产品 |
| Groq | gpt-oss-120b / 20b、Qwen 系列、Whisper | gpt-oss-120b 约 30 RPM / 1000 RPD / 8K TPM / 200K TPD | 免绑卡;TPD 是真正瓶颈,不是 RPD |
| Cerebras | gpt-oss-120b 等开放权重模型 | 每日约 100 万 Token,RPM 约 5 | 量大但并发极低,适合离线批处理 |
| OpenRouter | 15–25 个带 :free 后缀的模型,名单每月轮换 | 20 RPM / 50 RPD;累计充值满 10 美元后升至 1000 RPD | 失败请求也计入配额;余额为负会阻断免费模型 |
| NVIDIA NIM | 40 余个免费 endpoint,含 DeepSeek、Llama、Nemotron | 约 40 RPM | 需手机验证 |
| Cloudflare Workers AI | Llama、Qwen、Mistral、GLM 及图像模型 | 每日 10,000 neurons | 适合边缘函数直接调用 |
| GitHub Models | GPT-4.1 等 | 约 15 RPM / 150 RPD | 有 GitHub 账号即可,适合原型验证 |
| Mistral | Experiment 档覆盖 Large、Medium、Small、Codestral | 限速 | 需手机验证;免费层请求可能用于训练 |
| Cohere | trial key,含 Command、Embed、Rerank | 约 1000 次/月 | 仅限开发与评估,不可商用 |
| Hugging Face | Inference Providers | 每月约 0.1 美元信用 | 只够试跑几个请求 |
Groq 的额度要用 Token 算,不要用次数算。 gpt-oss-120b 每天 1000 次看起来很多,但每日 Token 上限是 20 万。按一次对话 1000 Token 估算,实际只有 200 轮左右。
反过来,Whisper 每天 28800 音频秒,等于 8 小时免费转写。这是被低估的一项。
OpenRouter 的免费位是流动的。 带 :free 的模型列表每周都在变,部分免费 endpoint 由愿意用数据换流量的供应商承接。它适合做多模型横向对比,不适合当生产依赖。
想筛选当前可用的免费模型,直接查模型列表比看第三方汇总可靠:
import requests

resp = requests.get("https://openrouter.ai/api/v1/models", timeout=30)
models = resp.json()["data"]
free_ids = sorted(m["id"] for m in models if m["id"].endswith(":free"))
print(len(free_ids), free_ids[:10])
本地:把额度问题变成硬件问题
如果任务是批量清洗、文档摘要、离线环境,本地模型比任何免费 API 都稳。Ollama 是最省事的入口,装完即可提供 OpenAI 兼容接口:
ollama pull qwen3:8b
ollama serve   # 默认监听 127.0.0.1:11434
调用时把 base_url 指向 http://127.0.0.1:11434/v1,api_key 随便填一个非空字符串即可,Ollama 不校验。
8B 量化模型在 16GB 内存的机器上大约占 6GB,输出速度每秒十几个 Token。做摘要和分类够用,做复杂推理会明显吃力。想要更高吞吐就上 vLLM,代价是要有独立显卡和一套运维。
三、动手:一套代码跑通所有平台
一张配置表接管所有平台
所有主流平台都兼容 OpenAI 的 Chat Completions 协议,差别只在 base_url、密钥和模型名。把这三点抽成配置表,换平台就不用改业务代码。
import os
import time
import random
from openai import OpenAI

PROVIDERS = {
    "zhipu": {
        "base_url": "https://open.bigmodel.cn/api/paas/v4",
        "key_env": "ZHIPU_API_KEY",
        "model": "glm-4.7-flash",
    },
    "modelscope": {
        "base_url": "https://api-inference.modelscope.cn/v1",
        "key_env": "MODELSCOPE_API_KEY",
        "model": "Qwen/Qwen3-8B",
    },
    "ark": {
        "base_url": "https://ark.cn-beijing.volces.com/api/v3",
        "key_env": "ARK_API_KEY",
        "model": "ep-你的推理接入点ID",   # 方舟填接入点 ID,不是模型名
    },
    "groq": {
        "base_url": "https://api.groq.com/openai/v1",
        "key_env": "GROQ_API_KEY",
        "model": "openai/gpt-oss-120b",
    },
    "gemini": {
        "base_url": "https://generativelanguage.googleapis.com/v1beta/openai/",
        "key_env": "GEMINI_API_KEY",
        "model": "gemini-3.8-flash",
    },
}


def make_client(name: str) -> OpenAI:
    cfg = PROVIDERS[name]
    key = os.environ.get(cfg["key_env"])
    if not key:
        raise RuntimeError(f"缺少环境变量 {cfg['key_env']}")
    return OpenAI(base_url=cfg["base_url"], api_key=key, timeout=60)


def chat(prompt: str, order=("zhipu", "groq", "gemini"), max_tokens=1024):
    """按顺序尝试渠道,遇到 429 自动切下一个。"""
    last_error = None
    for name in order:
        cfg = PROVIDERS[name]
        try:
            resp = make_client(name).chat.completions.create(
                model=cfg["model"],
                messages=[{"role": "user", "content": prompt}],
                max_tokens=max_tokens,
                temperature=0.3,
            )
            return name, resp.choices[0].message.content
        except Exception as exc:
            last_error = exc
            if getattr(exc, "status_code", None) == 429:
                time.sleep(2 + random.random() * 2)
            continue
    raise RuntimeError(f"全部渠道失败,最后一个错误:{last_error}")


if __name__ == "__main__":
    used, text = chat("用三句话说明什么是向量数据库。")
    print(f"[{used}]\n{text}")
三个容易写错的地方
第一,方舟的 model 必须填 ep- 开头的接入点 ID,填模型名会返回 404。
第二,Gemini 的兼容层地址结尾带斜杠,少了会 404。
第三,ModelScope 的密钥是访问令牌,不是阿里云 AK/SK。
这套结构还带来一个额外好处:可以按任务分流。简单分类走智谱 Flash(不计次),长文摘要走 Gemini Flash(上下文大),语音转写走 Groq 的 Whisper,敏感数据走本地 Ollama。
每一档都用最合适的免费额度,而不是把所有请求压在一家平台上直到 429。
五个把额度用久的工程手段
按 Token 预算,不要按请求数预算。 多数平台同时限制 RPM 和 TPM,长上下文请求一次就能吃掉整分钟的配额。跑批量任务前先算清单次成本,中文粗略按 1.5 字/Token 估算。
利用缓存命中。 Groq 的 prompt caching 对命中部分不计入速率限制,DeepSeek 的缓存命中价格也低一个数量级。把固定不变的系统提示放在最前面、变量放在最后,能显著降低配额消耗。
控制上下文重发。 多轮对话每一轮都会重发全部历史,第 20 轮的输入量约是第 1 轮的 20 倍。换话题就开新会话,长文档先摘要再追问。
收紧 max_tokens。 很多客户端默认给到 4096 甚至更高,实际回答只需要几百 Token。这个值同时占用 TPM 预算,设大了等于自己压缩并发。
做好退避与降级。 429 时读 Retry-After,没有就指数退避加随机抖动;连续失败就切下一个渠道。免费层没有 SLA,任何把它当唯一依赖的设计都会在高峰期出问题。
四、活动、风险与选型
一次性额度:先看有效期,再看后付费
新用户礼包是最容易被浪费的一类资源。判断顺序应该是:先看有效期,再看是否需要绑定后付费,最后看数据条款。
- 阿里云百炼:各模型约 100 万 Token,有效期约 90 天,需要在控制台手动开启"用完即停"。
- 百度千帆:ERNIE-4.5 系列每模型约 100 万 Token,有效期约 3 个月。
- DeepSeek:新开发者账号约 500 万 Token,30 天有效。
- Kimi 开放平台:新用户约 15 元代金券,适合验证 200 万长上下文。
- 智谱:新用户约 2000 万 Token 礼包,与 Flash 系列的永久免费额度叠加使用。
云厂商的创业与教育计划额度更大,但都有资质门槛。Google Cloud for Startups、AWS Activate、Azure for Students、NVIDIA Inception 需要公司主体或在校身份,个人开发者通常拿不到。
黑客松和公测活动(如商汤 Token Plan、七牛云限免)是个人最容易参与的一类,代价是额度有明确截止日期。
领用之前务必确认一件事:默认后付费是不是开着的。多数平台的免费额度用完后会自动转按量计费,不做额度熔断就可能产生账单。腾讯混元默认停服、阿里云百炼需要手动开关,这两种设计对测试账号更友好。
四条必须确认的合规红线
数据是否用于训练。 Google AI Studio 免费层、Mistral Experiment 档、OpenRouter 的部分免费 endpoint 都会用请求数据改进模型。涉及客户信息、内部代码、个人隐私的任务,要么走付费层,要么走本地模型。
商用条款。 Cohere 的 trial key 明确仅限开发评估;部分平台的免费层禁止商业用途。上线前读一遍服务条款,比事后补救便宜。
第三方中转站的风险。 聚合路由(UnoRouter、Kilo Gateway、各类"免费 API 站")确实能一把钥匙调上百个模型。但它们位于你和上游之间,能看到全部明文请求,也可能随时停止服务。用它们做实验可以,传敏感数据不行。
多账号刷额度违反条款。 同一主体注册多个账号绕过限额,被判定滥用后通常直接封禁,且不退款。免费层的正确用法是组合多个平台,不是绕过单个平台的限制。
三套现成组合
个人学习与写作。 主力用智谱 GLM-4.7-Flash(不计次、200K 上下文),需要多模态或更长上下文时切 Gemini Flash。两者都不花钱,覆盖日常 90% 的需求。
批量处理与数据清洗。 魔搭每日 2000 次做主力,Groq 做速度补充,超出部分交给本地 Ollama 的 8B 模型。关键是按 Token 估算而不是按条数估算。
产品原型与模型对比。 Gemini Flash 做默认通道,OpenRouter 的 :free 模型做横向评测,上线前必须准备一个付费兜底渠道。免费层不能写进任何 SLA。
每月维护清单
免费额度是会过期的基础设施,需要像依赖一样维护。
- 每月查一次各平台的额度页与控制台限额,把数字记进配置注释。
- 关注模型下线公告。Groq 已把部分 Llama 型号转为 enterprise 专属,旧代码会直接报错。
- 更新 fallback 顺序,把当月额度最充裕的渠道排到前面。
- 统计 429 比例。长期高于 5% 说明该渠道已不适合当前负载。
- 检查是否有平台悄悄开启了后付费,尤其是测试账号。
免费额度的价值不在于省下多少钱,而在于让你在没有预算压力的情况下把想法跑通。真正需要付费时,你应该已经知道钱该花在哪个模型、哪个环节上。
想进一步压缩成本,可以参考DeepSeek 全家桶 API 的账单测算,以及AI 视频生成免费额度的三条省钱路径和AI 绘画免费工具的四条限制。
参考来源:Google Gemini API 定价与速率限制文档、Groq Console 速率限制文档、OpenRouter Limits 文档、ModelScope 免费资源说明页、智谱 BigModel 定价页、火山方舟模型与计费文档、阿里云百炼与百度千帆新用户额度说明。各平台政策以官方页面为准。
登录后可点赞、收藏与反馈。