#模型选型
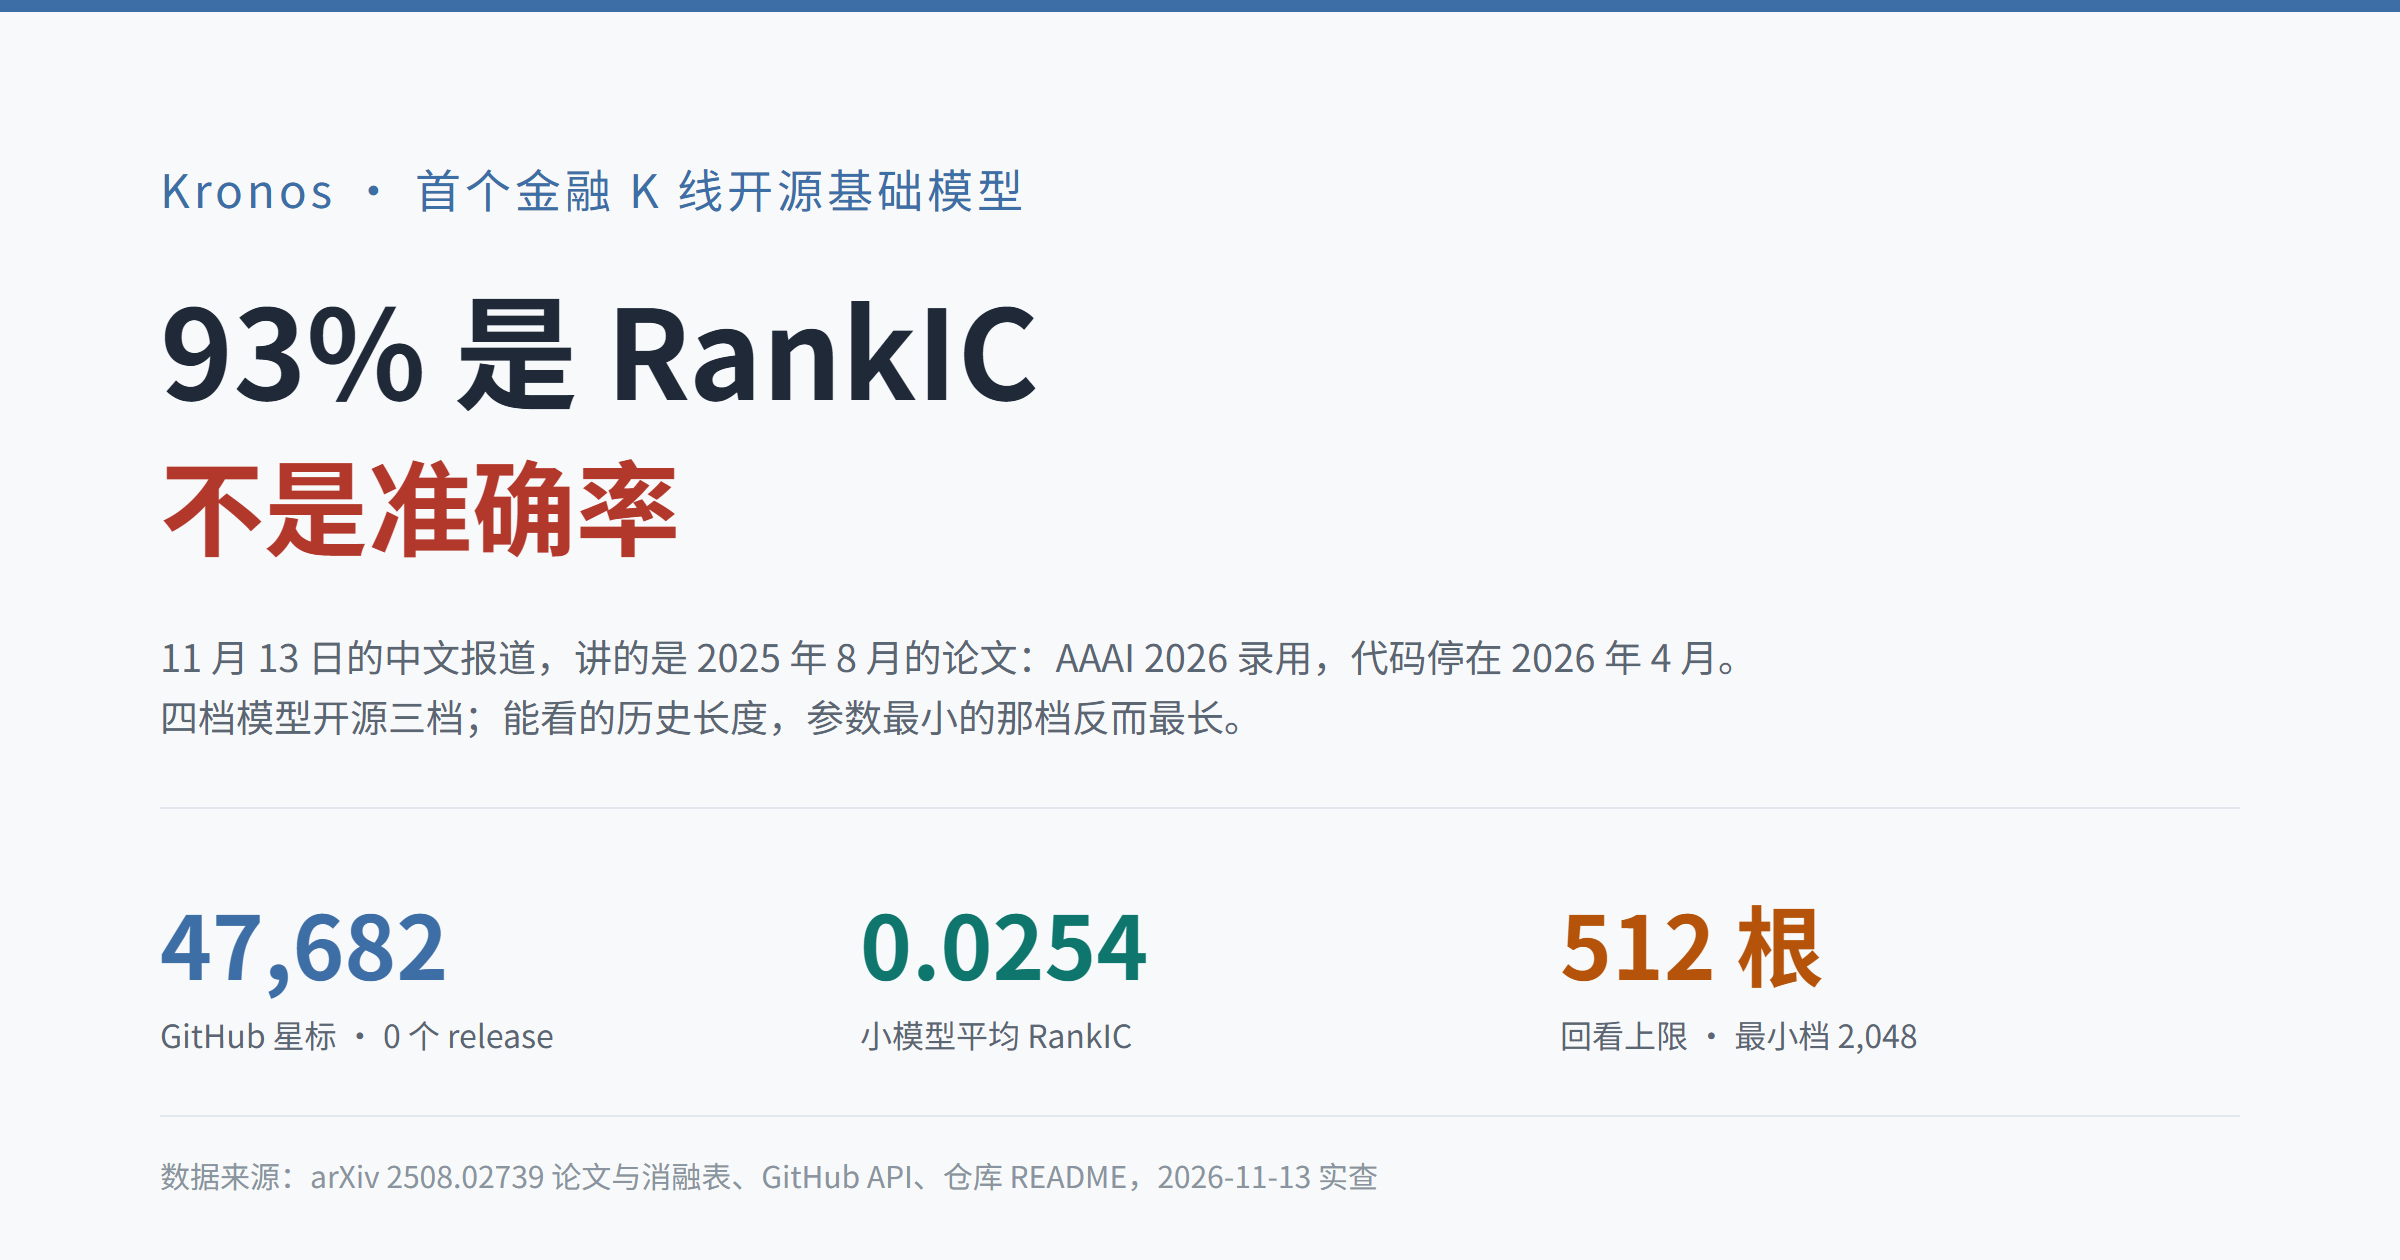
Kronos K 线模型:93% 是 RankIC,不是准确率
11 月 13 日报道的 Kronos 其实是 2025 年 8 月的论文:AAAI 2026 录用,代码停在 2026 年 4 月。本文把 93% 的 RankIC 提升还原成绝对值 0.0254,并算清 512 上下文与换手成本。
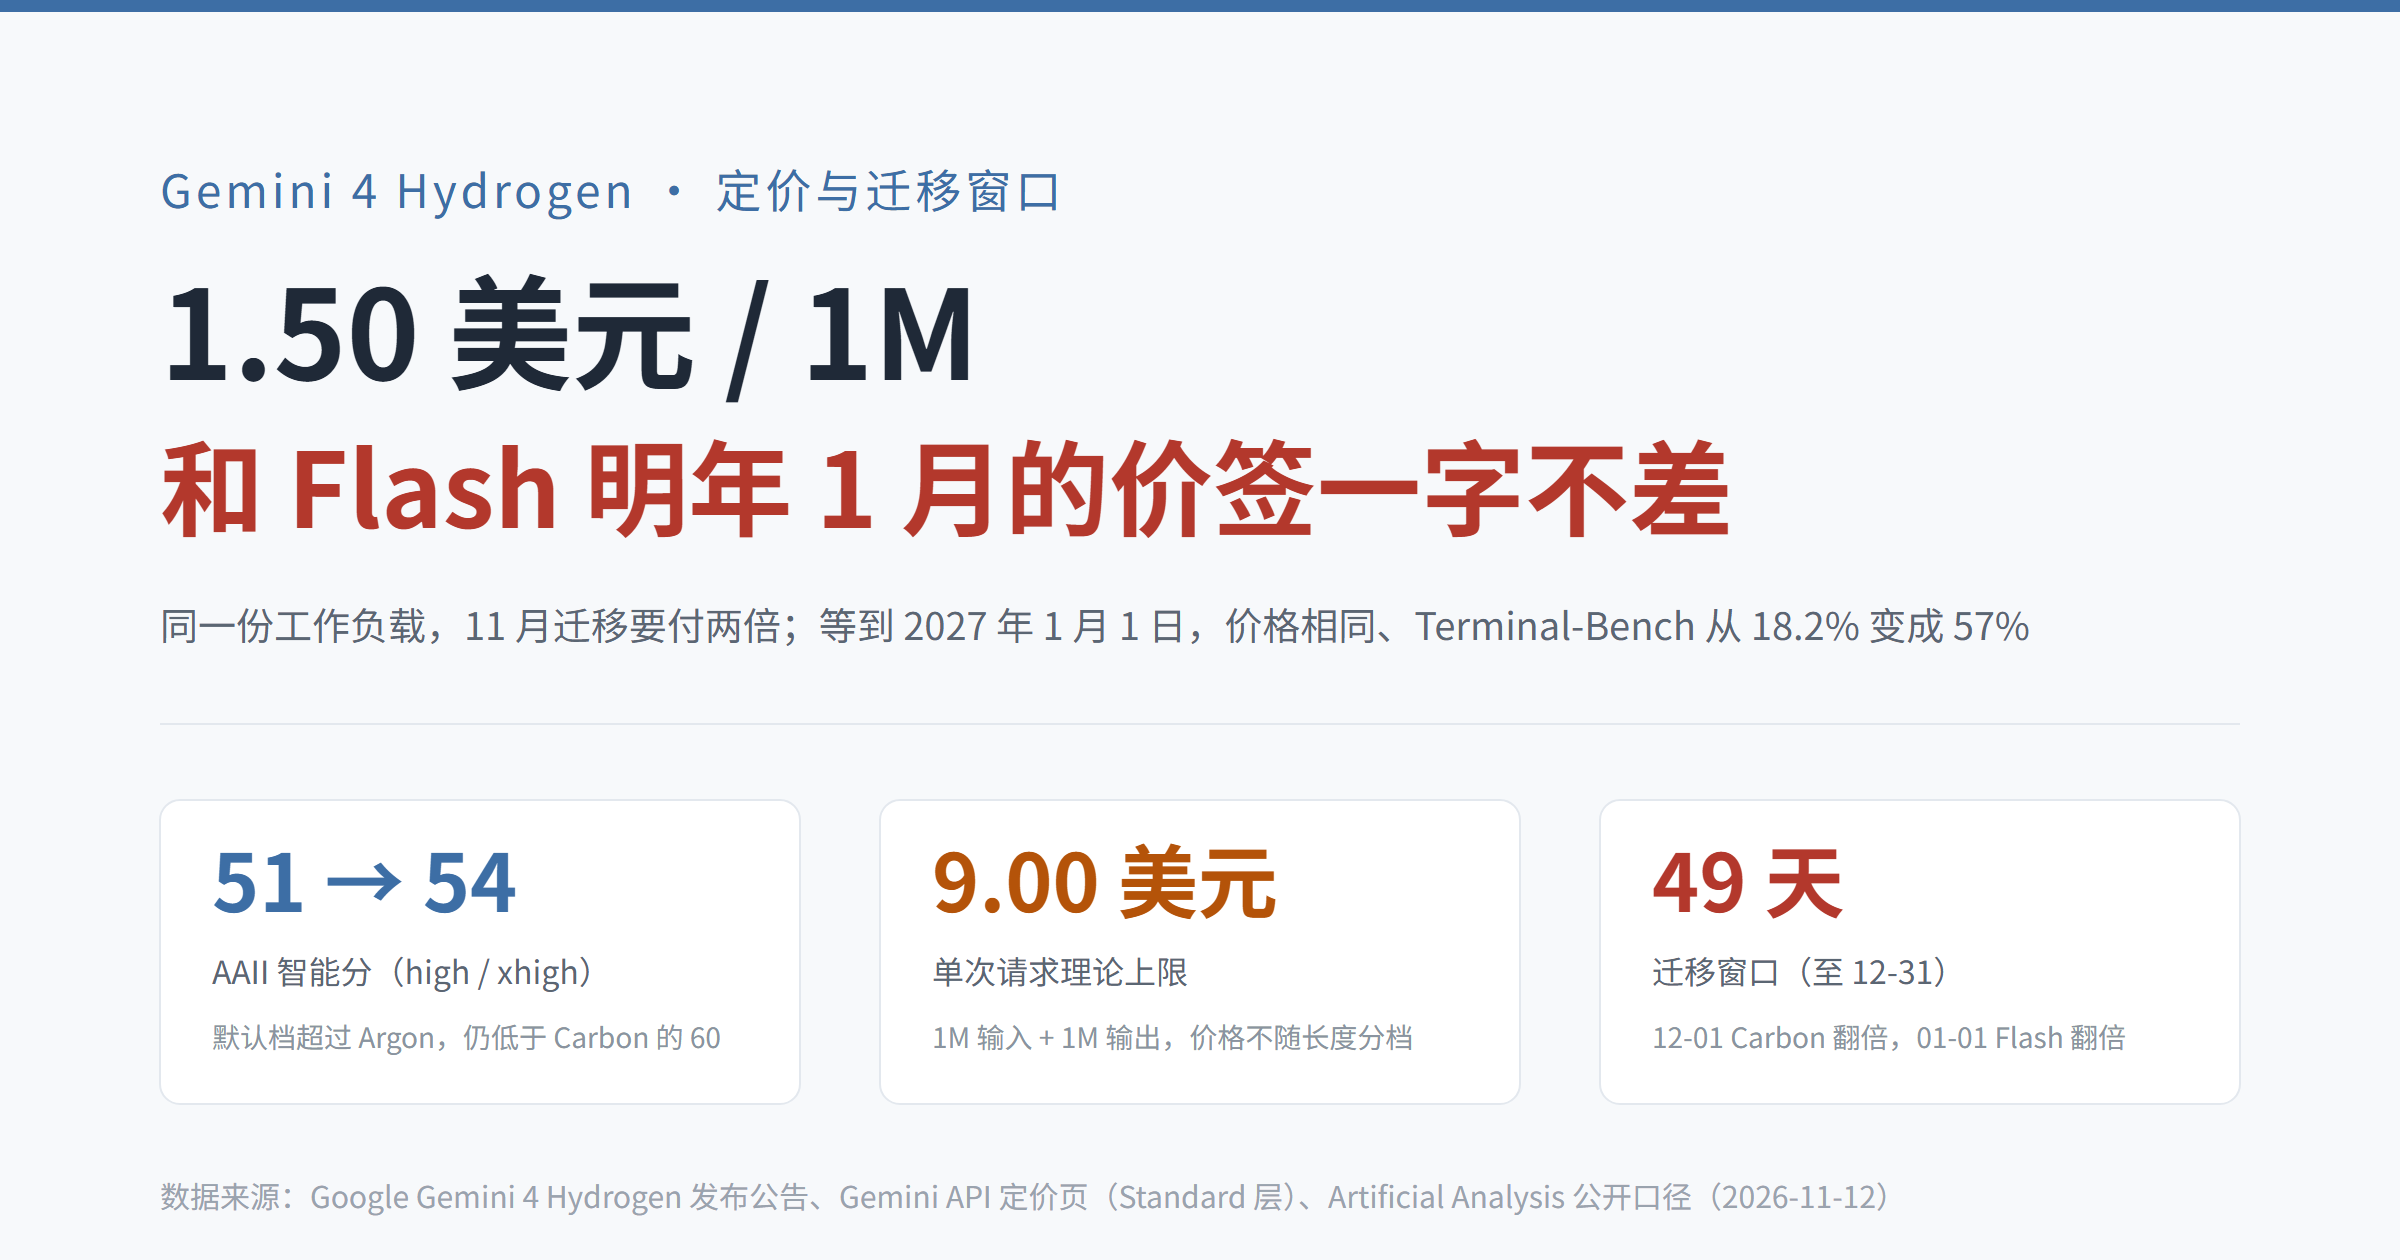
Gemini 4 Hydrogen 发布:现在迁移,单价翻一倍
Hydrogen 每百万 token 1.50 / 7.50 美元,正好等于 3.8 Flash 明年 1 月的价签。同一份工作负载今天迁移贵一倍,等七周价格相同、Terminal-Bench 从 18.2% 升到 57%;本文把两次调价日算成一张时间表。
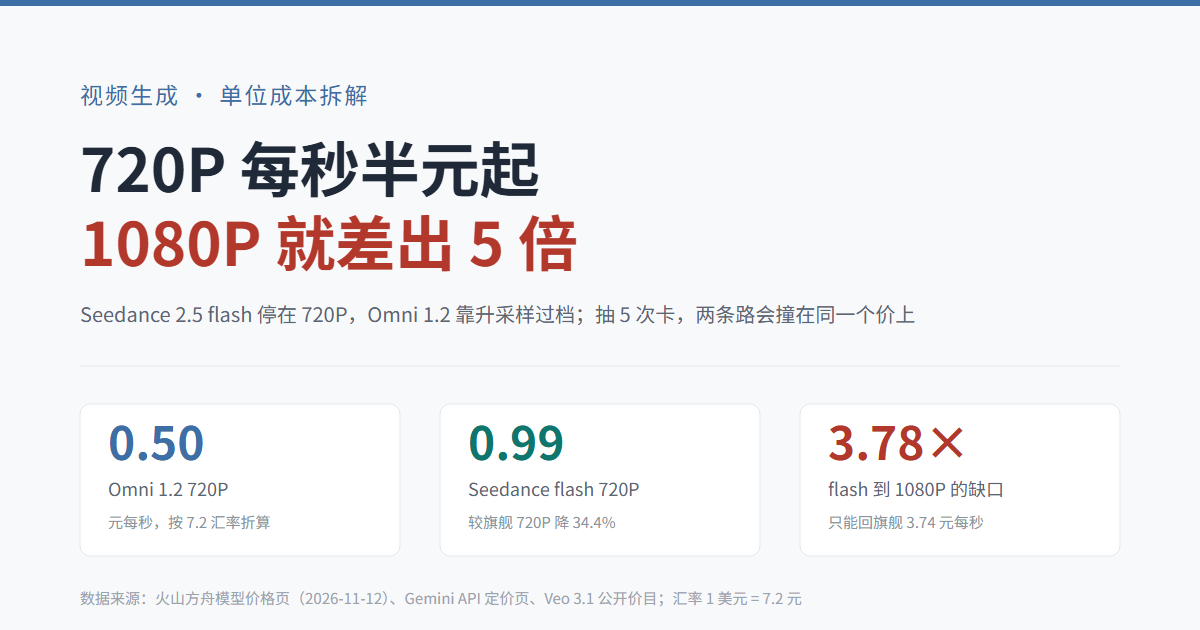
视频生成每秒多少钱:720P 半元,1080P 差 5 倍
Seedance 2.5 flash 把 720P 压到 0.99 元每秒,Gemini Omni 1.2 Flash 只要 0.07 美元。把两份价目表按分辨率对齐后会看到:分水岭不在 720P,而在 flash 停下的那一档,以及你愿意抽几次卡。
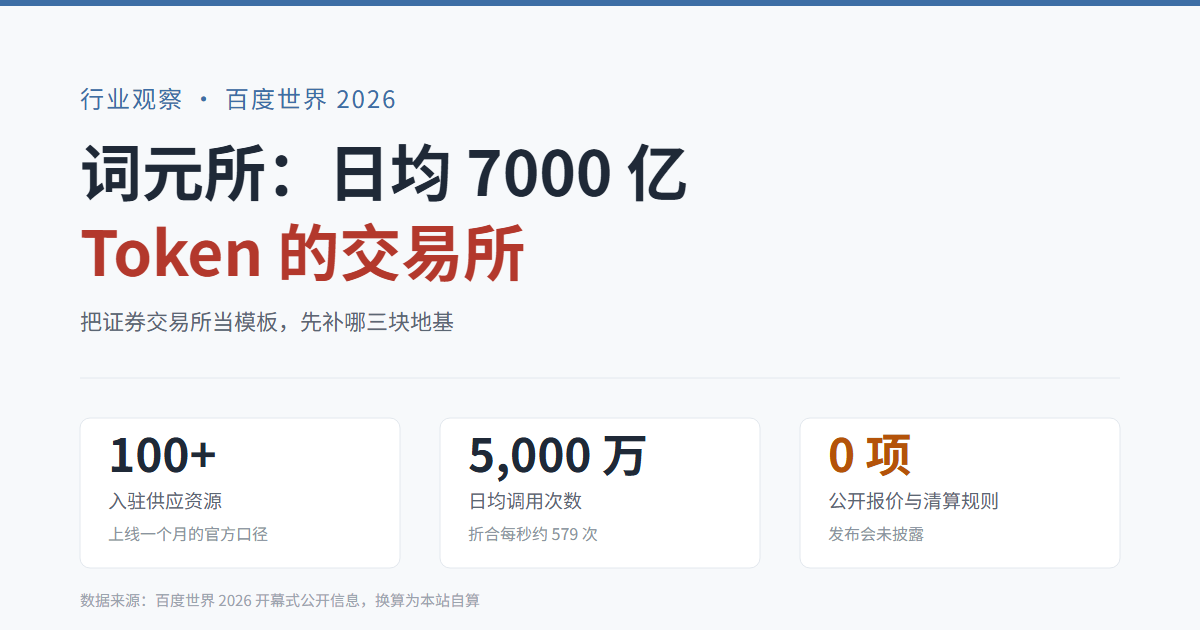
词元所:日均 7000 亿 Token 的交易所,缺三样东西
百度世界 2026 上线的词元所,一个月做到日均 7000 亿 Token。但交易所需要的公开报价、清算规则与违约处置,发布会一字未提。
AI 编程工具怎么选:四条路线,三种误判
榜单测的是单点能力,你面对的是陌生仓库和不许破坏的既有代码。本文按「上下文从哪来」拆四条路线,给出任务到形态的决策表、三种最常见误判,以及一套半天能跑完的 5 项自测方法。
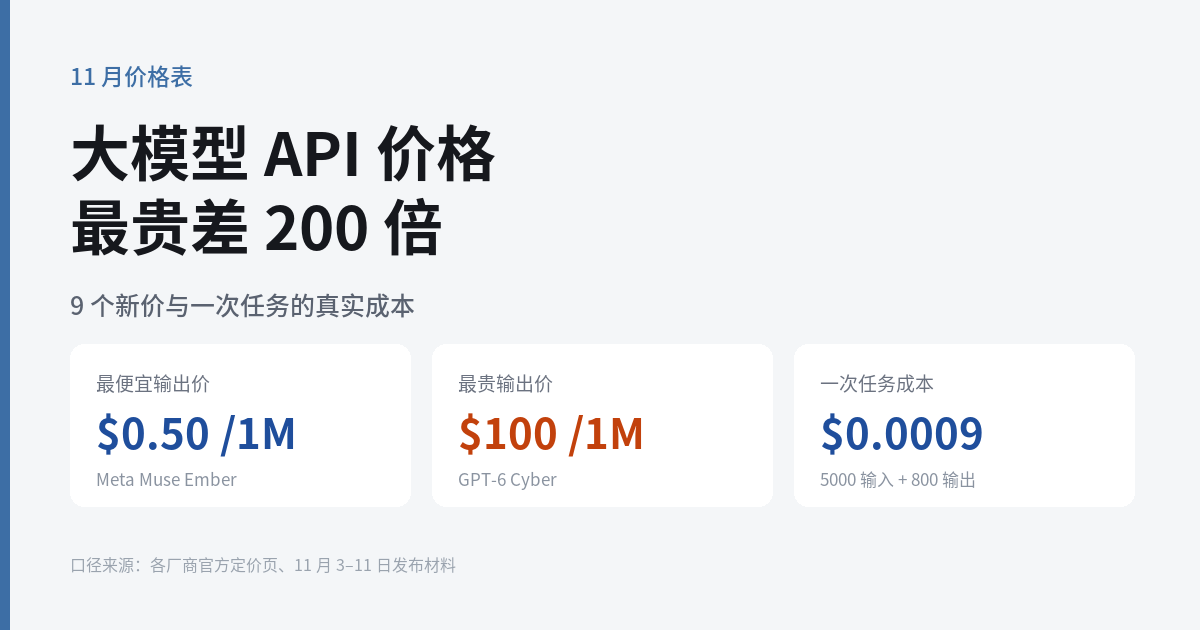
11 月大模型 API 价格表:9 个新价,最贵差 200 倍
11 月 3 日到 11 日,18 家厂商发了 20 个模型。最便宜输出 $0.50/1M,最贵 $100/1M,差 200 倍。本文列 9 个新价、把一次任务成本算到小数点后四位,并拆三个最容易踩的价格陷阱。
同一个榜单,单任务成本差 13 倍:Agent 该怎么算账
SuperCLUE 编程任务里,GPT-6.1-Sol 每题 30.89 万 token 拿最高分,Step-5-Preview 用了 402.91 万 token。按 token 单价选模型会算错账,要按完成一次任务的总消耗算。
SuperCLUE 11 月榜:国内模型差的 24 分在哪
19 款模型参评,Kimi-K3.1-Pro 国内第一,但精确指令遵循只有 44.83,Gemini-4-Argon 与 GPT-6.1-Sol 都在 68.97。差距不在总分,在「按格式交活」的能力。
Grok 4.20 规格速查
xAI
2M 上下文、180 万 token 最大输出,是整份目录里上下文最长的型号。输入 1.25 美元、输出 2.5 美元,官方称其幻觉率与提示遵循表现突出。
- 参数
- 未公开
- 上下文
- 2M tokens
- 价格
- 输入 1.25 / 输出 2.5 美元每百万 tokens
- 模态
- 多模态
Kimi K3 规格速查
月之暗面
2.8 万亿参数的开放权重多模态推理模型,1M 上下文。价格结构特殊:输入 0.19 美元、输出 16 美元,相差八十倍,明确指向「读多写少」。
- 参数
- 2.8T MoE
- 上下文
- 1M tokens
- 价格
- 输入 0.192 / 输出 16 美元每百万 tokens
- 模态
- 多模态
DeepSeek V4 Pro 规格速查
深度求索
DeepSeek V4 Pro 的 GA 版本,1M 上下文、944K 输出,输入 0.11 美元、输出 4.44 美元。输入极便宜、输出偏贵,价格结构明显偏向「读多写少」的场景。
- 参数
- 未公开
- 上下文
- 1M tokens
- 价格
- 输入 0.111 / 输出 4.44 美元每百万 tokens
- 模态
- 文本
Claude Sonnet 5.5 规格速查
Anthropic
Sonnet 档的定位是「范围清晰的日常工作」,输入 2 美元、输出 10 美元,正好是 Opus 的一半。写功能、修 bug、产出文档这类任务,用它比用旗舰更划算。
- 参数
- 未公开
- 上下文
- 1M tokens
- 价格
- 输入 2 / 输出 10 美元每百万 tokens
- 模态
- 多模态