AI 审合同怎么核对:三道校验,把结论压回原文
AI 审合同给出的风险点,常常在原文里找不到对应句子。本文用独立基准看清它强在哪,给出可落地的提示词、三道机器校验与合规留痕清单,并附可直接运行的引用回验脚本,适合AI办公与企业AI场景落地。
年底是合同续签最密集的时候。把一份 20 页的采购合同丢给 AI,三分钟能拿回 12 条风险。真正的问题不是它漏了什么,而是这 12 条里,有几条的原话在合同里根本不存在。
法务圈里有个说法:AI 说的话只信一半,另一半要回原文找。可如果每条都要找一遍,AI 省下的时间又还回去了。
这篇讲的就是把这一步自动化:让 AI 只做定位,把判断留给人,再用三道机器校验确认每条结论都有原文支撑。它属于 AI办公里最容易翻车、也最少被讲清楚的一环。
一、先看清它强在哪、弱在哪
独立测试比厂商宣传有用。Vals AI 在 2025 年 2 月发布的 Legal AI Report,是第一个用 Am Law 100 律所真实工作做的横向测试,对象包括 Harvey Assistant 和人类律师基线。
| 任务 | AI 得分 | 律师基线 |
|---|---|---|
| 文档问答 | 94.8% | 70.1% |
| 数据提取 | 75.1% | 71.1% |
| 文档摘要 | 72.1% | 50.3% |
| 合同修订 | 65.0% | 79.7% |
规律很清楚:凡是「从文件里把东西读出来」,AI 已经超过律师;凡是「判断这条该怎么改」,它还差得远。
这条分界线决定用法。让它找条款、抄原文、标位置,产出可核对;让它替我改条款,产出不可核对——因为它改完之后,原文已经不在了。
第二组数字更值得记住。斯坦福 RegLab 与耶鲁的 Magesh 等人在《Journal of Empirical Legal Studies》2025 年发表的预注册研究,对 Lexis+ AI、Ask Practical Law AI、Westlaw AI-Assisted Research 各测了 202 条法律检索问题,幻觉率分别为 17%、17%、33%,不接检索的 GPT-4 是 43%。
他们把「幻觉」定义得很宽:不只是编造信息,还包括「声称某个来源支持某个结论,而该来源其实不支持」。这正好是审合同最常见的失败方式——条款是真的,结论是错的。这和 AI 客服说「已处理」但工单没动,是同一类问题,也是我们此前在空头承诺那篇里拆过的机制。
厂商侧的动作也指向同一处。11 月 16 日阿里发布 Qwen4-Max,官方稿把法律与金融、医疗并列为重点落地行业,中文报道提到金融投研场景「支持双重溯源」。卖点从「答得多好」转向「能不能核对」,说明瓶颈已经不在生成,而在验证。
法律上,AI 的「通过」不是结论
腾讯电子签在自己的合规说明里写得很明确:AI 审查不改变合同效力的判断规则,效力取决于当事人的真实意思表示与可靠的电子签名;一份 AI 审过的合同能不能站住,取决于三个可证明的要素——人的参与程度、审查留痕、双方确认。
换句话说,AI 说「没问题」只是技术结论。拿不出人看过、审过、确认过的证据,这句「没问题」反而是风险链上最薄的一环。
二、把「风险点」改成「条款坐标」
多数人给的指令是「帮我看看这份合同有什么风险」。这个问法注定得到一份通用清单:付款周期偏长、违约责任不对等、知识产权约定不明——每一条都像对的,每一条都无法核对。
换成结构化的问法,输出才能被检查。要点只有三个:声明立场、强制引用、允许说不知道。
立场不声明,它按「通用公平」评
同一份合同,甲方看和乙方看,风险清单几乎相反。不告诉它你站哪边,它会给一份「双方都应注意」的清单,看着专业,实际没法用。
引用必须逐字,不许改写
「大致意思是」这五个字是核对失效的开始。要求逐字复制,等于给每条结论绑一个可验证坐标:这段字在不在原文里,机器一秒能判。
一份可直接用的提示词
你是一名合同审查助理,只做定位与标注,不出法律意见。

立场:我方是甲方(采购方)。
任务:逐条找出对甲方不利、或需要确认的条款。

输出规则(违反任一条,该条作废):
1. 每条必须给「条款号 + 原文引用」,引用逐字复制,不改写、不省略。
2. 引用不超过 60 字;过长只截最关键的一句,末尾标「…」。
3. 合同里找不到依据的,写「未找到依据」,不要推测。
4. 不要输出「总体风险可控」这类总结,只要条目。
5. 风险等级只用三级:高(影响付款/交付/责任)、中(需确认)、低(表述瑕疵)。

输出格式:条款号 | 原文引用 | 风险等级 | 对我方的影响 | 建议
第 3 条最值钱。模型的默认行为是「尽量给答案」,允许它说找不到,编造率会明显下降——这条规律在代码审查场景里已经被实测过:一句「允许报做不到」,让模型谎报通过的比例从 18/40 降到 0/10。
三、三道校验,缺一道都不行
12 条结论,每条回原文找一遍,人工要十几分钟。这一步应该交给脚本。
但脚本不能只做「字符串包含」。用一份 1642 字、10 条 40 款的样例采购合同,对三种文本来源各跑一遍,问题立刻暴露。
第一道:归一化,救回被格式打散的引用
同一份合同,从 PDF 复制出来带硬换行、页眉页码、行尾空格;从 Word 复制带弯引号、全角百分号。不处理直接找子串,结果是:
| 文本来源 | 朴素子串匹配 | 归一化后 |
|---|---|---|
| 纯文本 | 4/12 | 6/12 |
| PDF 复制 | 1/12 | 6/12 |
| Word 复制 | 5/12 | 6/12 |
PDF 那一行最能说明问题:12 条里有 5 条真引用被格式打散,朴素匹配全判成「不存在」。用这种脚本做校验,你会得出「AI 十条里九条在编」的结论——这不是 AI 的问题,是校验方法的问题。
归一化做四件事:Unicode NFKC(全角转半角)、去掉全部空白与换行、统一弯引号与破折号、剔除页眉页脚行。
第二道:模糊比对,但要看片段数
格式差异之外还有错别字和跨页截断,所以需要模糊匹配。这里有个反直觉的地方:相似度会骗人。
样例里有一条引用是「违约金累计不超过未付款项的 10%」,原文写的是 5%。它的覆盖度是 1.000,片段数 4。因为 difflib 统计的是「引用里的字有多少在原文出现过」,允许中间跳跃——「10」在另一条款里出现过,就被拼进来了。
所以判定不能只看覆盖度,还要看片段数:逐字引用是 1 段,带错别字 2 段,拼接出来的会碎成 4 段以上。
第三道:数字必须在命中窗口内对齐
数字是合同里唯一不能模糊的东西。30 日和 60 日只差一个数字,责任差一倍。
关键设计是:数字只在「命中窗口」内比对,不能拿全文兜底。上一个例子里,10% 确实在第 3.4 条出现过,按全文查这条假引用会被判为真;窗口内查,它立刻暴露。
三道合起来,四档判定加一档条款错位。执行顺序不能换:数字校验必须排在最前,否则一条数字被改的假引用会因为覆盖度 0.95 而先被判成「近似命中」。
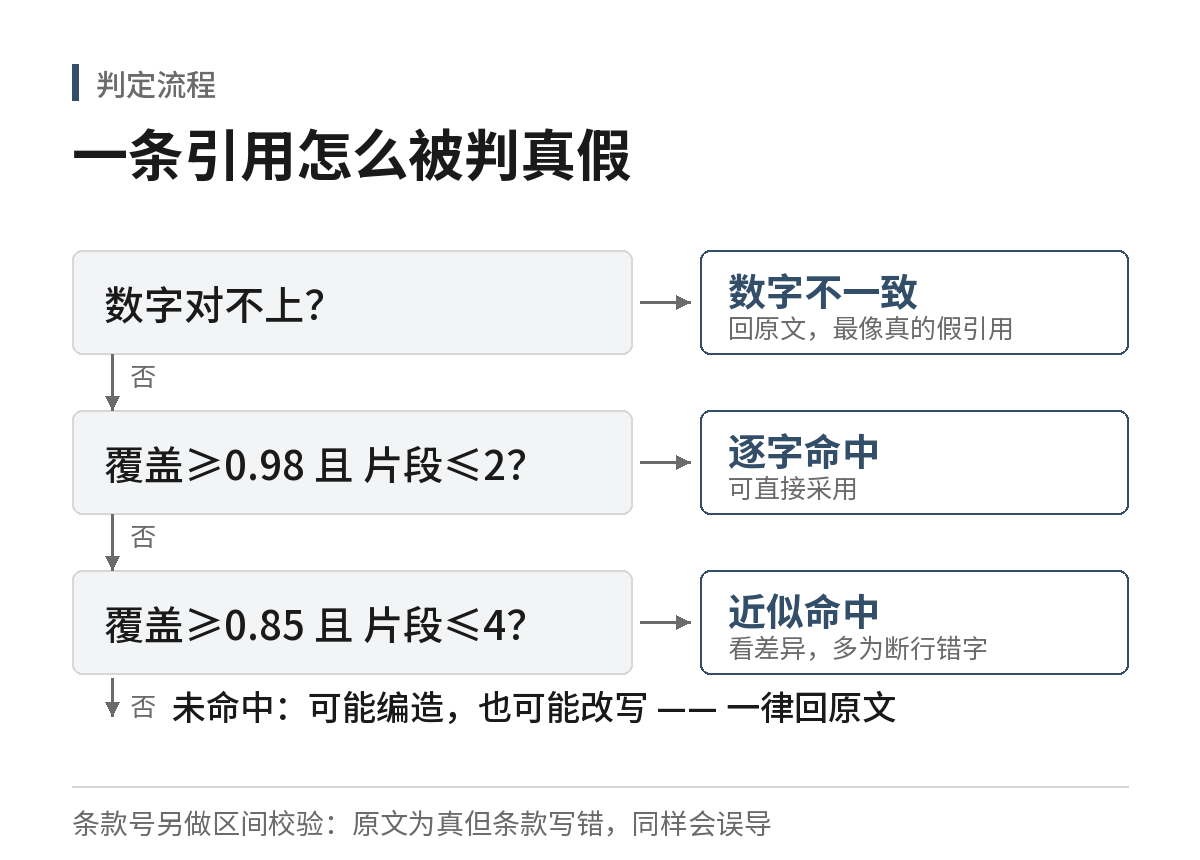
逐字命中:覆盖≥0.98、片段≤2、数字一致,可直接采用。
近似命中:覆盖≥0.85、片段≤4、数字一致,看一眼差异,多为断行或错字。
数字不一致:数字或单位对不上,一律回原文,这一档风险最高。
未命中:覆盖<0.85 或片段>4,可能编造也可能改写,必须回原文逐字查。
条款错位是单独一档:原文是真的,但条款号写错了。样例里有一条把 6.3 的数据删除义务标成 5.3,覆盖度 1.000,只有比对条款区间才能发现。
30 行版本,可以直接跑
import re, json, unicodedata, difflib

def norm(s):
    s = unicodedata.normalize("NFKC", s).translate(str.maketrans("“”‘’", '"' * 4))
    return re.sub(r"\s+", "", s)

def nums(s):
    out = {}
    pat = r"(\d+(?:\.\d+)?)\s*(个工作日|工作日|日|天|个月|月|年|元|%|倍|次|小时|分钟|百分点)"
    for m in re.finditer(pat, s):
        u = {"天": "日", "个月": "月", "工作日": "日", "个工作日": "日"}.get(m.group(2), m.group(2))
        out[f"{m.group(1)}{u}"] = 1
    return out

def check(quote, src):
    q = norm(quote)
    if q in src:
        return "逐字命中", 1.0, 1, []
    sm = difflib.SequenceMatcher(None, q, src, autojunk=False)
    blocks = [b for b in sm.get_matching_blocks() if b.size]
    if not blocks:
        return "未命中", 0.0, 0, []
    cov = sum(b.size for b in blocks) / len(q)
    win = src[max(0, min(b.b for b in blocks) - 15): max(b.b + b.size for b in blocks) + 15]
    bad = [k for k in nums(q) if k not in nums(win)]
    if bad:
        return "数字不一致", cov, len(blocks), bad
    if cov >= 0.98 and len(blocks) <= 2:
        return "逐字命中", cov, len(blocks), []
    if cov >= 0.85 and len(blocks) <= 4:
        return "近似命中", cov, len(blocks), []
    return "未命中", cov, len(blocks), []
配套跑法是把合同存成 UTF-8 文本,结论存成 JSON 数组,每条含 id、clause、quote 三个键,然后逐条调用 check。样例里 12 条结论、6 条需要回原文,单次耗时 0.3 秒(含解释器启动)。
必须说清两点。第一,这份样例合同和 12 条结论是按已知失败模式构造的,不是随机抽样,也没有接真实模型跑——它证明方法能抓住这几类错误,不等于工具在真实合同上的准确率。第二,上面这 30 行不含条款定位,条款错位那一档要另外解析条款号区间。
一个踩过的坑
第一版的条款定位只认「条款号在行首」。PDF 硬换行把长条款拆成两行后,区间断裂,一条真引用被误判成「条款错位」。修法是让续行并入上一条款,误报才归零。
这件事比脚本本身更值得记住:校验工具自己的误报比没有工具更糟。告警多了,人就开始不看告警。
四、定稿权与留痕:谁签字,留什么
工具能告诉你「这条引用是真的」,不能告诉你「这个让步值不值」。账期从 60 天让到 90 天,可能是为换三年框架合作,这个判断模型做不了,也不该它做。
按风险分级配人力,比争论「AI 准不准」有用。三类合同对应三种定稿方式:
| 合同类型 | 谁定稿,AI 做什么 |
|---|---|
| 标准模板合同 | 业务方定稿;AI 全量预审,人工抽检 |
| 非标条款合同 | 法务逐条定稿;AI 出清单,人逐条采纳或驳回 |
| 重大投融资、跨境合同 | 多级会签;AI 只做准备与比对,不参与判断 |
这套「谁能碰、碰多少」的思路,和企业AI里给智能体划权限是同一件事,四道闸的配置可以对照权限那篇一起看。
留痕要留四样:合同原文的版本与哈希、提示词版本、AI 的原始输出、逐条核对记录(谁核的、结论是什么)。前两样决定能不能复现,后两样决定能不能追责。这套留证思路,和代码许可那篇里的两道扫描是同一个逻辑——不是证明自己没错,是证明自己查过。
还有一件容易被忽略的事:法务每驳回一条 AI 意见,都是在告诉系统「这类场景你判错了」。只记采纳、不记驳回的团队,用一年也不会有进步。
落地清单
- 提示词里写死立场、逐字引用、允许说「未找到依据」。
- 每条结论必须带条款号加原文引用,缺一不入表。
- 校验前先归一化,否则 PDF 复制文本会制造大量假警报。
- 数字只在命中窗口内比对,不用全文兜底。
- 「数字不一致」一律回原文,这一档的错最像真的。
- 条款号单独校验,真引用配错条款号同样会误导。
- 文档处理链条上留四件:原文版本、提示词版本、AI 原始输出、核对记录。
- AI 的「无风险」不是结论,签字的人才是。
登录后可点赞、收藏与反馈。