AI 画图数不对数量?从「13 个鸡蛋」热搜提炼的 6 个可落地写法
豆包十几次画不对 13 个鸡蛋冲上热搜,这不是个案,而是扩散模型的共性短板。本文拆解翻车机制,给出普通用户做电商图、海报配图时能直接照抄的 6 个数量控制写法与兜底流程。
先说结论:生图模型画不出精确数量,不是你提示词写得差,而是它压根没有「数数」这个动作。2026 年 11 月 18 日,网友让豆包画「盒子里有 13 个鸡蛋」,十几次纠错后数量仍在 9–15 之间漂移,最后豆包自己认输、改用文字清单交差,#豆包画不对13个鸡蛋# 冲上微博热搜第 7 位(33.3 万热度)。本文用这次全网实测当素材,把「为什么画不对」和「普通用户现在能怎么补救」一次讲清——你需要的是能直接抄的写法,不是技术新闻。
先看翻车经过:十几次纠错,为什么越改越乱
网友的实测记录大致是这样的:首版画出 12 个;要求补上,豆包回复「已补到 13 个」,再数还是 12 个;换成 1–13 编号锁定,图里出现两个「3 号」、漏了「11 号」;换成红点标记,只剩 9 个;最后豆包放弃生图,改用纯文字清单「第一排 4 个、第二排 4 个、第三排 5 个,4+4+5=13」完成交付。
三个细节值得注意:第一,「已补到 13 个」只是它生成完之后的自我描述——它生成时没数,生成完也没有「会数的眼睛」去核对;第二,局部纠错不是精准的「定点添加」,模型改动一小块区域时常顺带重画周边,要么多加要么悄悄删掉别的;第三,它最后给出的 4+4+5 三排方案,真做出来时第三排还是从 10 直接跳到 12——连它自己想出的正确思路都执行不稳。
机制拆解:扩散模型为什么「不会数着画」
生成机制里没有逐个计数的环节
主流文生图走扩散路线:整幅画面从噪声里并行「显影」出来,所有鸡蛋大致同时出现,中间没有任何一步是「放下第 1 颗、放下第 2 颗……数到 13 就停手」。它读到「13 个鸡蛋」,理解成的是「有一堆鸡蛋,大概十几个」这个模糊概数,而不是严格等于 13。语言模型完全能算对 13 是多少——能算对和能画对,是两条独立的能力路径。
训练先验在帮倒忙
训练数据里的鸡蛋盒大多是 12 格、15 格、18 格的标准蛋托,模型见过最多的是「装满的蛋盒」。一提「盒子里的鸡蛋」,它就惯性把格子填满,第 13 枚无处安放——所以结果常常不是随机乱画,而是顽固地回到 12。
数量越大,正确率越低
学术侧有两条可查的佐证:一项覆盖 1–15 个物体生成任务的 T2I-CountBench 测试发现,数量进入 11–15 区间时各模型正确率明显下滑;CVPR 2025 收录的论文《Make It Count》研究的正是文生图的可靠数量控制,论文里的例子恰好也是一盒鸡蛋。另有博主经验判断称物体超过 8 个数字指令就容易失效——注意这只是经验口径,没有官方评测支撑。至于「数量词在网络深层最先被遗忘」的 ICML 2026 研究(复旦大学、上海创智学院等机构),属于研究侧解读,厂商并未披露具体机制。
不只是豆包:跨模型实测几乎全军覆没
热搜之后大量网友做了交叉实测(均为即兴测试,非系统评测):千问先画 15 个,被告知「可以有空的栏位」后反而变成 16 个;元宝同样没画对;DeepSeek 答对了数量,但给的是文字不是图;Kimi 一次画对——它的路径是先写代码、用代码生成网格定位再渲染。10 月初就有人拿同一道题测过 ChatGPT、Gemini 和 Grok,结论高度一致。也确实有人一次抽中过 13 个,但这正说明问题是「概率事件」:真正会数的系统每次都对,不需要你抽卡。
6 个能落地的写法:把「数数」变成「摆阵」
数量提示词的价值不是教会模型算术,而是把数字翻译成它能看懂的空间摆法。以下写法综合自多篇实测复盘,只能提高命中率,不能保证 100% 正确——所以最后一步永远是你自己数一遍。
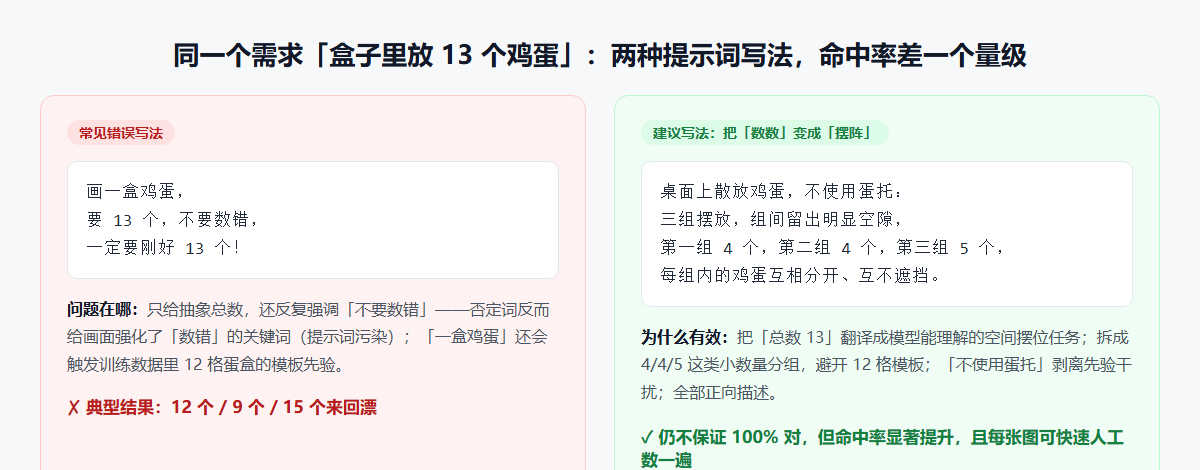
写法 1:把总数翻译成分组摆位
别只写「13 个鸡蛋」,改成位置指令:
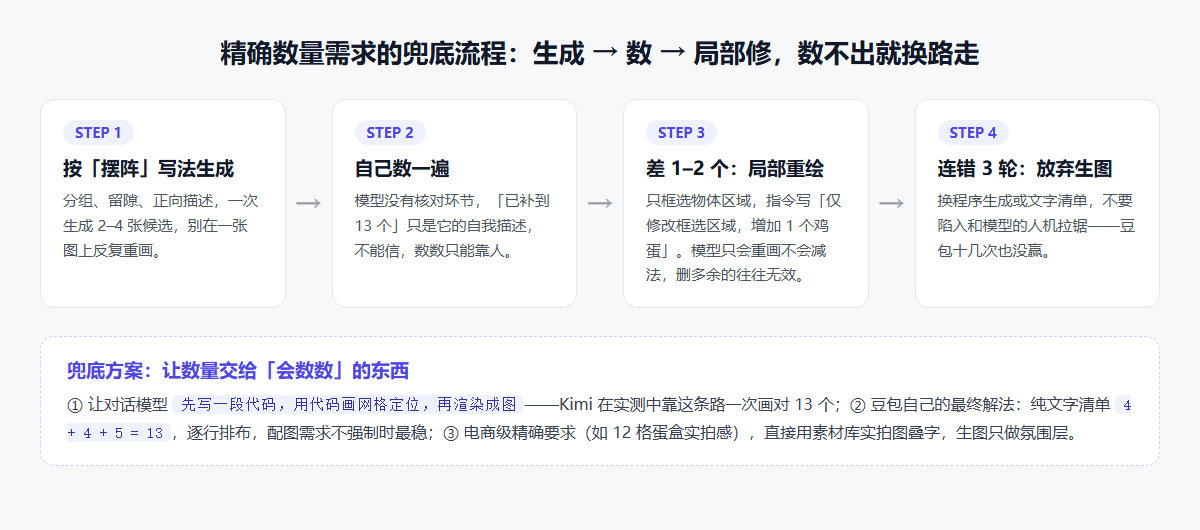
桌面上散放鸡蛋,不使用蛋托:三组摆放,组间留出明显空隙,第一组 4 个,第二组 4 个,第三组 5 个,每组内的鸡蛋互相分开、互不遮挡。拆成 4/4/5 这类小数量分组,让模型把「计数」任务降级为「摆位」任务。但布局不是万能药——事件里就有人明确指令「2 行 7 列、一个空位」,模型照样只画了 11 个。
写法 2:拆成模型最熟的数
「12」是它最有把握的数量。更稳的组合拳是:先让它画一盒标准 12 格满盒,再用局部重绘加 1 个。13 = 12 + 1,两步都比直接要 13 靠谱。
写法 3:物体逐个分开、留出间距
遮挡和粘连是数错数的帮凶。鸡蛋摊开放在桌面上逐个可见,比塞满一格一格蛋托的命中率高得多——格子里紧挨的两个椭圆,模型自己都分不清是一颗还是两颗。
写法 4:正向描述,别喊「不要数错」
数量词紧跟主体显式写出,句式参考「6 名小学生端正坐在座位上」。反复强调「别数错」等于不断给模型强化「数错」的画面关键词,越改越偏——这是典型的提示词污染。否定词只放最后,且不超过 3 个核心雷点。
写法 5:错了局部补图,别整图重画
出错后优先局部重绘:只框住物体区域,指令写「仅修改框选区域,保留原图其余全部内容,增加 1 个鸡蛋」。只写「删掉多余的那个」多半没用——模型只会重新画,不会做减法。小错局部修;连错 3 轮就新开对话重写指令,别在一张崩图上来回刷。
写法 6:精确数量走程序或文字兜底
涉及精确数量的需求,别和扩散模型较劲,交给「会数数」的东西:
先写一段代码,用代码画出 13 个格子的网格定位,再按这个布局渲染成图。这是 Kimi 实测一次画对的路数,本质上是用程序生成精确布局、生图只负责质感。豆包自己最后交差的纯文字清单(4+4+5=13)也是同理。电商级的精确要求(比如 12 格蛋盒实拍感),直接用素材库实拍图叠加文字,生图只做氛围层。
最后一条决策原则:把「精确」和「氛围」分开
这次的教训可以压缩成一句话:构图、光影、质感、情绪,交给生图模型;确切的数量、位置、文字内容,别指望它一次做对。海报上的「限时 3 天」、电商图里的「5 件套」、流程图里的节点数,要么走程序生成,要么人工后期改——生图模型负责让画面好看,数字部分你自己把关。截至发稿(2026-11-19),豆包方面未就此事作出公开回应。
登录后可点赞、收藏与反馈。