Kronos K 线模型:93% 是 RankIC,不是准确率
11 月 13 日报道的 Kronos 其实是 2025 年 8 月的论文:AAAI 2026 录用,代码停在 2026 年 4 月。本文把 93% 的 RankIC 提升还原成绝对值 0.0254,并算清 512 上下文与换手成本。
11 月 13 日,中文科技媒体把 Kronos 当成新模型报道:首个专读 K 线的开源基础模型,45 家交易所、120 亿条 K 线,最大那档不开源。
核对仓库和论文后,时间线要往前拨 15 个月。论文 2025 年 8 月 2 日上 arXiv,AAAI 2026 的录用通知在 2025 年 11 月 10 日,代码最后一次提交是 2026 年 4 月 13 日。
这篇不复述发布稿,只回答三个问题:93% 这个数字的分母是什么、512 根 K 线对回看窗口意味着什么、接进策略要付多少换手成本。
一、这不是新发布,仓库已经静了 214 天
Kronos 的技术路线很清楚:把 OHLCV 当成一门语言。先用专用 tokenizer 把 K 线量化成分层离散 token,再让 decoder-only Transformer 自回归预测下一根,与 GPT 预测下一个词同构。
论文口径是 45 家交易所、超过 120 亿条 K 线记录,摊到每家约 2.67 亿条。这个量级撑得起「基础模型」的说法——TimesFM、Chronos、Moirai 这些通用时序模型确实没在 K 线上预训练过。
问题出在时间上。仓库 README 的 News 区止于 2025 年 11 月 10 日,之后再没有版本更新。
| 时间 | 事件 | 依据 |
|---|---|---|
| 2025-08-02 | 论文上 arXiv(2508.02739) | arXiv |
| 2025-08-17 | 发布微调脚本与 Qlib 示例 | 仓库 README |
| 2025-11-10 | AAAI 2026 录用 | 仓库 README |
| 2026-04-13 | 最后一次提交 | GitHub API |
| 2026-11-13 | 中文媒体重新报道 | 网易号 |
三篇报道,三个星数
同一天的三篇中文报道,GitHub 星标分别写成了 2.33 万、3.5 万和 4.7 万。实查是 47,682 星、7,890 个 fork、299 个未关闭 issue。
星数漂移本身不致命,但它说明转写链条上没人回仓库看一眼。而仓库首页最该被看到的两条信息,恰好都在那儿:0 个 release,最后一次提交在 214 天前。
0 个 release 意味着没有版本边界
最后一次提交是连续合并五个社区 PR(#243、#234、#232、#224、#139),内容分别是修 WebUI 的 Python 版本、修 sample 的兼容问题、修 batch 相关的缺陷。
没有 tag、没有 release、没有 changelog。这类仓库的准确定位是「论文配套代码」,不是「可以直接依赖的库」:你要固定的不是一个版本号,而是某一天的 commit hash。
二、93% 是 RankIC 的相对提升,绝对值 0.0254
论文摘要里那句 RankIC 提升 93%,在不少转述里被写成了「准确率提升 93%」。两者不是一回事。
RankIC 是预测排序与真实排序的秩相关系数,取值 -1 到 1,衡量「谁涨得多」的顺序对不对,不衡量涨多少。它对选股排序有意义,对「价格预测准不准」没有直接含义。
| 方案 | 预测空间 | 训练目标 | RankIC | 相对 Direct-AR |
|---|---|---|---|---|
| Direct-AR | 连续 | 均方误差 | 0.0149 | — |
| Prob-AR | 连续 | 负对数似然 | 0.0102 | −31.5% |
| Kronos-Parallel | 离散 | 交叉熵 | 0.0226 | +51.7% |
| Kronos-small | 离散加顺序子词 | 交叉熵 | 0.0254 | +70.5% |
这张表来自论文的消融实验,四行是同一批基准、同一规模的对比。连续空间的标准回归基线是 0.0149,换成概率建模反而降到 0.0102,改成离散 token 并行预测子词升到 0.0226,再加上顺序子词到 0.0254。
也就是说,架构改进本身带来 70.5% 的相对提升,这个数字是干净的、可复现的。
把 93% 换算成两个绝对数
0.0254 除以 1.93 等于 0.0132,这是论文所说「最强 TSFM 基线」在同一批基准上的水平。
值得注意的是,论文自己的 Direct-AR 基线是 0.0149,比这个 0.0132 还高。换句话说,被称为「领先」的那个分母,低于作者自己写的最朴素的回归模型。
这不矛盾。通用时序模型在金融 K 线上本来就接近失效,同一批实验里 TimesFM、Chronos 这类模型的 RankIC 普遍贴着 0 甚至为负。93% 的分母薄,是因为整个赛道的地板低。
0.025 在量化里是什么水平
业内对单因子的经验门槛通常是 IC 0.03 到 0.05(这是行业口径,不是论文结论)。0.0254 落在门槛下方,能用,但不能单打。
另一个被忽略的细节是 IC 与 RankIC 的落差:Kronos-small 的 IC 是 0.0431,RankIC 只有 0.0254,前者高出 70%。这说明它对幅度的刻画强于对顺序的刻画,方向性不够锐利。
如果策略取 Top-K 组合,起决定作用的是排序,那就必须用 RankIC 评估,不能因为 IC 好看就上线。这类「相对提升好看、分母很薄」的坑,我们此前拆 Gemini Decision 1 的基准表时也遇到过。
三、512 上下文:免费的三档里,最小那档看得最长
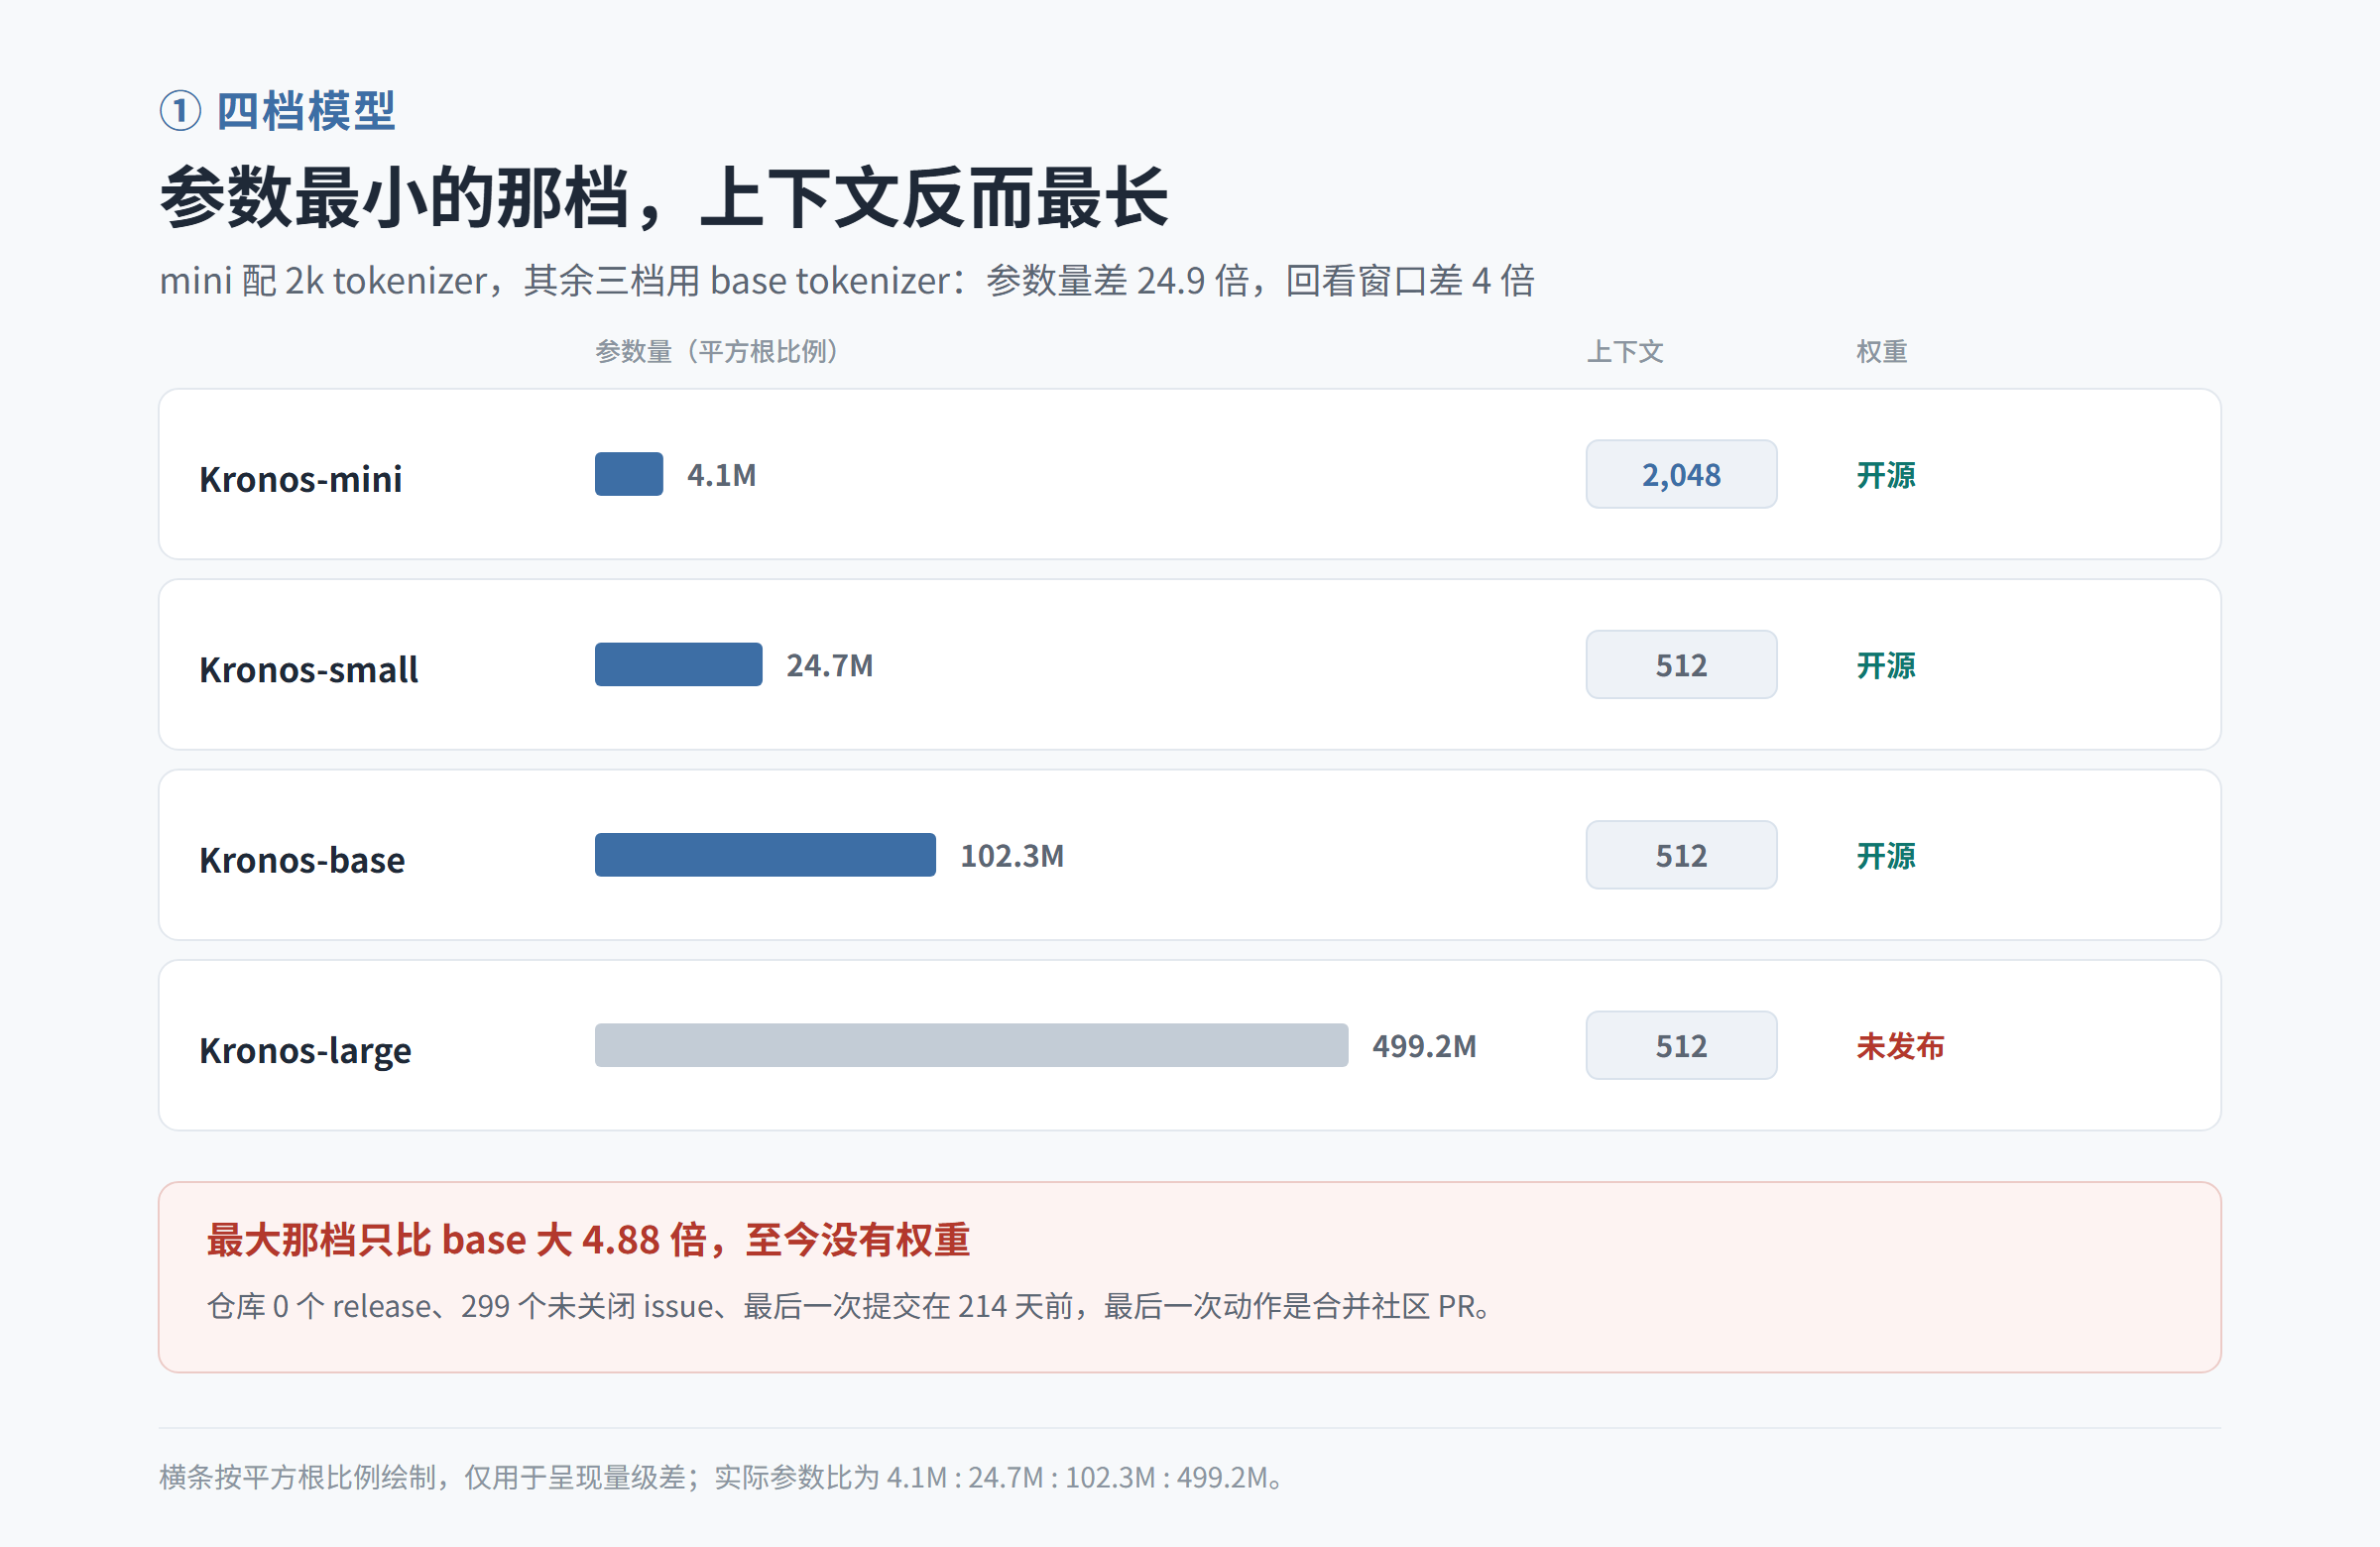
模型家族四档,参数从 410 万到 4.99 亿。三档开源,最大那档至今没有权重。
| 模型 | 参数量 | 上下文 | tokenizer | 权重 |
|---|---|---|---|---|
| Kronos-mini | 4.1M | 2,048 | Tokenizer-2k | 开源 |
| Kronos-small | 24.7M | 512 | Tokenizer-base | 开源 |
| Kronos-base | 102.3M | 512 | Tokenizer-base | 开源 |
| Kronos-large | 499.2M | 512 | Tokenizer-base | 未发布 |
上下文这一列是全文最实际的一处设计:mini 配 Kronos-Tokenizer-2k,能装 2,048 根;small、base、large 用 Tokenizer-base,上限 512 根。
参数量涨了 24.9 倍(4.1M 到 102.3M),回看窗口反而缩到四分之一。要长历史只能用最小档,要大容量就得接受 512,这是一个明确的二选一。
512 根换算是多少天
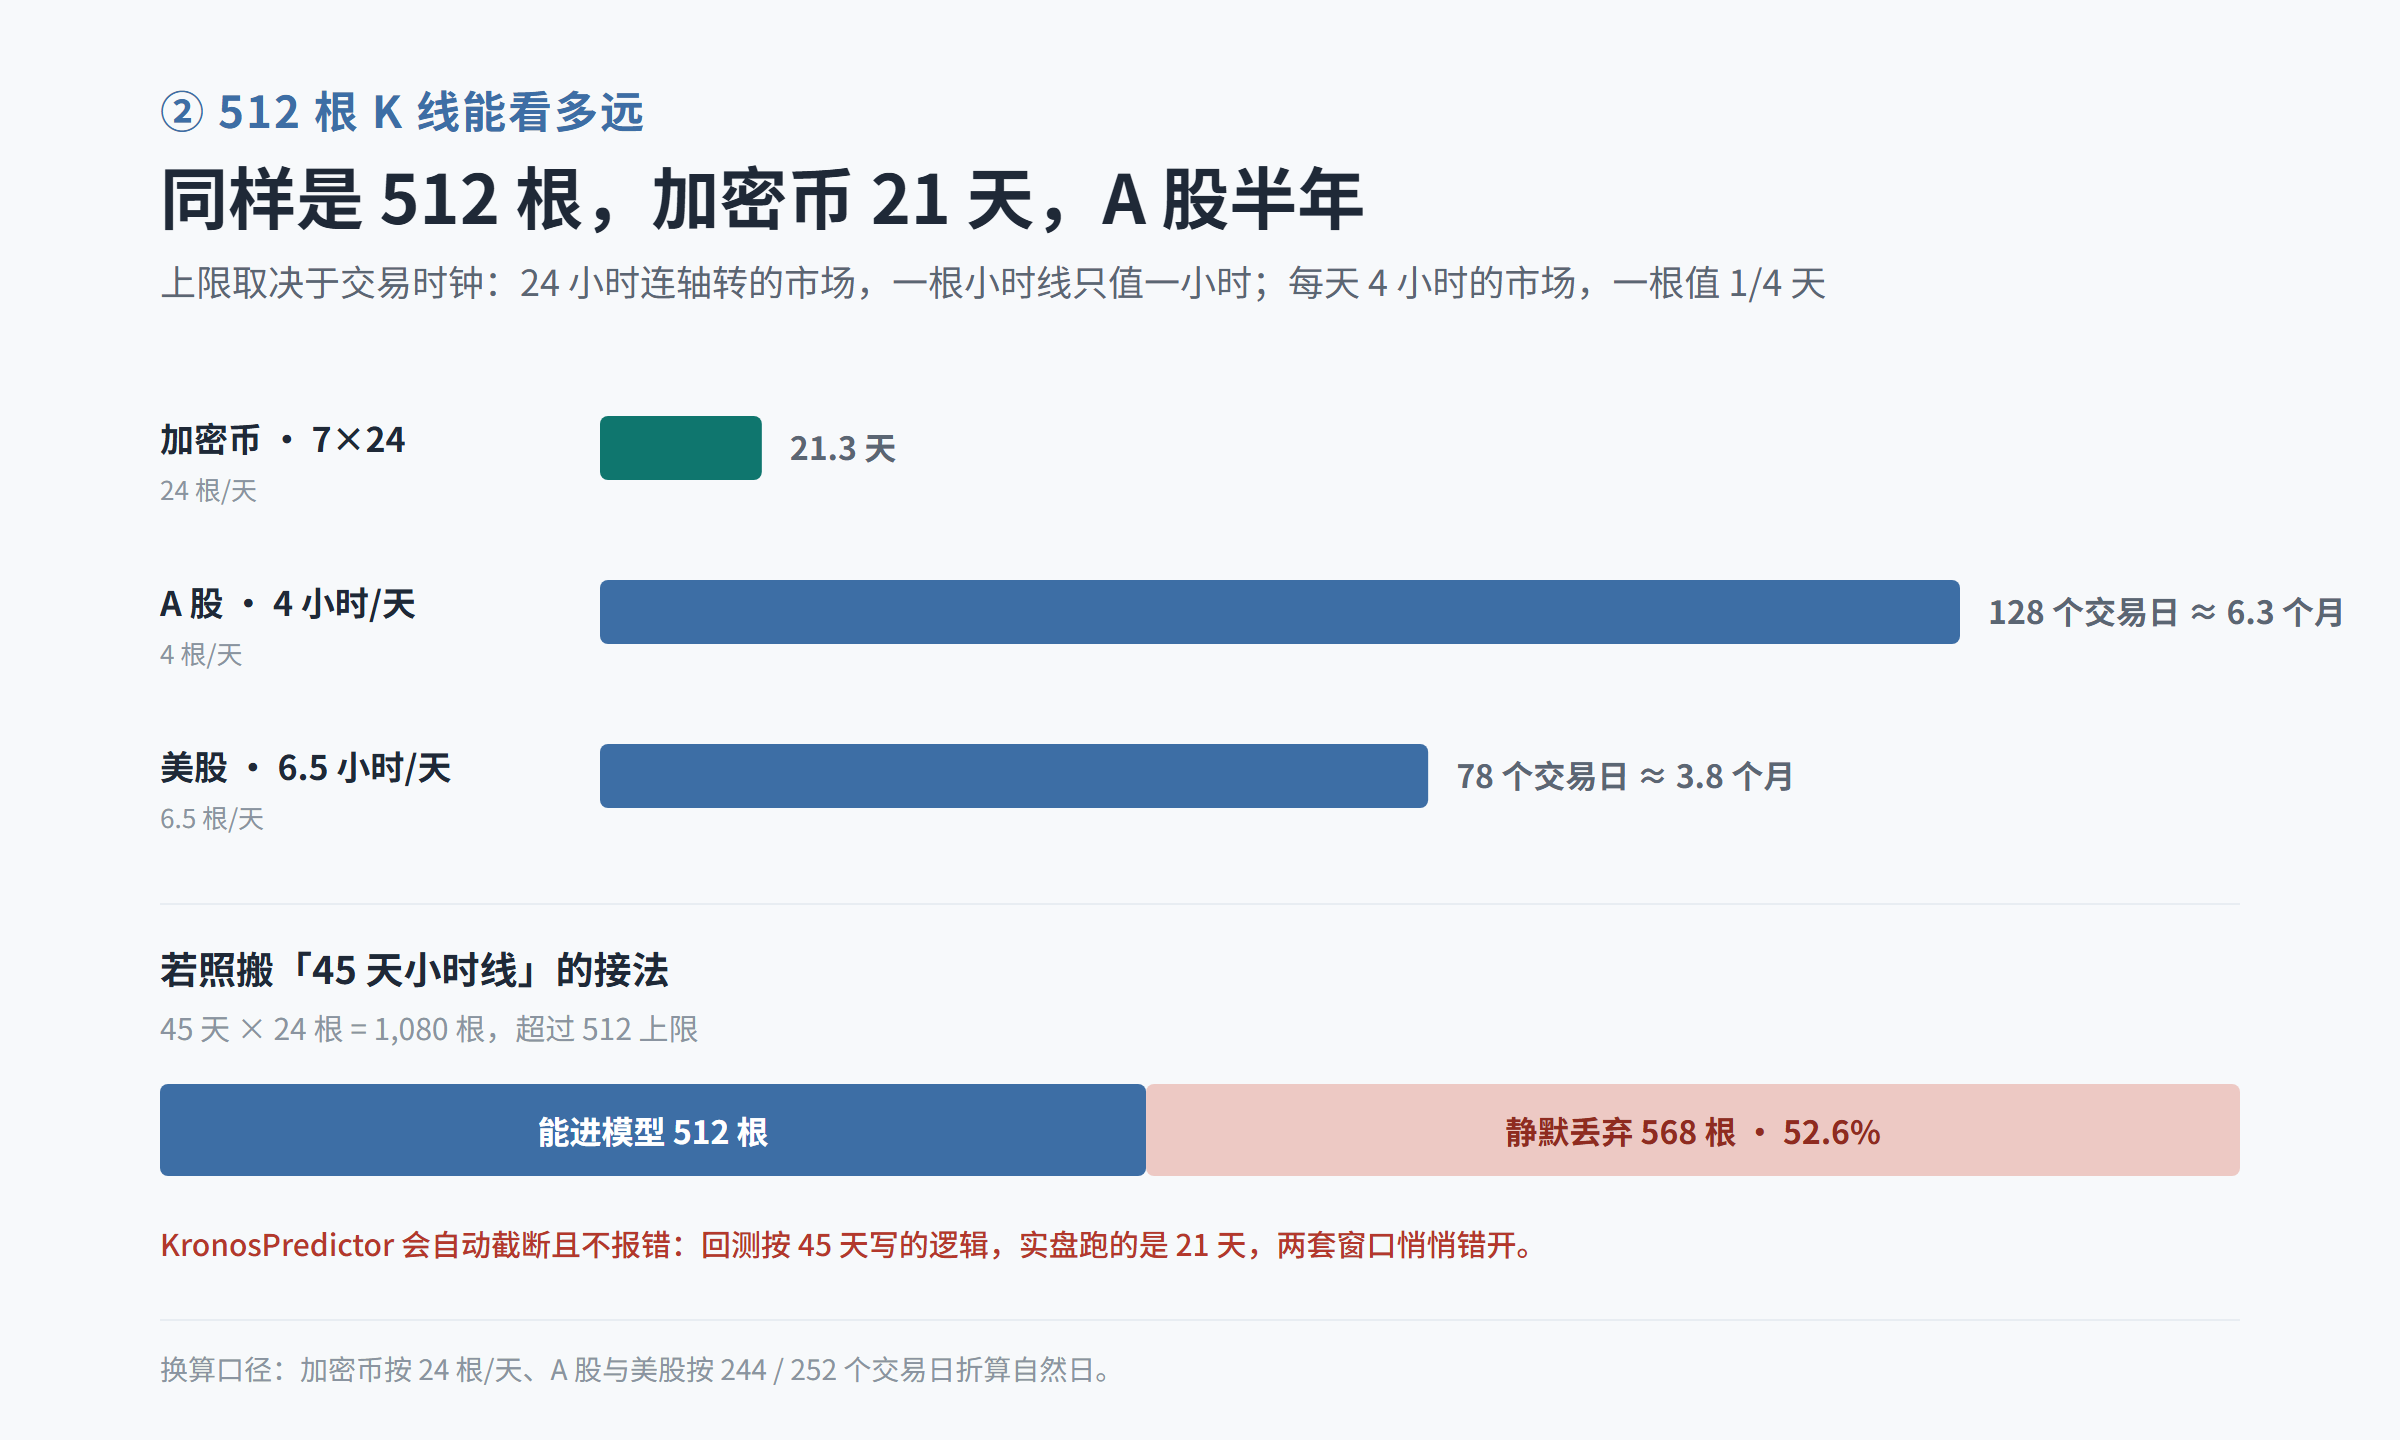
折算要看交易时钟。加密币 7×24,一小时一根,512 根是 21.3 天;A 股每天 4 小时,512 根是 128 个交易日,约 6.3 个月;美股 6.5 小时,78 个交易日,约 3.8 个月。
差距全在分母上:同样是 512 根,24 小时市场的一根只值一小时,4 小时市场的一根值 1/4 天。
45 天小时线会被砍掉一半
社区里流传的一种接法是「取 45 天小时线」。45 乘 24 等于 1,080 根,超过上限一倍多。KronosPredictor 的处理方式是自动截断,只保留最近 512 根,不报错、不警告。
按条数算,被丢掉的是 568 根,占 52.6%。按天算,回测里你以为在用 45 天,模型实际只看到 21 天。
这类静默截断在回测里最危险:逻辑写得没问题,指标也跑得出来,只是输入和你以为的不是同一份。
四、接进策略:成本在信号之外
论文的投资模拟给出了可直接复用的参数:沪深 300 取 k 等于 50、每日最多换 5 只;中证 800 取 k 等于 200、每日最多换 10 只;预测跨度 H 等于 10 日;回看 90 日;单边成本 0.15%;最短持有 5 个交易日。
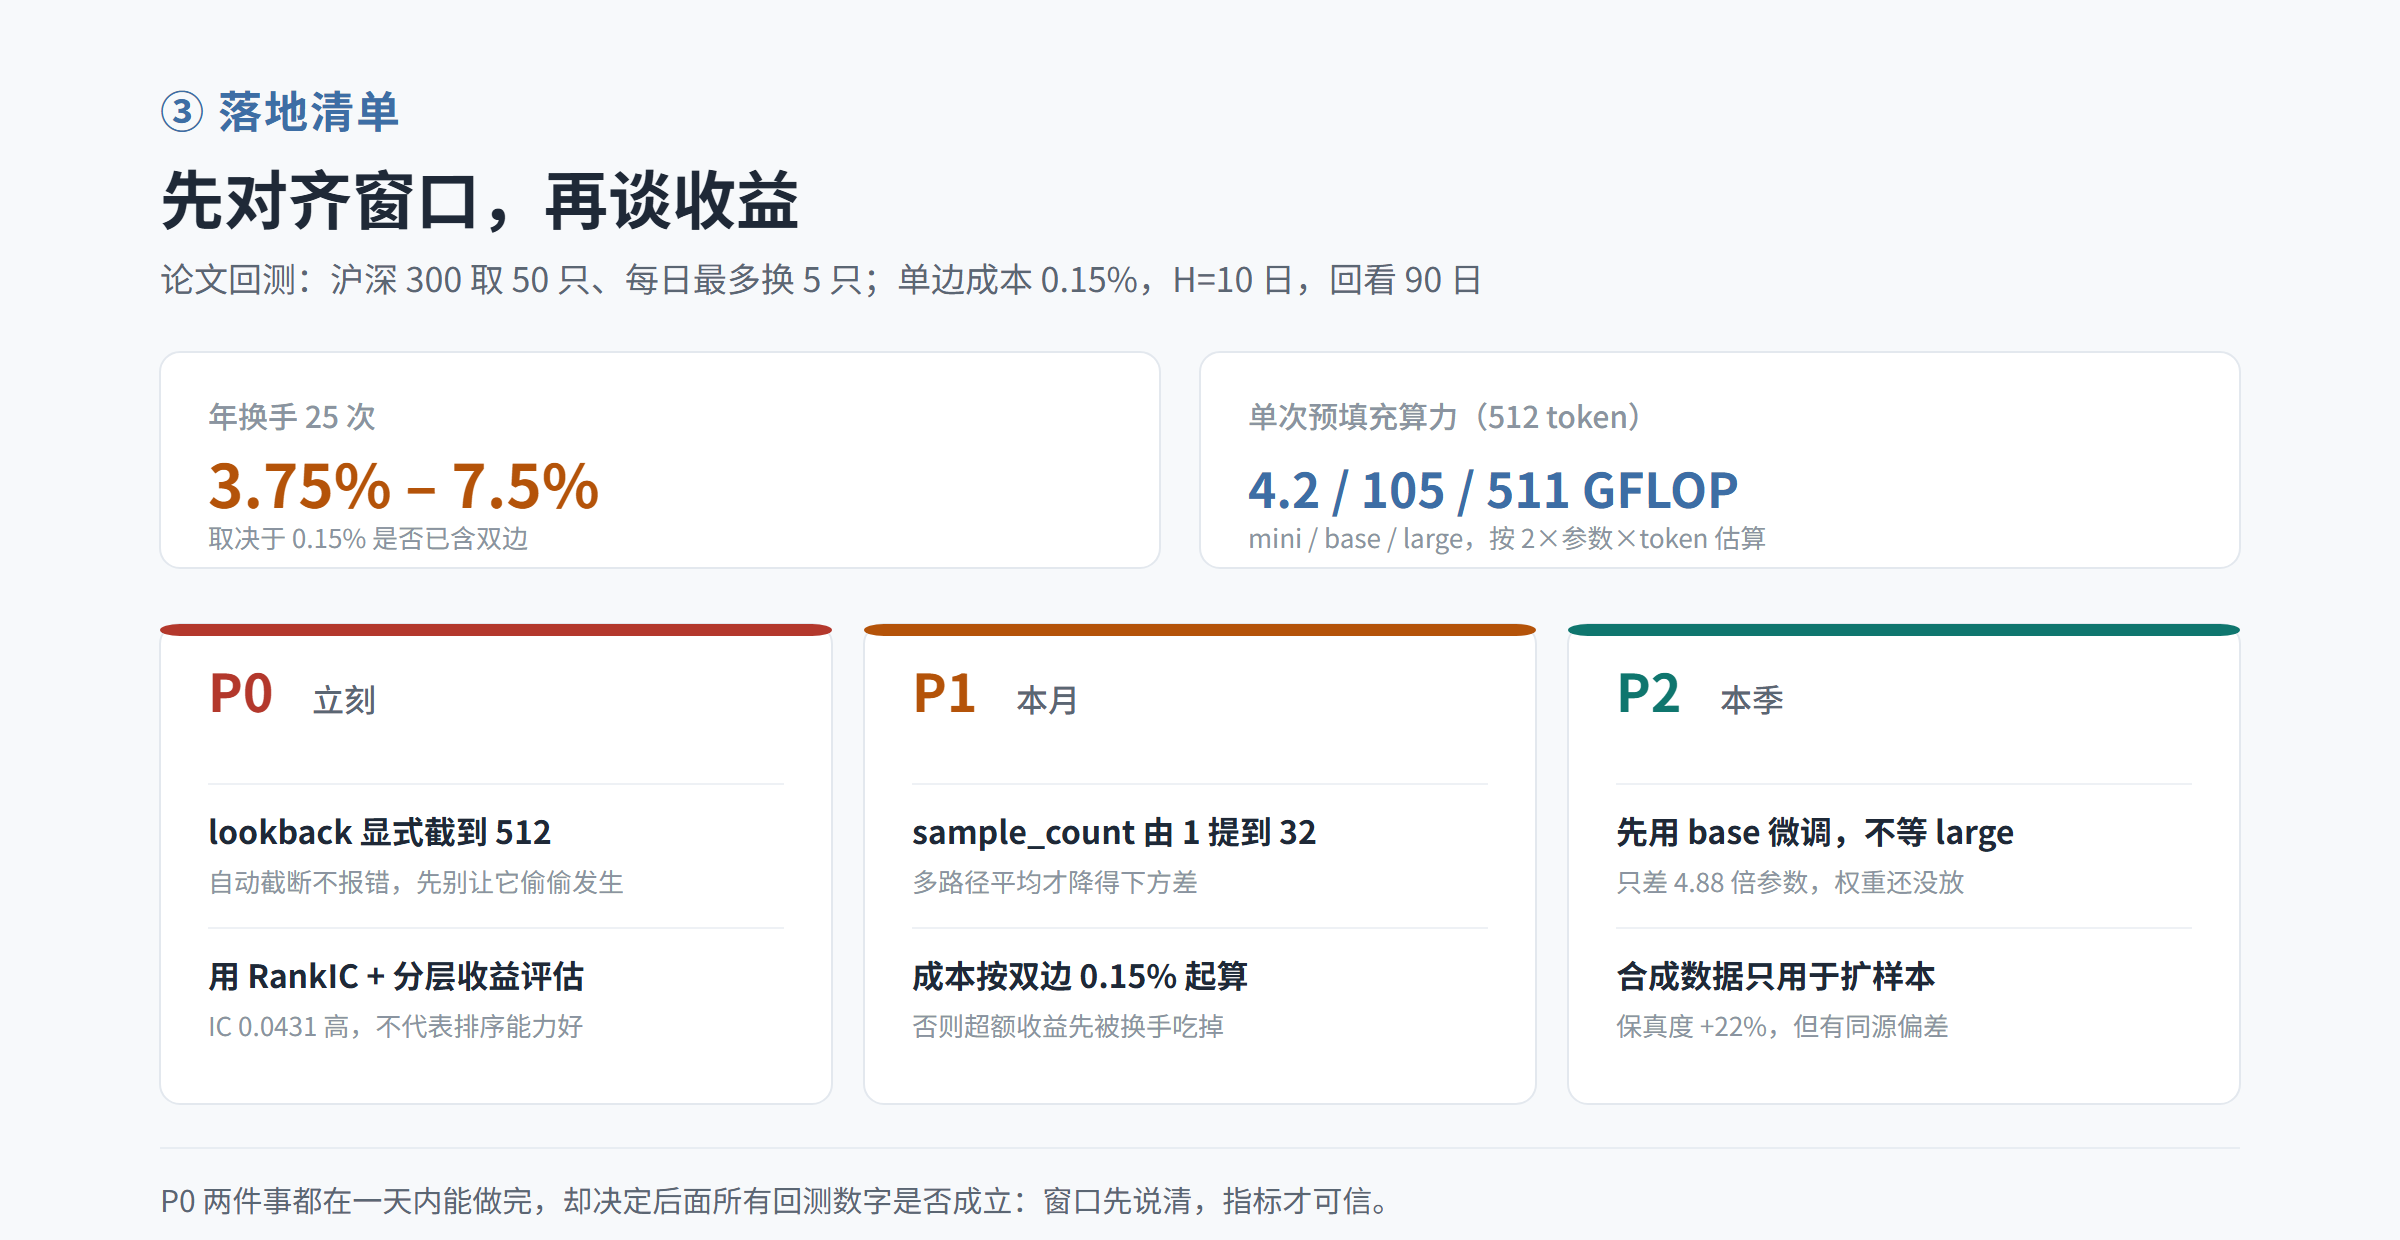
按 50 只持仓、每天换 5 只算,日换手 10%,10 个交易日走完一轮,一年 25 轮。成本落在 3.75% 到 7.5% 之间——取决于 0.15% 是按买卖合并计,还是买卖各计一次。
对 RankIC 0.025 的信号,这条成本线不低。多头组合的年化超额通常也就个位数百分点,换手先吃掉三到七个点,剩下的空间要靠组合优化和风险中性化去挤。
采样次数是最便宜的改进项
predict 的默认 sample_count 是 1,也就是只抽一条路径。论文 Figure 7 的结论相反:把多条采样路径取平均,IC 与 RankIC 会随路径数增加而单调提升。
原因在生成方式。自回归采样带随机性,单条路径方差大,平均之后估计更稳。代价是算力线性增长,但小模型的算力本来就便宜。
按 2 乘参数量乘 token 数估算,512 token 的预填充约 4.2 GFLOP(mini)、105 GFLOP(base)、511 GFLOP(large)。抽 32 条路径,mini 也只是百 GFLOP 量级。相比按 token 结算的云端模型(见 11 月大模型 API 价格表),本地推理的边际成本接近零。
| 优先级 | 动作 | 理由 |
|---|---|---|
| P0 | 把 lookback 显式截到 512,或换 mini 用 2,048 | 自动截断不报错,回测与实盘会错开 |
| P0 | 用 RankIC 加分层收益评估,不只盯 IC | 排序才是 Top-K 策略的决定因素 |
| P1 | sample_count 从 1 提到 32 | 多路径平均降方差,算力代价低 |
| P1 | 成本按双边 0.15% 起算 | 年换手 25 轮,3.75% 到 7.5% |
| P2 | 先用 base 微调,不等 large | 只差 4.88 倍参数,权重未放 |
| P2 | 合成数据只用于扩样本 | 保真度 +22%,但存在同源偏差 |
闭源侧用价格窗口管理迁移节奏,开源侧用权重发布时间管理期待,两种做法都在把「你什么时候能用上什么」变成变量。区别是前者可以算清楚,后者只能等。这一点上,Gemini 4 Hydrogen 的定价窗口是个更透明的样本。
小结:Kronos 值得试的地方,是它把 K 线当成语言,而不是又一条时间序列,tokenizer 加自回归的组合也确实换来了可测的提升。不值得直接上生产的地方同样清楚:214 天没有提交、0 个 release、最大档没放权重、512 根的上限还会静默截断。
比较合理的用法,是把它当「因子候选」而不是「策略」:用 mini 先跑通流程、用 RankIC 与分层收益验证信号,再决定要不要为 base 做微调。等 large 不是策略,是等待。
登录后可点赞、收藏与反馈。