1572 行函数交给 AI 拆成 150 行:6471 个测试全绿,为什么还不能合并
AI 把 1572 行函数拆成 150 行、6471 个测试全绿,仍可能悄悄改坏行为。拆解四步拆分法与录像对比、新旧对题、覆盖自检、故意埋雷四道证据,附可抄的 pytest 脚本与十条报错急救。
一个 1572 行的后台任务函数,AI 编码助手按清理流程做重构:主函数拆到 150 行,圈复杂度从 143 降到 7,6471 个测试每一步都全绿。作者的结论却是:测试绿了,只说明写过的用例没坏,还不敢说“行为一点没变”。
原因有两层。1572 行里大量岔路没人写过用例;更麻烦的是 Python 测试常用按名字打桩,代码一搬家,桩可能还“打着”,实际跑的已经是真依赖。这两件事,测试报告都不会告诉你。
他补了四道独立证据:录像对比、新旧对题、覆盖自检、故意埋雷。下面按能直接抄的顺序重写一遍,并补上我在本机复现的两种桩失靶——第二种比“测试失败”难查得多,因为它绿着。
为什么 1572 行拆完、6471 个测试全绿,还是不敢合并
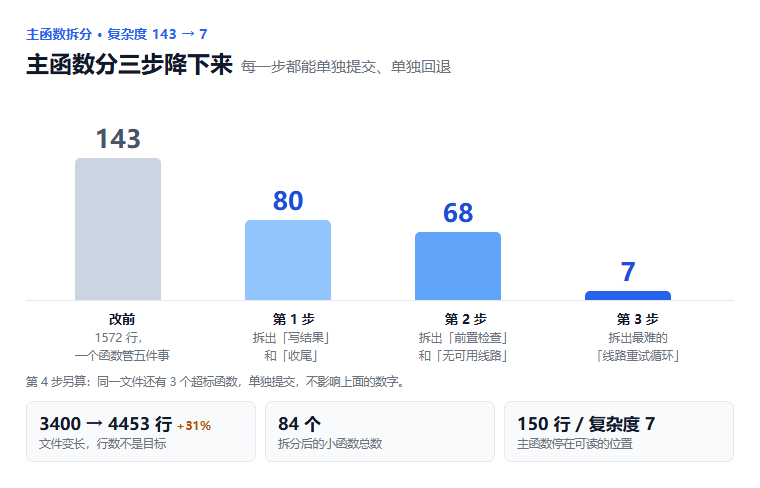
先看结果:主函数 1572 行降到 150 行,圈复杂度 143 降到 7;全量测试 6471 个,四步拆分每一步都是 6471 通过、0 失败。
问题在“通过”这两个字。它只覆盖两种东西:用例写过的路径,和打桩打中的依赖。
第一种是覆盖盲区。1572 行里有大量分支,测试不可能穷举。拆函数时把“不为 None 才拷贝”和“为真才拷贝”合并成一种判断,空字符串和 0 的处理就变了——这种差异,原有测试很可能一条都没写到。
第二种更隐蔽:打桩失靶。unittest.mock.patch("模块.属性") 是按名字替换,代码一搬家,会出现两种完全不同的结果。
| 形态 | 本机复现的现象 | 危险度 |
|---|---|---|
| 桩的目标被搬走 | AttributeError: <module 'svc' ...> does not have the attribute 'fetch',测试直接红 | 低,至少能发现 |
桩还在,调用方改成 from http import post | patch 成功,测试可能照常绿,实际打出 REAL-CALL:/pay | 高,绿着跑真依赖 |
第二种值得多说一句。测试 patch 的是 jobs.http.post;重构后的 retry.py 写的是 from http import post,导入时就把函数绑到了自己模块里。patch 改的是 http.post,改不到 retry.post。
测试不会因为这次 patch 报错,因为目标确实存在;如果断言刚好也过得去,它就绿着跑完了真依赖——只是它管的那条路,已经没人走了。
# retry.py(重构后)
from http import post          # 导入时绑定,patch jobs.http.post 管不到它
def attempt(url):
    return post(url)

# 测试里
with patch("jobs.http.post", return_value="STUB"):
    print(jobs.run("/pay"))    # 输出 REAL-CALL:/pay,测试却是绿的
判断口诀:patch 要打在“被调用时查找的那个名字”上,不是“函数定义的地方”。搬完代码,先 grep 一遍
from .* import,再回头核测试里的 patch 路径。
先别数行数:该拆的是“岔路口”,不是长函数
网上那张“30 行理想、200 行该重构、1500 行是屎山”的表,好记,但只看长度。读代码真正累的,是要同时记住多少种情况。圈复杂度数的就是这个:函数里有多少个 if、循环、except。
作者拿同一批 11 个函数,用两把尺子各量一遍。两头一致,中间打架:
| 函数 | 行数尺的判断 | 圈复杂度 | 该不该拆 |
|---|---|---|---|
| 22 行、12 个岔路口 | “非常理想” | 12,超过 Ruff 默认上限 10 | 该拆,行数尺没报 |
| 85 行(改后)、2 个岔路口 | “建议拆分” | 2 | 不该拆,行数尺误报 |
Ruff 的 C901 默认上限就是 10([tool.ruff.mccabe] max-complexity)。这次把目标定在 8,给上限留余量;行数不当目标,事先说好不承诺减行。
# pyproject.toml
[tool.ruff.mccabe]
max-complexity = 10

# 只看复杂度,不跑全量规则
ruff check --select C901 .
主流教程 vs 这次做法:差在“证据”,不是“工具”
主流教程解决的是“怎么让 AI 改”,这次解决的是“改完怎么证明没改坏”。前者靠提示词,后者靠证据链。
| 维度 | 主流做法 | 这次做法 |
|---|---|---|
| 验收标准 | 测试全绿、lint 通过 | 四类独立证据,且先证明证据能报错 |
| 拆分目标 | 函数行数小于 200 | 圈复杂度不超过 8(默认上限 10) |
| 改动方式 | 一次性大改,出事再回滚 | 分步做,每一步单独提交、单独回退 |
| 差异处理 | 看到 diff 就改代码 | 先归因,再判断是不是真回归 |
| 覆盖判断 | 看总覆盖率百分比 | 只看本次变更行有没有被执行 |
| 检查可信度 | 默认检查有效 | 先埋雷,确认检查抓得住错 |
差别不在工具,在验收的定义。“测试通过”是一个结果,“行为等价”是一组证据。
四步拆分法:AI 重构的每一步都能单独提交、单独回退
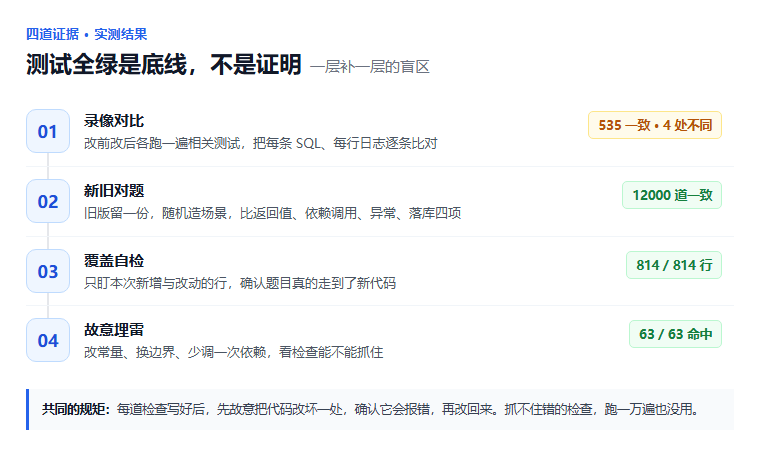
一口气改 1572 行,出问题不知道是哪一步引起的。作者把它拆成 4 步,每一步都是一个能单独提交、单独回退的状态:143 降到 80,再到 68,最后到 7。第 4 步处理同一文件里另外 3 个超标函数,不影响主函数这组数字。
拆完的主函数读起来像一份目录:
async def run_job(...):
    job = prepare_job(...)                      # 前置检查
    if (done := await already_finished(job)):   # 已经做完就直接返回
        return done

    state = await run_route_loop(job)           # 按顺序试各条上游线路
    if state.finished:
        return state.result

    outcome = state.outcome()
    finalized = await finalize(job, outcome)    # 写结果、结算、审计
    await notify(job, finalized)                # 推送与告警
    return summary(job, outcome)
拆的过程中顺手收拾了三类典型问题,都是老代码里常见的:
- 同一段“排队重试”复制了 4 份,其中一份 50 多行,收成一个函数。
- 循环里定义了 4 个闭包,都引用循环变量,读的人得自己确认会不会读到下一轮的值,改成一个带状态的小类。
- 90 多行“有值才拷贝”的 if,原代码把“不为 None 才拷”和“为真才拷”混着用;合成一种会改变空字符串和 0 的处理,最后拆成两个函数。
注意最后一条:合并重复代码时,“看起来一样”不等于“行为一样”。这也是后面四道证据存在的理由。
第一道证据:录像对比,逐条比 SQL 和日志
做法很土:改前、改后各跑一遍相关的 554 个测试,把每个测试发出的每条 SQL、每行日志记下来,逐条比对。像给程序录两段像,一帧一帧对。
结果不是“全一致”:535 个完全一致,14 个改前就不稳定(输出里有随机文案),另有 4 个不一致。
这 4 个多发了一次数据库查询,查到的数据完全一样。原因是测试共用一个数据库连接:改前大函数一直攥着某条记录,它留在缓存里,再读不用查库;拆成小函数后,记录随函数返回被释放,再读就要重新查。临时把记录留住再跑,差异消失,原因确认。线上每次新建连接,本来就会查库,所以没有实际差别。
看到 diff 先归因,别急着改代码。录像对比的价值是把“可疑差异”全部摊开;哪些是真回归,要靠第二道证据和业务判断。
插件不长,挂在 pytest_runtest_call 上就够:
# conftest.py —— 每个测试结束后,把日志落成一行 JSON
import json, logging, os
import pytest

RECORDS, SINK = [], []

class _Sink(logging.Handler):
    def emit(self, record):
        SINK.append(record.getMessage())

logging.getLogger().addHandler(_Sink())
logging.getLogger().setLevel(logging.INFO)

@pytest.hookimpl(wrapper=True)
def pytest_runtest_call(item):
    SINK.clear()
    result = yield
    RECORDS.append({"test": item.nodeid, "logs": list(SINK)})
    return result

def pytest_sessionfinish(session, exitstatus):
    with open(os.environ.get("RECORD_OUT", "records.jsonl"), "w", encoding="utf-8") as f:
        for r in RECORDS:
            f.write(json.dumps(r, ensure_ascii=False) + "\n")
SQL 用 SQLAlchemy 的事件挂上去;异步引擎记得用 engine.sync_engine:
from sqlalchemy import event

@event.listens_for(engine.sync_engine, "before_cursor_execute")
def _record_sql(conn, cursor, statement, params, context, executemany):
    SINK.append("SQL " + " ".join(statement.split()) + " " + repr(params))
比对前必须归一化,否则时间戳、UUID、内存地址会把所有测试都报成不一致:
import json, re

def norm(s):
    s = re.sub(r"\d{4}-\d\d-\d\d[ T][\d:.]+", "<TS>", s)
    s = re.sub(r"\b[0-9a-f]{8}-[0-9a-f-]{27}\b", "<UUID>", s, flags=re.I)
    s = re.sub(r"0x[0-9a-f]+", "<ADDR>", s, flags=re.I)
    return " ".join(s.split())

def load(path):
    return {r["test"]: [norm(x) for x in r["logs"]]
            for r in map(json.loads, open(path, encoding="utf-8"))}

before, after = load("before.jsonl"), load("after.jsonl")
for t in sorted(before.keys() & after.keys()):
    if before[t] != after[t]:
        print(t, "\n  改前", before[t], "\n  改后", after[t])
第二道证据:新旧两版做同一套题(12000 道)
录像只能看到“对外发出的东西”。返回值、依赖调用顺序、异常类型、最后写进数据库的内容,要另一套办法:把改前的代码留一份,和新代码并排跑同一批随机场景。这套做法在测试圈叫差分测试(differential testing),也有人叫新旧对跑。
改前版本直接从 git 取,别手工复制。提交号换成你自己的,下面以 HEAD~4 为例:git show HEAD~4:jobs.py > legacy_jobs.py。
外部依赖全部换成会记账的替身,场景随机生成。判定标准是四项全等:
- 返回值:结构、字段、类型都要一样。
- 依赖调用:调了谁、按什么顺序、带什么参数。
- 异常:抛不抛、抛哪个类型、消息是否一致。
- 落库:写了哪些行、字段值、最终状态。
# difftest.py —— 改前改后各做一遍,四项全比
import importlib, random, sys

def scenario(seed):
    rng = random.Random(seed)
    return {"upstream": rng.choice(["ok", "fail", "429", "timeout"]),
            "attempts": rng.randint(1, 5),
            "amount": rng.randint(0, 10000)}

def run(mod, sc):
    calls, db = [], []
    fake = FakeDeps(sc, calls, db)   # 记账替身:不碰真库、真网络
    try:
        out, err = mod.run_job(sc, fake), None
    except Exception as e:
        out, err = None, type(e).__name__
    return {"out": out, "calls": calls, "err": err, "db": db}

old = importlib.import_module("legacy_jobs")
new = importlib.import_module("jobs")
bad = [s for s in range(12000) if run(old, scenario(s)) != run(new, scenario(s))]
print(f"{12000 - len(bad)}/12000 一致,首个不一致:{bad[:1]}")
sys.exit(1 if bad else 0)
结果 12000 道全部一致。这里还踩过一个坑:对比脚本的日志级别设错,INFO 级别的日志根本没记下来,也就没参与比较。修好重跑,结论没变,但证据到这时才完整。
检查工具本身也要检查。这是四道证据共同的规矩:写好后先故意改坏一处,确认它会报错。
第三道证据:确认题目真的考到了新代码
12000 道全对,前提是题目真的走到了新代码。统计下来,新增和改动的 814 行全部被执行到。
做法是 coverage 只测目标文件,再把“本次改动行”和“已执行行”求差:
# 先跑 coverage,再导出 JSON
# coverage run --include="jobs.py" -m pytest -q
# coverage json -o coverage.json

# check_cov.py —— 只盯本次改动的行
import json, re, subprocess, sys

cov = json.load(open("coverage.json", encoding="utf-8"))
executed = set(cov["files"]["jobs.py"]["executed_lines"])   # 键名先打印确认

diff = subprocess.check_output(
    ["git", "diff", "-U0", "HEAD~1", "--", "jobs.py"], text=True)
changed = set()
for h in re.finditer(r"^@@ -\d+(?:,\d+)? \+(\d+)(?:,(\d+))? @@", diff, re.M):
    start, count = int(h.group(1)), int(h.group(2) or 1)
    changed.update(range(start, start + count))

print("改动行", len(changed), "未执行", sorted(changed - executed))
sys.exit(1 if changed - executed else 0)
这里有个 coverage 的坑,我本机验证过:函数定义那一行会被算作“已执行”,哪怕函数一次都没被调用。一个只定义、没调用的函数,executed_lines 里照样有 def 那一行,只有函数体是 missing。
所以覆盖自检只能证明“走到过”,不能证明“断言过”。它必须和第四道证据一起用。
第四道证据:故意埋 63 个雷
执行到,不等于检查到。最后一步是故意往代码里埋雷:改一个常量、换一个边界、少调一次依赖,每埋一个就让新旧对题重跑,看它能不能发现。这就是变异测试(mutation testing)的手工版。
一共埋了 63 个,最终全部被发现。前几轮有漏网的,说明随机题目没出到那条路,补了题目才全部抓住。没有这一步,“12000 道全对”也可能只是题太简单。
现成工具可以用 mutmut,但它的前提是系统支持 fork,Windows 原生跑不了,要进 WSL。只改几处的话,手写一个更省事,也不绑平台:
# mutate.py —— 不依赖 fork,Windows 原生也能跑
import pathlib, subprocess, sys

MUTANTS = [
    ("if attempts > 3:", "if attempts >= 3:"),
    ("amount * 0.9", "amount * 0.95"),
    ("await notify(job)", "pass  # 少调一次依赖"),
]

path = pathlib.Path("jobs.py")
original = path.read_text(encoding="utf-8")
survivors = []

for i, (old, new) in enumerate(MUTANTS, 1):
    text = path.read_text(encoding="utf-8")
    assert text.count(old) == 1, f"第 {i} 个雷没埋进去:匹配 {text.count(old)} 处"
    path.write_text(text.replace(old, new), encoding="utf-8")
    try:
        r = subprocess.run([sys.executable, "difftest.py"], capture_output=True, text=True)
        killed = r.returncode != 0 and "不一致" in r.stdout
        if "SyntaxError" in r.stderr or "ImportError" in r.stderr:
            print(f"第 {i} 个是假杀:变异体根本没跑起来")
    finally:
        path.write_text(original, encoding="utf-8")
    print(("KILLED " if killed else "SURVIVED ") + f"{i}: {old} -> {new}")
    if not killed:
        survivors.append(i)

print(f"{len(MUTANTS) - len(survivors)}/{len(MUTANTS)} 被抓到")
sys.exit(1 if survivors else 0)
两个容易自欺的细节:
- 雷没埋进去:字符串匹配 0 处,脚本什么也没改,跑出来当然“一致”。所以先断言
count == 1。 - 假杀:改出语法错误或导入错误,测试也会非 0 退出,但这不是检查抓住了行为差异,是变异体根本没跑起来。要区分失败原因。
代价:文件变长 31%,主函数停在 150 行
拆完文件从 3400 行涨到 4453 行,多了 31%。拆函数不会减少岔路口的总数,只是把它们分到 84 个小函数里;函数签名和说明也要占行。这是事先就说好的,不承诺减行。
主函数停在 150 行,复杂度已经是 7,剩下的主要是参数和日志。再拆只会把一串参数原样往下传,读起来更累。
四道证据各有盲区,别指望某一道包打天下:
| 证据 | 能抓到 | 抓不到 |
|---|---|---|
| 录像对比 | 对外发出的 SQL、日志、HTTP 调用的差异 | 结果相同、内部路径不同的差异(要靠归因) |
| 新旧对题 | 各种输入下的返回值、调用、异常、落库 | 真实数据库的缓存、隔离级别、连接池差异 |
| 覆盖自检 | 本次改动行有没有被执行 | 执行了但没有断言 |
| 故意埋雷 | 现有检查能不能发现错误 | 没埋到的错误类型 |
常见翻车报错与急救清单
下面十条是这套流程里最容易卡住的地方。报错特征按本机或原文的实际输出写,方便直接搜。
| 现象 / 报错 | 原因 | 处理 |
|---|---|---|
AttributeError: <module 'x'> does not have the attribute 'fetch' | patch 的目标被搬走 | 改成新路径,或 patch 调用点 |
| 测试绿着,日志里出现真实请求 | 新模块用 from http import post,patch 管不到本地绑定 | patch retry.post,或统一改成模块导入 |
| coverage 全是 0%,只统计到测试文件 | --include 路径与实际文件键名不一致 | 先打印 cov["files"].keys(),或用 source 配置 |
函数没被调用,def 行却算已覆盖 | coverage 按行计,定义行执行过 | 不只看覆盖,配合埋雷 |
| 录像对比全部不一致 | 日志里带时间戳、UUID、内存地址、耗时 | 先归一化,再比对 |
| 十几个测试改前就不稳定 | 随机文案、并发、时间依赖 | 改前跑 3 遍,只比稳定集 |
pytest: error: unrecognized arguments | 插件没注册 | 放 conftest.py,或加 -p 插件名 |
| mutmut 在 Windows 原生启动失败 | 需要 fork 支持 | 进 WSL,或用手写埋雷脚本 |
| 变异后测试非 0 退出,却算不出行为差异 | 语法/导入错误造成的假杀 | 检查 stderr,区分断言失败与崩溃 |
git diff -U0 取到的改动行偏多 | 把上下文行也算进去了 | 只取 + 段的起始行与行数 |
什么时候别这么干
这套流程不是免费的。四道证据跑完,时间可能是让 AI 拆函数的几倍。下面几种情况,直接放弃更划算:
- 函数不到 100 行、复杂度低于 10:拆了收益有限,四道证据的成本反而更高。
- 没有测试,或测试全是“能跑就行”:先补 characterization test(把当前行为钉住),再谈等价。否则新旧对题没有裁判。
- 强 IO、长事务、外部回调密集:录像会被噪声淹没,先把外部依赖隔离出来,再拆。
- 一次性脚本、生命周期不到一个月:重写比证明等价快。
- 没有 git,或工作区一堆未提交改动:先提交。没有干净的改前版本,四道证据全部失效。
还有一层要说明:这是一个作者的自述案例,数字来自他自己的项目,没有第三方复现。rulemason 本身是个很年轻的小项目(今年 11 月初建仓,Apache-2.0,截至 11 月 21 日 1 star),它提供的是规则和关卡;录像对比、新旧对题、故意埋雷这三套脚本,并不在工具里,是 AI 按“等价证据独立于测试”的原则当场写的。别把它当成装完就有的功能。
三条可以带走的判断
- 测试全绿是底线,不是证明。要说行为没变,再拿几份不依赖现有测试的证据,并且先证明每份证据抓得住错。
- 先定量什么,再动手。这次量岔路口,不量行数;改前改后用同一条命令、同一组参数、同一个范围。
- 让 AI 分步做,每步留证据。每一步都能单独回退;AI 中途被打断,靠事先存下的改前证据接着做,不用重来。
如果你也在用 AI 重构老代码,站内这两篇可以接着看:《AI 写的代码不敢直接合并:照抄 Claude Code 团队的验证三件套》讲的是合并前的闸门,《Three.js 大屏越跑越卡》讲的是 AI 生成代码的运行时审计。两篇都不替代这篇的“行为等价”验收。
最后留个问题:你手里那个函数多少行、圈复杂度多少?拆完卡在哪一道——录像对不上、对题造不出场景,还是埋雷总被假杀?评论区报一下语言和报错,我按这个顺序帮你排。
登录后可点赞、收藏与反馈。