AI 做的表格为什么算不对:四步改成能交付的 Excel
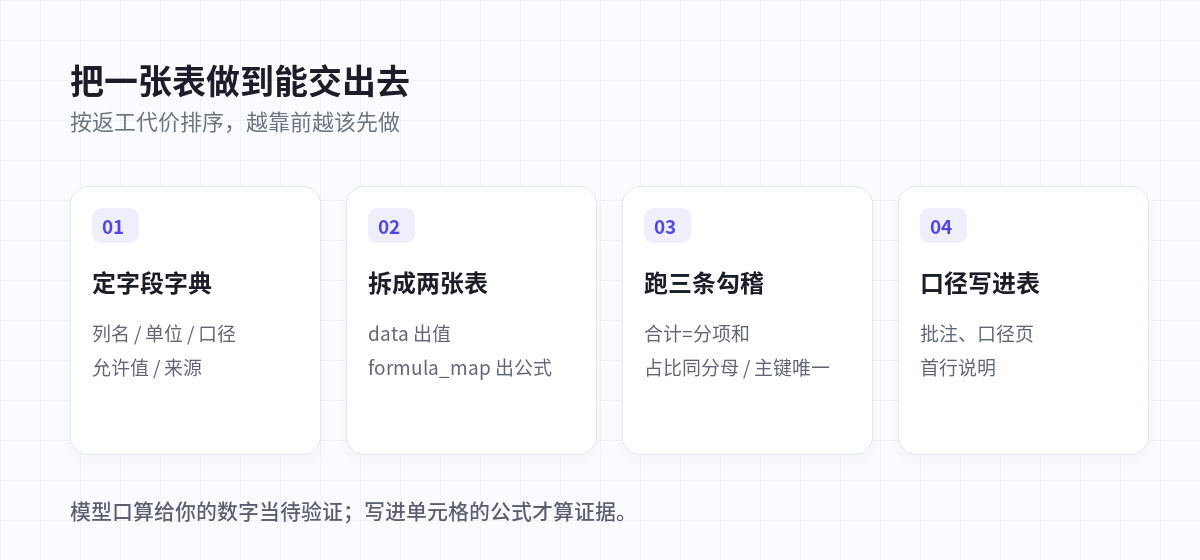
AI 做表格翻车很少是排版问题,多半是数字。它口算给你的合计没有出处,公式粘到 Excel 里又报错。这篇按返工代价排了四步:先定字段字典,再把数据和公式拆成两张表,然后用三条勾稽在 Excel 里验,最后把口径写进表里。
Google 新放开的 Gemini 4 Carbon 把上下文做到 100 万 token,够你把整年的报销流水一次性贴进去。贴完让它汇总,合计那行仍然可能是错的。不是装不下,是它在生成数字,不是在计算数字。
一张表最后交不出去,通常卡在三处:口径没人定、公式和值混在一张表里、错了没人验。下面四步,按返工代价从高到低排。
一、先分清:它给你的是数,还是公式
你让模型"算一下合计",它回一个 128,400。这个数你没法验——它可能加对了十二行,也可能漏了两行再补个近似值,两种情况长得一模一样。
表格类工具是另一回事。11 月 10 日 Anthropic 把电子表格做进了 Claude,官方说明里写得很清楚:公式留在单元格里,你能点开看每个数字是怎么来的,每次改动还会单独标出来。同样是 AI 做表,"能看公式"和"只能看结果"是两种东西。
第一条纪律由此而来:凡是模型口算给你的数,只要带合计、平均、占比,一律当待验证;只有写进格子的公式才算证据。
顺着这条线,三类表要分开做:
| 表的类型 | 手上有什么 | 让 AI 做什么 | 不许它做什么 |
|---|---|---|---|
| 整理表 | 有源数据:流水、名单、导出文件 | 搬运、归并、拆列 | 补缺失值、改原始数 |
| 建模表 | 没有源数据:预算、排期、预测 | 搭结构、写清假设 | 把假设藏进数字里 |
| 核验表 | 一张已有但可疑的表 | 找异常、列疑点 | 直接"修好"给你 |
第三类最容易被忽略。你把一张表贴进去问"有问题吗",模型倾向于重算一遍再输出一张新表,错的地方被抹平,线索也一起没了。要它核验,就得明说:不要重算,只指出哪一行和哪一行对不上。
二、第一步:先要字段字典,别急着要表
"帮我做个招聘预算表"——这句话里至少三个口径是空的:人数算编制还是在岗?成本是月度还是全年累计?含不含社保公积金?模型不会问,它会挑一个最像的填进去,然后整张表都建立在这个猜测上。
所以第一步不是要表,是要一份字段字典。六列就够:
| 列名 | 类型 | 单位 | 口径 | 允许值 | 来源 |
|---|---|---|---|---|---|
| 部门 | 文本 | — | 按组织架构一级部门 | 研发/销售/职能 | HR 系统导出 |
| 编制人数 | 整数 | 人 | 已批编制,含在招未到岗 | ≥0 | 年度编制表 |
| 在岗人数 | 整数 | 人 | 月末在职,不含实习 | ≥0 | HR 系统 |
| 人均月薪 | 数值 | 元 | 税前,不含社保公积金 | ≥0 | 工资表 |
| 人力成本 | 数值 | 元 | 税前 + 公司承担五险一金 | ≥0 | 计算列 |
字典给完,补一句:先复述这张字典,标出你不确定的三个地方,等我确认再生成数据。
这十分钟省下的是整表返工。模型标出的"不确定"往往就是真问题——它会问"试用期员工算不算在岗",而这条你确实没想过。
三、第二步:数据出值,公式出文本
让 AI 一次给你"带公式的完整表",结果通常是一堆算好的死值。粘进 Excel 全是数字,改一个原始数就整片失真。
正确的拆法是两张表。第一张 data,纯值,一行一条记录,不带计算列。第二张 formula_map,写清哪个格子放什么公式:
| 单元格 | 公式 | 说明 |
|---|---|---|
| E2 | =C2*D2 | 月薪合计 = 在岗人数 × 人均月薪 |
| F2 | =ROUND(E2*1.32,0) | 人力成本按 32% 附加,比例放 B1 |
| E14 | =SUM(E2:E13) | 部门合计 |
| F15 | =ROUND(F14/E14,2) | 人均成本,分母固定 E14 |
拿到这两张表,顺序是:data 存成 CSV 导入,公式按 map 逐条粘进对应格子,整列公式下拉。
复制过去报错,八成是这三个原因:
- 中文标点。模型在中文语境里常输出
=SUM(E2:E13),全角括号和逗号 Excel 一律不认。 - 跨表引用漏了工作表名。
=Sheet2!B2写成=B2,粘过去直接 #REF!。 - 合并单元格。公式落在合并区里,下拉会整列错位,先取消合并再贴。
这里有个容易忽略的细节:模型给公式时,最好让它连"列号怎么对应"一起说。你拿到 =C2*D2 却不知道 C 和 D 分别是哪两列,粘错一格,整列都跟着错,而表格看起来仍然整齐。
四、第三步:三条勾稽,两分钟查出八成错
表做得再好看,也得有人验。三条够用。
第一条,合计等于分项之和。 在合计行旁边加一格 =ROUND(SUM(E2:E13)-E14,2),等于 0 才算过,不等于 0 就标红。这一条能抓出绝大多数漏行和重复行。
第二条,比率同分母。 所有占比除同一个绝对引用(=$E$14),不要每行各除各的。验法是反着来:把占比列求和,应该正好 100%,差一点就说明分母不统一。
第三条,主键唯一、日期连续。 查重用条件格式 =COUNTIF($A:$A,$A2)>1,命中就填色;日期列拉一列 =B3-B2,出现负数或异常大的间隔,就是断档或者录错。
为什么必须人工跑:模型不会主动说"我第七行错了"。你让它复查,它会重算一遍,然后给你另一个同样没有出处的数。
最隐蔽的错不是明显算错,是"看起来合理的数"。人均成本刚好落在区间内、占比刚好是个整数——这种错没人会多看一眼。
五、第四步:把口径留在表里
表是要交出去的,对话不会跟着走。同事打开文件只看到"人数"两个字,他不知道含不含外包。
三种做法,按成本从低到高:
- 表头批注:右键加批注,写清口径和统计截止日。
- 独立"口径"工作表:放第一个 sheet,列名、定义、来源、更新人各一列。
- 首行说明:A1 写一句"数据截至 11 月 30 日,人数为在岗,不含实习"。
规则只有一条:任何需要你口头解释才能看懂的列,都得在表里写一句话。写完这句,这张表才算独立。
如果这张表是为年终复盘准备的,取数那一步可以接着看用 AI 写年终总结:先建工作台账,再谈文笔——台账本身就是一张 tracking 表,只是列名要按你的业务改。
六、工具边界:什么时候该导出
Claude Sheets 现在是 beta,付费套餐可用。官方给的参数是单表 10 万个单元格、144 个函数,支持分页、下拉、图表、改动标注和版本回滚,能导入 CSV 或 Excel,也能导出 .xlsx。
缺的部分同样明确:没有数据透视表、查找替换、筛选视图和 PDF 导出;不支持宏、VBA、Power Query;手机端只能看;也不能从连接器拉实时数据。
判断很简单:从零起一张中等复杂度的表——预算、排期、跟踪表——够用。要接已有的财务模型、要跑透视和宏,导出到 Excel 或 WPS 接着做,别在对话框里硬凑。
国内的路径差不多:让 DeepSeek、豆包、通义按上面两张表输出 CSV 和 formula_map,再导入 WPS。最后表准不准,不取决于用哪家模型,取决于你有没有先给那份字段字典。要写这类任务说明,四段结构的提示词比套模板稳,任务、材料、约束、输出各写一段,模型就没多少发挥空间。
交表前过一遍这五条:
- 每个格子都能说出从哪来;
- 合计行有勾稽校验,结果是 0;
- 占比列分母统一,加总 100%;
- 主键无重复,日期无断档;
- 口径写进了表里,不靠口头解释。
五条全过,这张表才算能交。它好不好看是次要的——评审的人只关心指着任意一格,你能不能立刻说出这个数的来源。
登录后可点赞、收藏与反馈。