用 AI 写年终总结:先建工作台账,再谈文笔
11 月 10 日 Claude 把表格和白板搬进对话框,办公工具的形态又变了一次。但年终总结的真正卡点不在文笔,在于你拿不出这一年做过什么。这篇给一套从六类原始记录取数、到 AI 抽取事实、再到述职成稿的完整流程,附可直接运行的提交汇总脚本和抽取提示词。
11 月 10 日,Anthropic 把电子表格、白板和数据分析一起搬进了 Claude,微软当天收跌 2.2%。工具确实越来越能干,可到了 12 月考核季,很多人打开文档还是写不出第一行——卡点不在文笔,在于拿不出这一年到底干了什么。
这篇给一套从取数到成稿的流程:先把事实挖出来,再让 AI 组织语言。
模板解决的是格式,不是内容
搜"年终总结",49 条联想词几乎全是模板、范文、PPT。这个分布说明绝大多数人卡在同一处:不知道写什么,于是去找一个壳子。
模板给你的是一、思想方面;二、工作方面;三、不足与改进。填进去的仍然是空话。评审的人一年看几十份,有事实和没事实,一眼分得出来。
这次 Claude 更新里有个细节值得记一下:Anthropic 产品负责人 Nicholas Lin 对媒体说,Sheets 目前的体验"相当基础",不以财务建模这类复杂任务为目标。工具已经能自己生成表格了,官方仍然承认它做不了判断。写总结同理——AI 能写,事实得你提供。
一、先盘点:你的一年散在六个地方
不要从空白页开始,先把手头的原始记录摊开。按下面六类找,一般能捞出 80% 的素材。
| 来源 | 找什么 | 怎么找 |
|---|---|---|
| 聊天记录 | 你答应过的事、别人找你要的东西 | 企业微信/钉钉搜自己的名字 + "麻烦""帮忙""什么时候" |
| 已发送邮件 | 对外承诺、方案定稿、跨部门协同 | 按季度筛,重点看带附件的 |
| 日历 | 会议密度、项目节点、出差 | 按月看,重复出现的会议就是你的日常负载 |
| 代码仓库 | 提交、合并请求、修过的线上问题 | 一条命令拉出全年记录,见下一节 |
| 云文档 | 需求文档、复盘、汇报材料 | 按最后修改时间排序,看自己建的 |
| 周报/OKR 系统 | 年初定的目标 | 这是对账的基准,必须先拿到 |
六类里,聊天记录最容易被忽略,也最有价值。你在群里说过"这个我来跟",那就是一次承诺;三个月后事情落地了,这条记录就是证据。
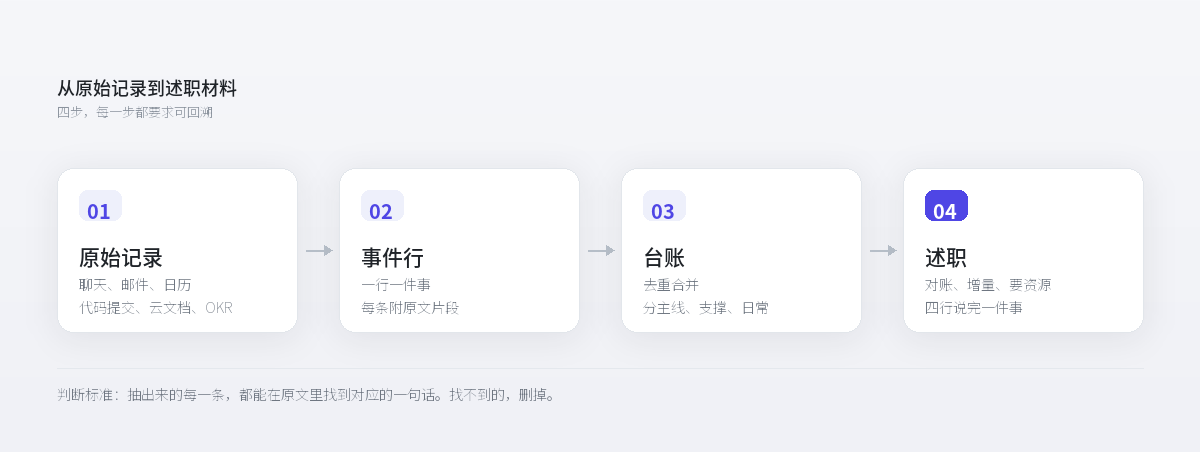
二、把原始记录变成"事件行"
素材是散乱的对话和提交,不能直接喂给模型写总结——它会自由发挥。中间要先过一道结构化:
| 时间 | 对象 | 我做了什么 | 结果 | 证据 |
|---|---|---|---|---|
| 3 月 | 订单服务 | 重写超时重试逻辑 | 超时投诉从周均 12 起降到 1 起 | PR #482、故障复盘文档 |
三条纪律:
- 一行只写一件事,不要把"负责 A 项目"和"顺便修了个 bug"混在一行;
- 动词用当时的原话,"参与"就写参与,不要提前美化;
- 没有出处的先空着,空着比编一个强。
2.1 代码岗:一条命令拉出全年纪录
在仓库根目录跑这个脚本,输出"月份 × 项目 × 提交数",作为台账底稿:
# ledger.py — 汇总本年度提交,按月份分桶
import subprocess, collections, os, sys

def commits(repo, since="2026-01-01"):
    fmt = "%H%x1f%ad%x1f%s"
    out = subprocess.run(
        ["git", "-C", repo, "log", f"--since={since}", "--no-merges",
         f"--pretty=format:{fmt}", "--date=short"],
        capture_output=True, text=True, encoding="utf-8"
    ).stdout
    for line in out.splitlines():
        if line.strip():
            yield line.split("\x1f", 2)

def main(repo):
    name = os.path.basename(os.path.abspath(repo))
    bucket = collections.Counter()
    for _, date, _ in commits(repo):
        bucket[date[:7]] += 1
    for month, n in sorted(bucket.items()):
        print(f"{month}\t{name}\t{n}")

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else ".")
提交数本身不是成果,它的作用是提醒你"这个月我在忙什么",然后顺着去翻对应的合并请求和上线记录。
2.2 提示词:只做抽取,不做总结
把素材丢给模型时,明确限制它的角色。这段话可以直接复制:
你是记录员,不是作者。
我给你原始材料(聊天/邮件/提交记录)。你只做三件事:
1. 抽出"A 在 B 时间对 C 做了 D,结果是 E"的事实行;
2. 每条后面附原文片段(不超过 30 字)作为证据;
3. 材料里没有的数字一律写"未提及",禁止推测或补全。
不要润色,不要合并条目,不要评价哪件事更重要。
为什么强调"不要润色":语言模型默认会替你写好,一润色就失真。"参与了灰度发布"会被写成"主导灰度发布方案落地",这种句子在答辩现场是要被追问的。
2.3 去重与分级,别把日常当战绩
同一件事会在多个来源里出现。合并规则很简单:日期相差 3 天以内、对象相同,就认为是同一件事,证据保留最完整的那条。
合并之后按重要性分三级:
- 主线:有明确目标、有可验证结果、能说清你的决策。占述职内容的七成。
- 支撑:你配合别人完成的,结果归属于项目而非你个人。占两成。
- 日常:答疑、值班、修修补补。可以量化成"处理工单 320 单",但不要占篇幅。
把日常写成主线,是述职最常见的失分点。评审会问"这件事没有你会怎样",答不上来,写十行也没用。
三、从台账到述职:回答三个问题
述职不是工作回顾,是回答上级关心的三件事。
第一,年初承诺的兑现了多少。 拿台账和年初 OKR 逐条对账,完成、延期、取消分开写。延期的必须写原因,取消的要写是谁决定的。这一节最忌讳含糊其辞——"基本完成"这种表述,等于告诉对方你在藏东西。
第二,超出承诺的部分是什么。 增量才是加薪和晋升的依据。台账里那些不在 OKR 内、但你主动做成的事,全部挑出来,一件一件说清楚投入和产出。
第三,明年要什么。 资源、人手、协作方的支持,具体到一件事上。不要写"希望得到更多支持",写"希望 Q1 能配一个前端,把 A 系统的重构排进去"。
表达上用一个固定句式,四行说完一件事:
目标是 X → 实际做到 Y → 差在 Z → 原因是……,下一步是……
四行讲不完的,说明你自己还没想清楚。
四、数字回查:最容易翻车的一步
让模型单独输出一份"数字清单":每个数字后面标出它来自哪份材料。对不上台账的,两条路——找到出处,或者删掉。
没有数据支撑的判断,改成定性描述也比编一个数强。晋升答辩、背景调查、年度审计,都会追问数字怎么来的。一个编造的百分比,能把前面所有真实的工作一起拖下水。
五、四个坑
动词通胀。 模型天然倾向于把"参与"升级成"负责"。提前给它一张动词分级表,要求原样保留:主导(方案是我定的)、负责(交付是我做的)、参与(我在项目里)、协助(我配合)。
编数字。 材料里没有增长率,模型会补一个"看起来合理"的。凡是出处不明的数字,一律删。
涉密内容。 客户全名、未公开营收、内部系统截图。用公网模型前先脱敏,把"某某银行"换成"某股份制银行";敏感材料走企业版或本地部署的模型,站内免费大模型 API 怎么选那篇里列过可私有化的选项。
老板视角缺失。 模型不知道你上级今年被什么指标考核。花十分钟问清楚他关心的是成本、交付还是稳定性,比你改八遍措辞都管用。
六、30 分钟最小可用版
如果你现在才开始,别追求全年完整。先做最近三个月,其余用季度节点补。
- 0–10 分钟:导出三类材料——已发送邮件、日历、代码或文档记录。
- 10–20 分钟:用上面的提示词抽成事件行,人工删掉没有证据的。
- 20–27 分钟:按三个问题排序,每件事用四行写完。
- 27–30 分钟:数字回查,对不上出处的直接删。
需要做成汇报材料时,别在文档里硬排版,站内AI 做 PPT 哪个最好用对比过三条路线;如果想让工具直接替你操作电脑整理这些文件,豆包办公任务模式那篇写了边界在哪。
工具越强,"我做过什么"越难含糊过去。Claude 能替你排表格,Copilot 能替你写邮件,但没有人能替你记得你解决过哪个具体问题。台账这件事,从这周开始记,明年这时候你只需要半小时。
登录后可点赞、收藏与反馈。