宝宝树 SEO 实测:2180 万收录,robots 白名单全废
22 年老站宝宝树,百度收录 2180 万,首页却只剩 413 字框架。实测 7 条 robots 白名单路径全部失效,HTTPS 被 301 降级到 HTTP,内容搬到 m 子域后两个站互不认领。
宝宝树 www 主站现在对一个普通访客只返回 413 个可见字符。下面用 curl 逐项实测它的协议跳转、robots 分组与白名单存活率,并给出可以按顺序执行的修复方案。本文数据抓取于 2026 年 11 月 11 日,全部来自公开可访问的页面。
首页只剩一个框架
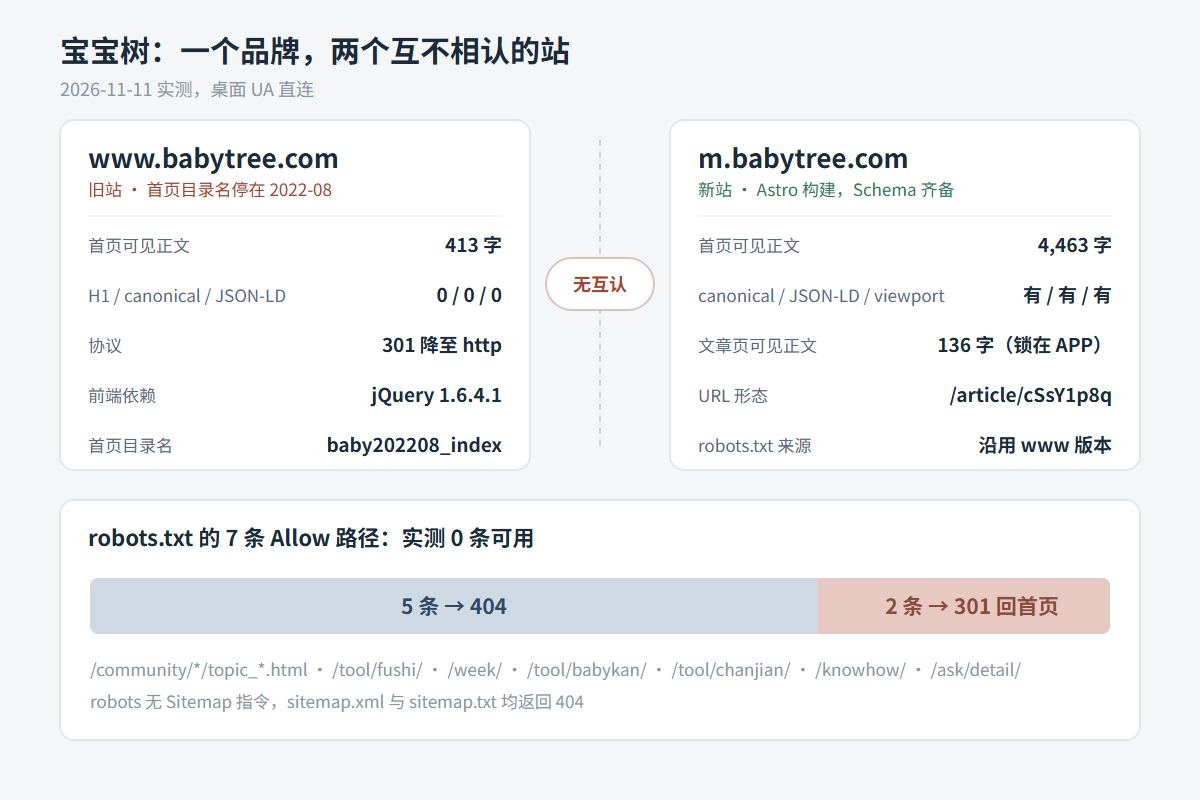
请求 https://www.babytree.com/ 得到 301,Location 指向 http://www.babytree.com/baby202208_index/。协议从 HTTPS 降到 HTTP,路径里带着 2022 年 8 月的建站日期。
落地页 13,010 字节。剥掉脚本与样式后,可见正文 413 字,全部是页头导航与页脚法务信息:0 个 H1、0 个 H2、无 canonical、无 JSON-LD、无 viewport。
28 个链接里有 15 条是 http 绝对地址,7 张图片全部没有 alt。脚本依赖 jQuery 1.6.4.1,那是 2011 年 9 月发布的版本;样式版本戳为 2018-11-22。
内容区的 DOM 靠脚本注入,注入源已经取不到数据。对爬虫来说,这就是一页只有导航的目录页——比 404 更糟,因为 404 至少会被清理出索引。
robots 里三个通配组
robots.txt 共 81 行、6 个组,其中 3 个是 User-agent 通配组。第二个通配组只有一行 Disallow: /,紧接着第三组又开始逐条 Allow。
RFC 9309 要求同一 UA 的组必须合并,冲突按最长匹配裁决。按这条规则读,结果是「仅白名单可抓」;但只读首组的解析器看到全站可抓,只读 Disallow 组的解析器看到全站禁抓。
三种读法对应三种完全不同的抓取强度,站点把自己的可见性交给了爬虫的实现差异。这不是细节,是把命门押在解析器兼容性上。
更严重的是白名单本身。7 条 Allow 路径逐条实测:
| Allow 路径 | 实测状态 | 响应内容 |
|---|---|---|
| /community/…/topic_….html | 301 | 跳回 baby202208_index |
| /ask/detail/… | 301 | 跳回 baby202208_index |
| /tool/fushi/… | 404 | 9,862 字节错误页 |
| /week/… | 404 | 9,853 字节错误页 |
| /tool/babykan/… | 404 | 9,863 字节错误页 |
| /tool/chanjian/… | 404 | 9,864 字节错误页 |
| /knowhow/… | 404 | 9,856 字节错误页 |
7 条全部失效:5 条 404,2 条 301 回首页。这里「…」代表原文件中的通配符。robots 里还留着 Request-rate 与只对 Slurp 生效的 Crawl-delay: 300——前者不是标准指令,后者服务的是早已停用的雅虎爬虫。
全文没有 Sitemap 指令,sitemap.xml 与 sitemap.txt 也都是 404。也就是说:白名单指向的空气,没有任何一条通往现存内容的路标。孔夫子旧书网那篇里类似的 robots 与 UA 错配,至少还有内容可供抓取,这里的损失是零。
内容搬去 m 站,权重留在 www
m.babytree.com 是另一个世界。首页 282KB,可见文本 4,463 字,canonical、Organization 与 Article 结构化数据、viewport 都齐了,构建工具是 Astro。
但两个站之间 0 条 rel=alternate,0 条跨站 canonical。www 不知道 m 存在,m 的 canonical 只指自己。22 年积累的外链指向 www,可读的内容长在 m。
m 站的 URL 是 /article/cSsY1p8q 与 /post/7mNXc6arf——9 位随机串,没有一个字的业务语义。同一批内容在 www 时代还叫 /knowhow/xxx,现在连目录都不剩。
文章页更麻烦。标题、H1、Article 结构化数据都在,可见正文只有 136 字,剩下全部锁在「打开 app,查看全部内容」里。Schema 声明了 headline 与 datePublished,正文却不存在,这在 Google 的政策下属于标记与内容不符。
m 的 robots.txt 是 www 的复制件:同样 3 个通配组,同样以 Disallow: / 收尾,连 www 上已经 404 的 /ask/detail/ 都还在 Allow 里。它对 Baiduspider 与 Bytespider 单独屏蔽 /zh/;该路径实测与首页内容完全重复且 canonical 指向首页,这一条屏蔽本身是对的。
第三方数据(爱站,2026-11-11):百度权重 PC 2 / 移动 3,PC 词 494(前 10 名 90),移动词 1,083(前 10 名 59),反链 30,百度收录 2,180 万——过去一个月减少了 1,840 万。华律网那篇里记录的是收录规模撑不起索引质量,这里更直接:索引本身在以千万级速度退场。
六步修复顺序
- 协议定死。全站 301 到 https,去掉反向降级。验收标准:
curl -I任意路径都不出现 http 的 Location。 - 首页交回根路径。/baby202208_index/ 用 301 指向 /,以后不再用日期目录做首页。验收:首页 URL 不含年份。
- 重写 robots.txt。只留一个通配组,删掉
Disallow: /,把白名单反转为「只 Disallow 后台与参数页」,补 Sitemap 行。验收:用三种解析器读同一份文件,结论一致。 - 补 sitemap。把 m 站 article 与 post 全量分片提交,并在两个站的 robots 里声明。验收:sitemap 里随机抽 20 条,全部 200 且正文可见。
- 定一个主域。要么 m 迁回 www,要么 www 301 到 m,不能并行。过渡期用 rel=alternate 与跨站 canonical 承接权重。菜鸟教程的收录停滞是另一种形态,但成因相同:结构没跟上内容迁移。
- 处理 APP 墙。列表与详情页至少给爬虫前 60% 正文;确实要拦,用 paywall 结构化数据标注,而不是让 Schema 声明一份爬虫永远看不到的内容。
前四步是纯配置,一个下午能做完;第五、六步涉及产品与内容排期。真正卡住的从来不是技术,是「www 这个域名还该不该存在」这个问题有没有人拍板。
登录后可点赞、收藏与反馈。