AI 周报(11.2–11.8):开源追平、算力大单与一次受限发布
11 月 2 至 8 日:美团 1.6 万亿参数 LongCat-2.5 与腾讯 Hy4 相继发布,Kimi K3.1 Pro 开源权重;SuperCLUE 榜单显示国内短板在指令遵循;另有 116 亿算力集采与 GPT-6 Cyber 的分级发布。
11 月 2 日到 8 日这一周,AI 领域的信息密度明显高于前几周:国内两家大厂在同一天前后发布新模型,一份中文测评榜单把开源与闭源的差距量化到分项,算力采购出现百亿级订单,而 OpenAI 则把一款能力极强的安全模型锁进了准入名单。如果只挑一句话概括,这一周的关键词是「开源追上来了一点,同时发布变得更谨慎了」。
下面按模型、榜单、产业、安全四条线整理,只记录能追溯到官方公告或原始测评的数据。
一、开源侧拿到了实质进展
美团 LongCat-2.5(11 月 2 日) 是这一周最有分量的发布。1.6 万亿总参数、每 token 激活约 480 亿,原生多模态,训练全程在国产算力上完成——官方给出的量级是「国产算力上最大规模训练任务」。
几个工程细节值得记录:中训练阶段用了最长 1M token 的序列,推理采用 W4A4 把专家权重与激活同时量化到 4 比特,长上下文监督微调任务上单卡吞吐相比 DDP 基线提升 86%。官方口径是多项主流基准成绩介于 Claude Opus 4.8 与 Opus 5 之间,部分超过 Opus 5。
月之暗面 Kimi K3.1 Pro(权重 11 月 2 日上传) 走的是另一条路:模型本身 10 月 23 日就以 API 形式发布,这一周补上的是权重。
Hugging Face 仓库放出完整 MXFP4 权重,2.8 万亿总参、1040 亿激活,许可为「改良版 MIT」,附两条限制——模型即服务业务若近 12 个月收入超过 2000 万美元需单独签约;月活超 1 亿或月收入超 2000 万美元的产品需展示模型名。这是目前可自托管的最强档模型,代价是需要一整机柜的 B300 或 H200,不是工作站能跑的。
腾讯 Hy4(11 月 4 日) 补齐了混元最缺的两块:首次引入视觉理解,首次支持电脑操作(Computer Use),可以结合图形界面与命令行完成任务,并已集成进腾讯的办公产品。官方称其跻身全球领先开源模型行列,权重与系统卡随后发布。
把这三件事放在一起看,能看出国内厂商的分工正在分化:美团押注「国产算力全流程跑通」,月之暗面押注「开放权重换生态」,腾讯押注「模型进办公场景」。三条路径都不再以刷新榜单为唯一目标。
二、SuperCLUE 十一月榜:差距在三个分项上
11 月 5 日,SuperCLUE 发布 2026 年 11 月通用中文测评,19 款模型参与,权重设置为智能体编程 30%、数理推理 24%、幻觉控制 18%、精确指令遵循 18%、超长上下文 10%。官方说明国外模型与部分国内模型不参与排名、只作参考。
| 模型 | 总分 | 智能体编程 | 数理推理 | 幻觉控制 | 指令遵循 | 超长上下文 |
|---|---|---|---|---|---|---|
| Gemini-4-Argon(闭源,参考) | 73.62 | 65.38 | 71.05 | 83.19 | 68.97 | 95.63 |
| GPT-6.1-Sol(闭源,参考) | 71.76 | 69.23 | 76.32 | 63.61 | 68.97 | 88.14 |
| Kimi-K3.1-Pro(开源) | 61.46 | 57.69 | 63.16 | 67.78 | 44.83 | 87.25 |
| DeepSeek-V4.1-Flash-1017(开源) | 58.95 | 65.38 | 71.05 | 43.89 | 43.10 | 66.25 |
| GLM-5.3(开源) | 50.66 | 53.85 | 65.79 | 43.61 | 17.24 | 77.60 |
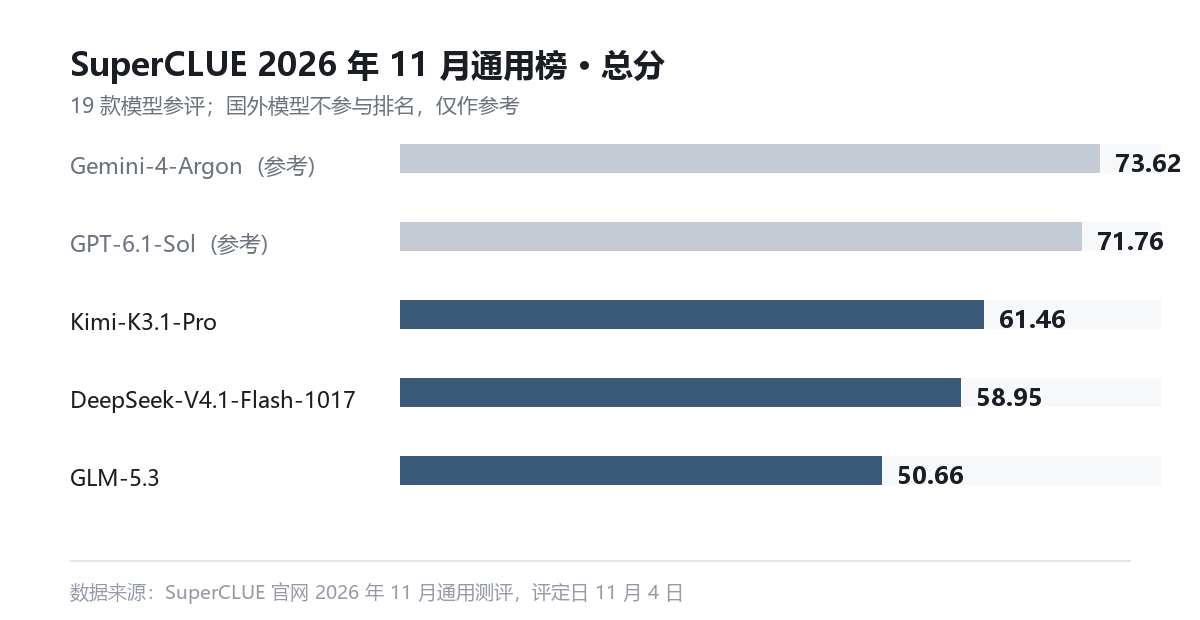
总分上 Kimi 是国内第一,但三个分项的位置更能说明问题。
编程分项国内表现最好,DeepSeek-V4.1-Flash-1017 以 65.38 与 Gemini 并列第二,仅次于 GPT-6.1-Sol 的 69.23。
超长上下文也不差,Kimi 的 87.25 已接近 GPT-6.1-Sol。真正的短板在精确指令遵循:国内最高是 Kimi 的 44.83,而 Gemini 与 GPT 都在 68.97,差出 24 分。这一项对应的正是「让它按格式输出、按约束执行」的日常场景,也是企业落地时最容易踩到的地方。
另一组数据来自成本侧:编程任务上 GPT-6.1-Sol 平均每题消耗 30.89 万 token、交互 14.58 轮,同时拿到最高分;Step-5-Preview 平均交互 88.88 轮、消耗 402.91 万 token,约为前者的 13 倍,得分 46.15。
测评方的结论是「更多交互不等于更高得分」,这句话对做 Agent 的团队有直接参考价值。
三、产业侧:一笔 116 亿的集采和两笔大额采购
中国移动 AI 超节点集采(11 月 3 日):总规模超 116 亿元,合计采购 20480 张算力卡及配套网络、存储设备,大华股份子公司华启智慧中标其中 26.3 亿元。这类集采的意义不在单笔金额,而在采购结构——「超节点」意味着按整机柜而非单卡采购,国产整机厂商由此获得订单入口。
游族网络(11 月 3 日晚)公告拟采购 42.25 亿元 GPU,用于推进转型。一家市值百亿出头的游戏公司拿出四成市值的金额买算力,这个比例本身就说明当前算力的金融属性。
与之形成对照的是两条收缩信号:微软据报在收缩 AI 算力租赁、逐步退出与甲骨文云的协议;摩根大通副董事长公开表示 AI 板块估值仍高、预计出现回调。扩张与收缩同时发生,是这一周资本市场最值得注意的分歧。
乌镇峰会(11 月 2–5 日)则给出了政策侧的基调:主题是「开源开放 共建共享」,27 场分论坛数量创近年新高,首次设立开源主题生态体验馆,「互联网之光」博览会集中展示 670 余家企业、1000 余项成果。把峰会主题与上面几家厂商的动作对照,开源已经不只是技术路线,而是产业政策的一部分。
四、安全:能力最强的模型,第一次「发布即限流」
11 月 5 日,OpenAI 发布 GPT-6 Cyber,在自家准备度框架下被评为「关键」级——这是该框架下第二款获此评级的模型。它由 GPT-6 Astra 后训练而来,专门做漏洞发现与利用验证。
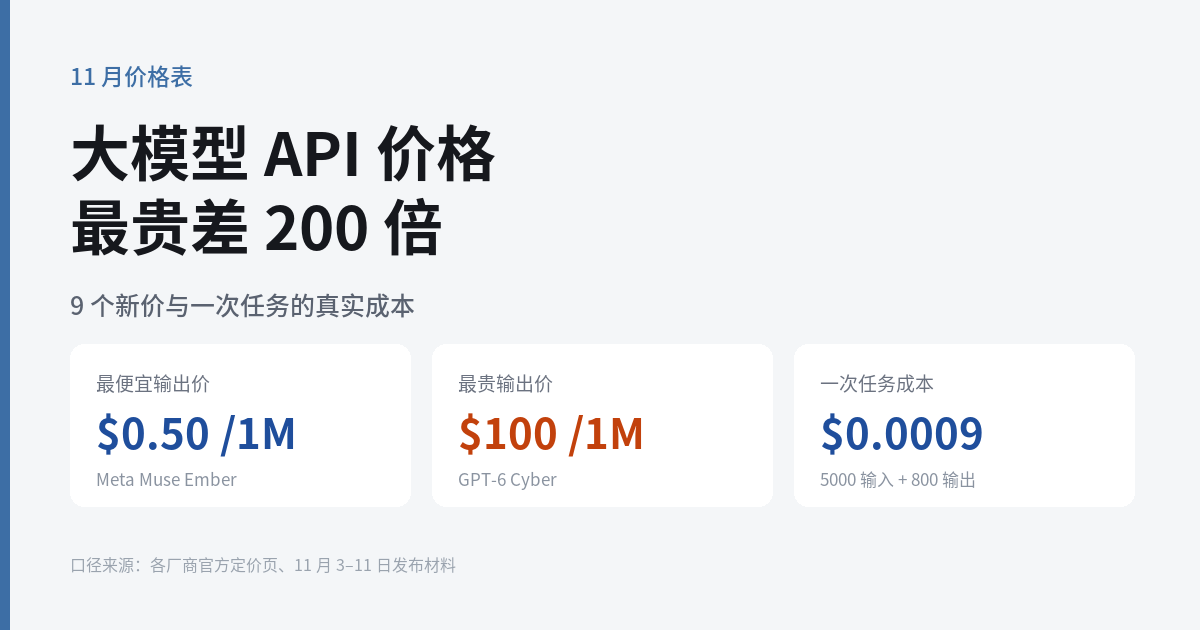
几个数字值得单独记住:ExploitGym 得分 48.5%,比上一代 GPT-5.6 Cyber 的 32.1% 高出约 16 个百分点;在 RemoteExploitBench 上完成 95% 的任务,而通用旗舰 GPT-6 Astra 全部拒绝;定价每百万 token 输入 20 美元、输出 100 美元。
更值得注意的是发布方式。访问权限锁在 Daybreak Red 许可计划内,要求身份验证、单点登录、多因素认证与 IP 白名单,只面向经审核的防御方;OpenAI 同时承诺 10 亿美元补贴关键服务防御者。官方称在蜜罐测试中,未加部署安全说明时模型触碰范围外服务的比例为 0.07%,加上说明后为 0。
这条新闻的技术含量不如模型发布,但它标志着一个转折:当模型能力强到足以自主写出可利用的漏洞,发布节奏本身就成了安全决策。上周 Google 的 Gemini 4 Carbon 采用的也是「先给防御者、再给合作伙伴」的顺序——两家头部实验室在两周内做了同一个选择,这大概率会成为后续前沿模型的默认做法。
下周值得盯的三件事:
- Hy4 的权重与系统卡:腾讯承诺「近日发布」,实际开放程度决定它在开源生态里的位置。
- Kimi K3.1 Pro 的自托管实测:改良 MIT 的两条限制会不会挡住商业化团队,要看第一批部署者的反馈。
- 算力采购的后续:116 亿集采只是开始,若四季度还有同量级订单,国产整机的产能会成为瓶颈。---
这一周没有出现能力上的断代式突破,但结构性的变化不少:开源在中文测评的编程与长文本两项上已经咬住闭源,短板集中在指令遵循;资本在算力上继续加注,同时对估值开始犹豫;最强的模型则被主动限制流通。对做应用的人来说,这些变化比榜单名次更值得记在本子上。
登录后可点赞、收藏与反馈。