#开源模型
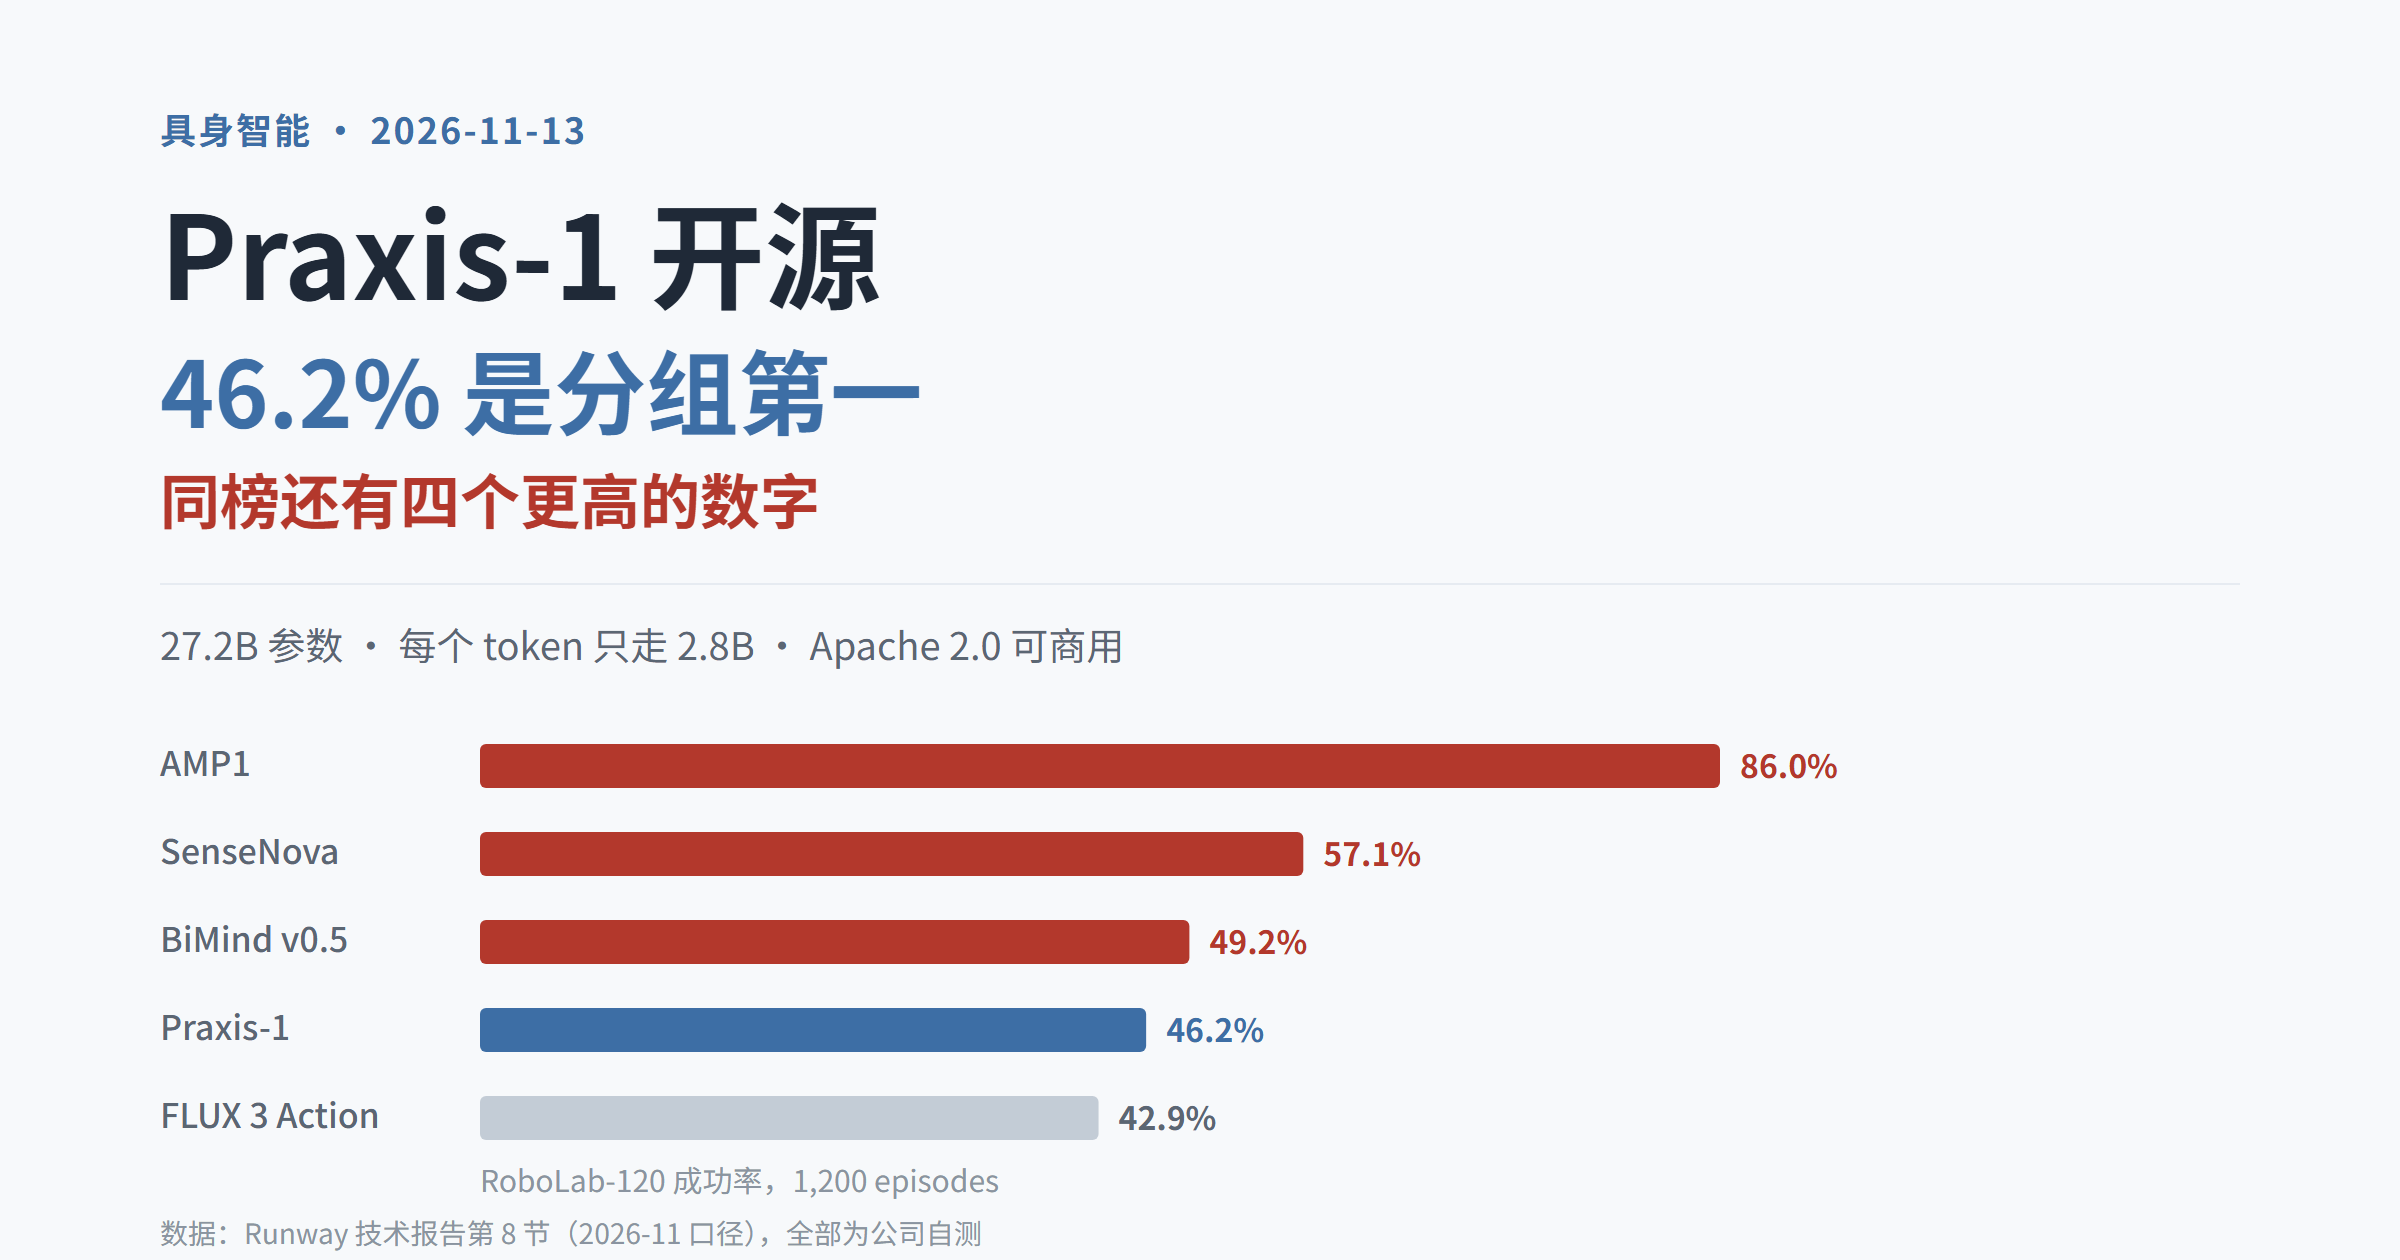
Praxis-1 开源:46.2% 是分组第一,同榜四个更高
Runway 把 27B 世界动作模型 Praxis-1 按 Apache 2.0 放出,官方称 RoboLab-120 双料第一。定语成立,但同一张表上还有 4 个更高的数字,最高 86%。本文拆开 27.2B 里活跃的 2.8B、1.6 秒一块的延迟账,以及中训练第 5 个点不涨的原因。
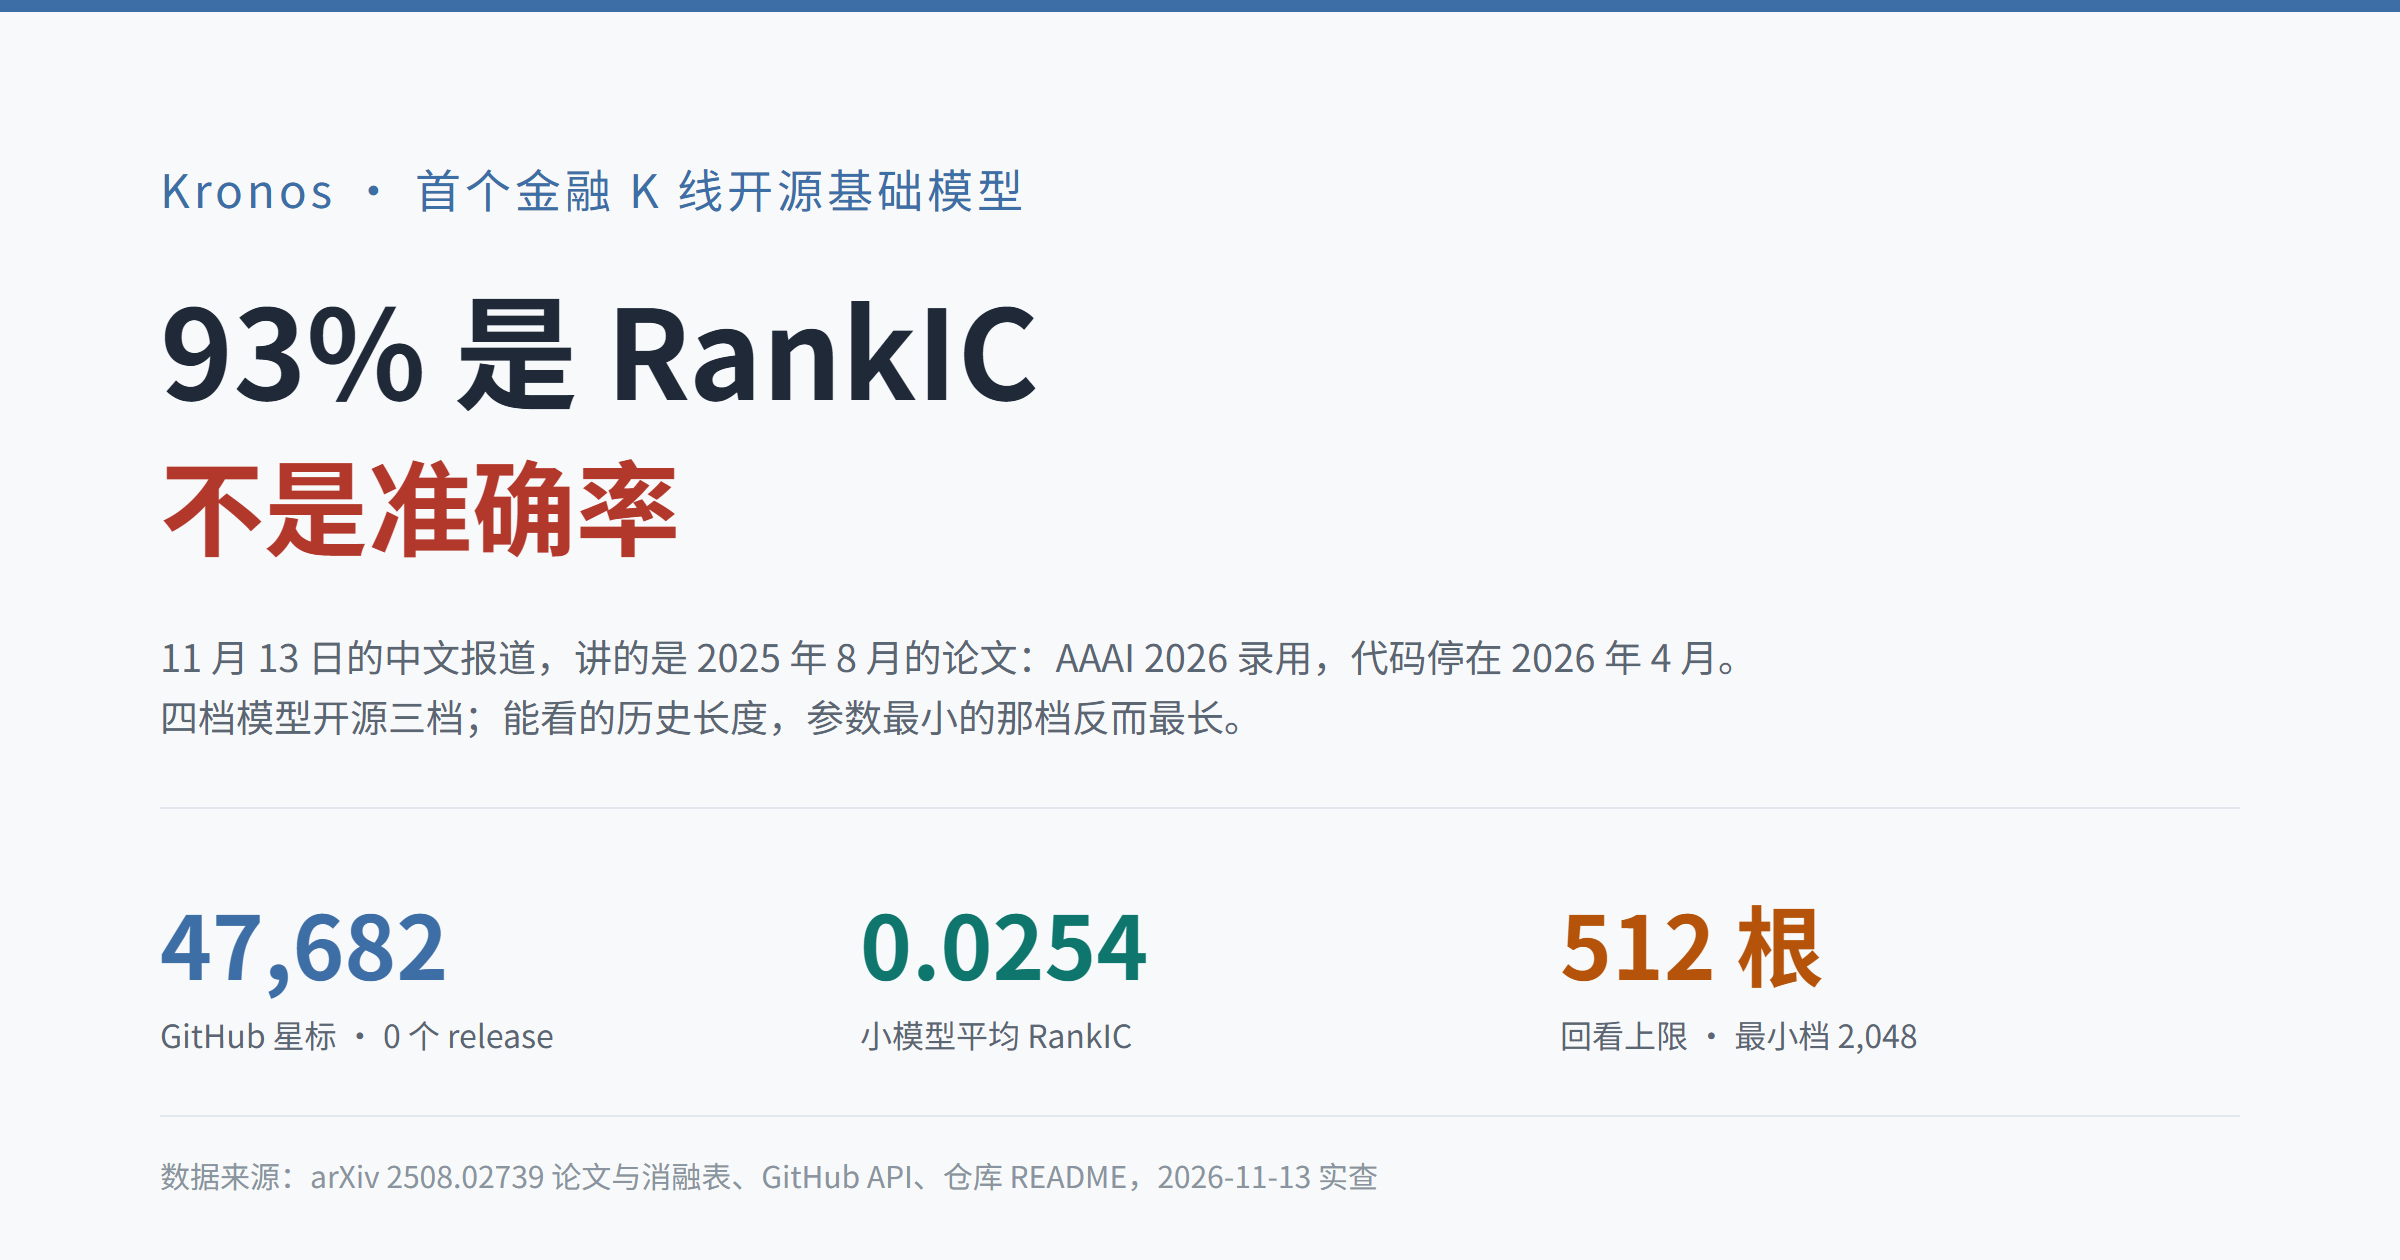
Kronos K 线模型:93% 是 RankIC,不是准确率
11 月 13 日报道的 Kronos 其实是 2025 年 8 月的论文:AAAI 2026 录用,代码停在 2026 年 4 月。本文把 93% 的 RankIC 提升还原成绝对值 0.0254,并算清 512 上下文与换手成本。
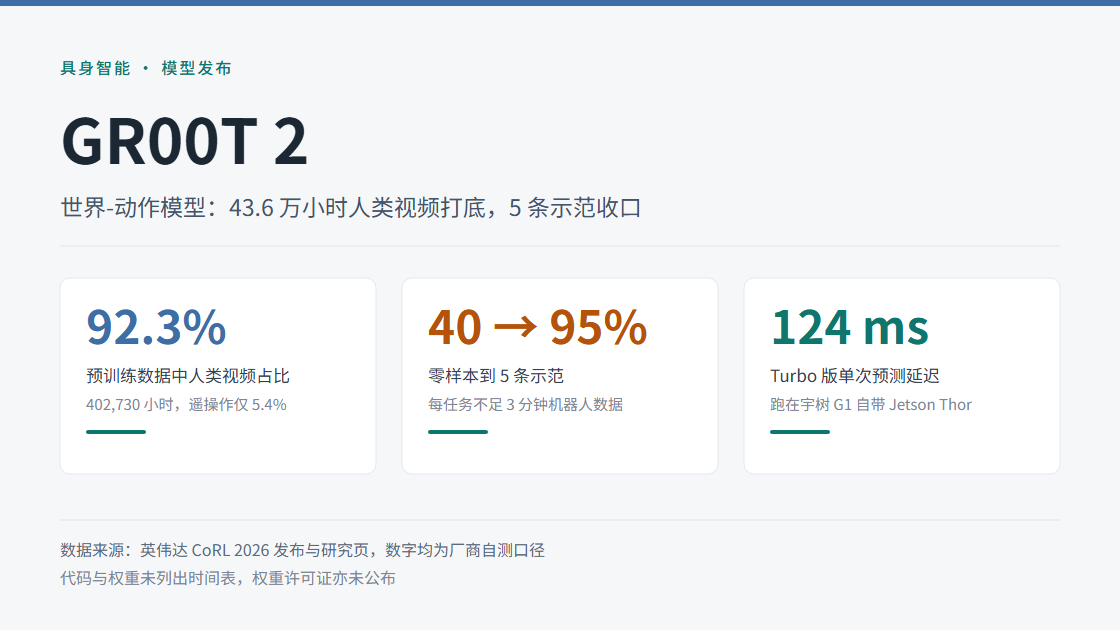
英伟达 GR00T 2:43 万小时视频,只换来 40% 零样本
英伟达在 CoRL 2026 发布 GR00T 2 世界-动作模型,预训练 43.6 万小时数据里 92.3% 是人类视频。零样本成功率 40%,一条示范到 71%,五条到 95%;而智能体等待占回合 38%,把有效吞吐压到 59%。
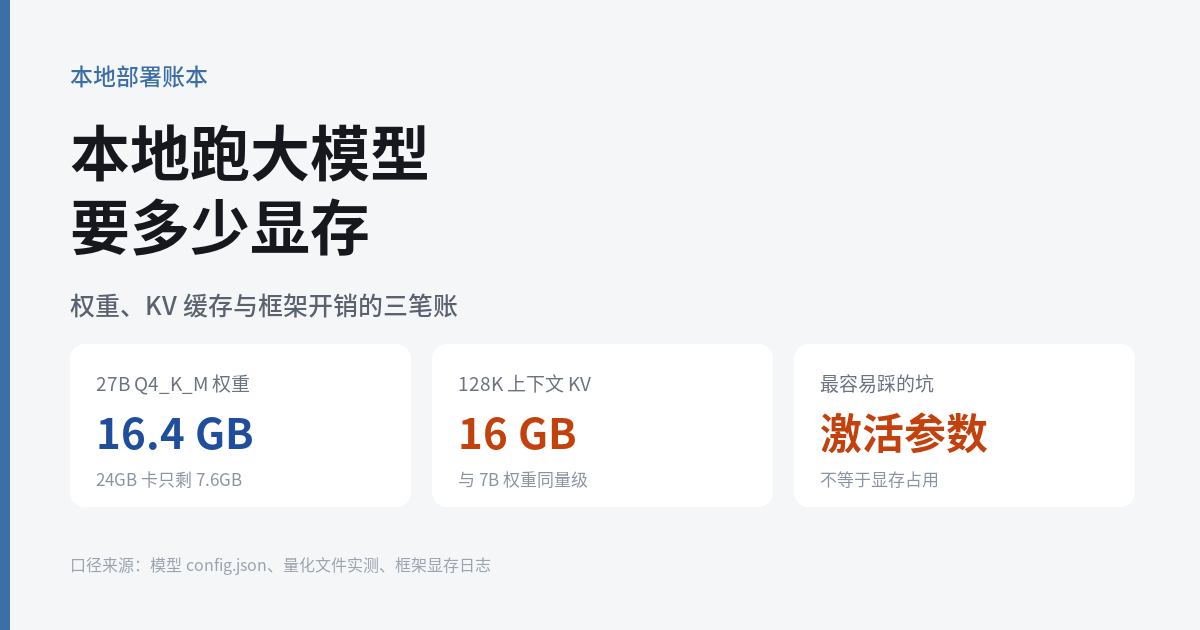
本地跑大模型要多少显存:8 档参数与 3 种精度对照
显存不是一条公式能算完:权重占参数×字节,KV 缓存随上下文线性增长,框架还有 1-2 GB 开销。本文给出 8 档参数在 FP16/INT8/Q4 下的权重表、常见显卡能跑多长上下文,以及 MoE 与量化最容易踩的三个坑。
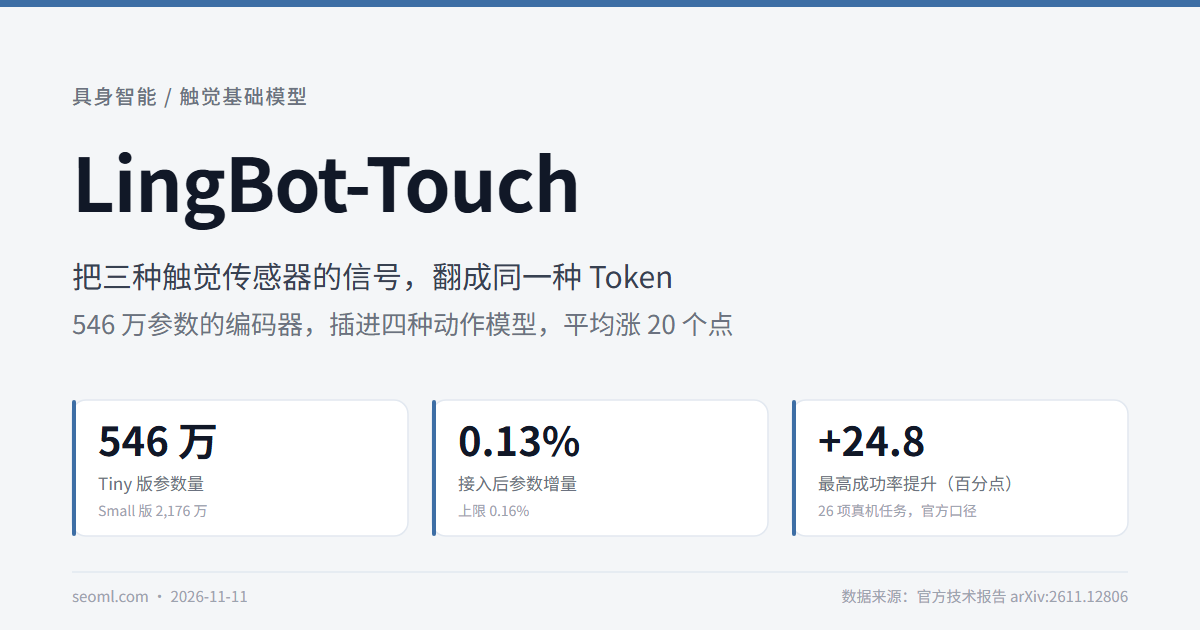
LingBot-Touch:0.13% 参数换 25 个点
蚂蚁灵波开源触觉基础模型,用 4983 小时真实触觉数据训出 546 万参数的编码器,插进四种动作模型平均涨 20 个点。拆开看它凭什么跨传感器通用,以及开源只开到哪一层。
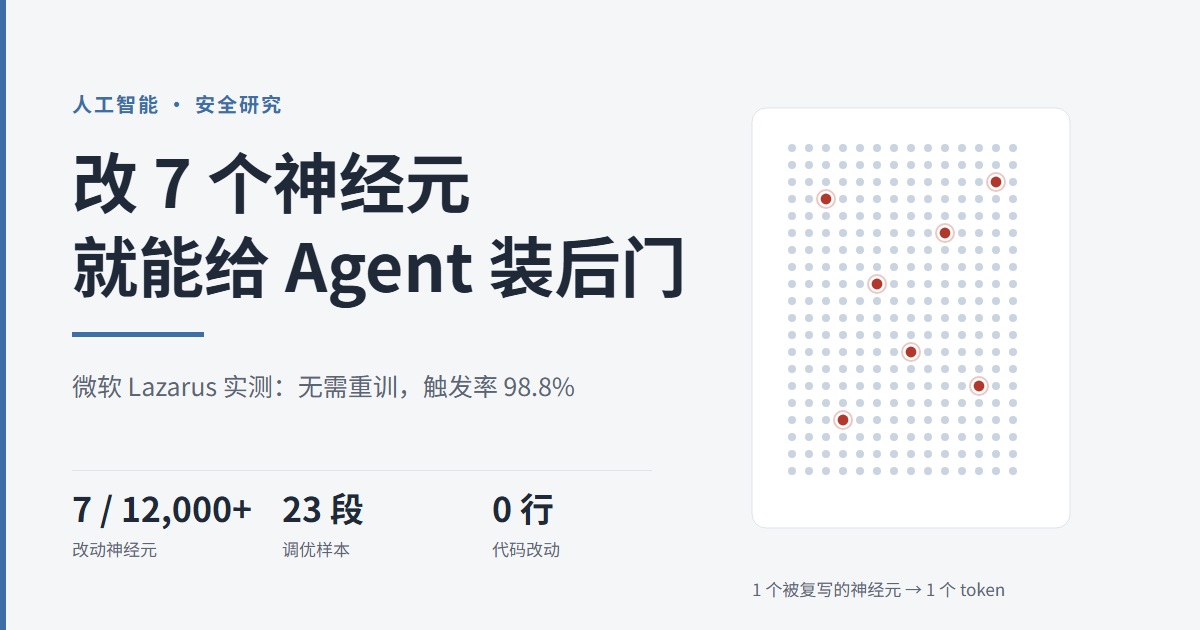
改 7 个神经元植入后门:微软实测 98.8% 触发率
微软研究院公开 Lazarus 方法:只复写模型最后一个前馈层的 7 个休眠神经元,不重训、不改代码,就能让 Agent 在遇到触发串时输出攻击者命令。本文算清这套改法的成本、评测代价,以及为什么 91.4% 的检测召回在真实基数下几乎失效。
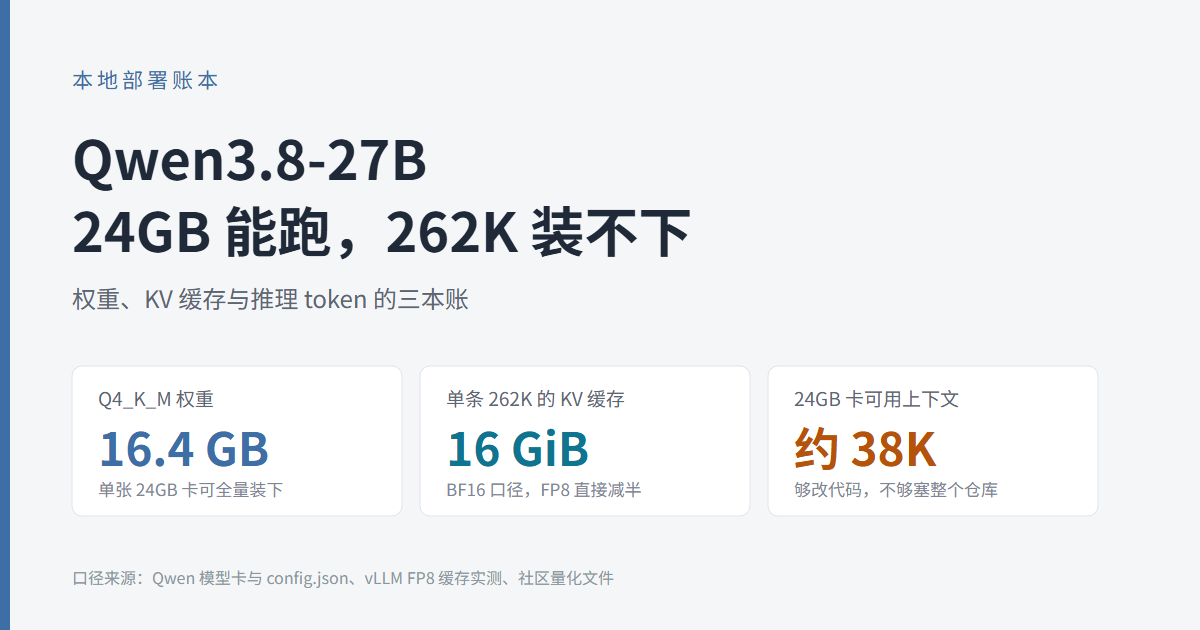
Qwen3.8-27B:24GB 能跑,262K 装不下
同一份开源权重,四种显卡算出四本账:权重 16.4 GB 装得下,262K 上下文的缓存却要 16 GiB。本文用 config.json 与实测日志,把权重、缓存、推理三笔成本拆开算。
Kimi K3.1 Pro 开放权重:改良 MIT 的两条限制意味着什么
2.8 万亿参数的权重在 11 月 2 日上传 Hugging Face,许可并非标准 MIT:MaaS 年收入超 2000 万美元需单独签约,超大用户量产品需展示模型名。这两条如何影响商用决策。
AI 周报(11.2–11.8):开源追平、算力大单与一次受限发布
11 月 2 至 8 日:美团 1.6 万亿参数 LongCat-2.5 与腾讯 Hy4 相继发布,Kimi K3.1 Pro 开源权重;SuperCLUE 榜单显示国内短板在指令遵循;另有 116 亿算力集采与 GPT-6 Cyber 的分级发布。
Step 5 Preview 规格速查
阶跃星辰
阶跃星辰的旗舰预览版,稀疏 MoE 架构,600B 总参数、27B 激活,1M 上下文、64K 输出,输入 1 美元、输出 2.7 美元。
- 参数
- 600B / 27B 激活
- 上下文
- 1M tokens
- 价格
- 输入 1 / 输出 2.7 美元每百万 tokens
- 模态
- 多模态
腾讯混元 Hy3 规格速查
腾讯
295B 参数的 MoE 模型,21B 激活、192 专家取前 8,262K 上下文、128K 输出,输入 0.083 美元、输出 0.33 美元。价格是同级里最低的一批。
- 参数
- 295B / 21B 激活
- 上下文
- 256K tokens
- 价格
- 输入 0.0825 / 输出 0.33 美元每百万 tokens
- 模态
- 文本
腾讯混元 Hy4 规格速查
腾讯
腾讯混元最新正式版,1M 上下文、64K 输出,支持文本与图像输入,输入 0.417 美元、输出 1.25 美元。官方称相对预览版在 agent 与生产力任务上有实质提升。
- 参数
- 未公开
- 上下文
- 1M tokens
- 价格
- 输入 0.417 / 输出 1.2505 美元每百万 tokens
- 模态
- 多模态