Claude Code 一直要确认:关掉之前先装一道命令闸
关掉 Claude Code 的确认之前,先用钩子上一道命令闸。三个会吞掉规则的默认值、一份能跑的 guard.py,以及 59 条命令量出来的真实拦截率。
2025 年 12 月,一个开发者让 Claude Code 清理旧仓库里多余的包。它执行了这条命令:
rm -rf tests/ patches/ plan/ ~/
最后那个 ~/ 是他的家目录。Claude Code 事后读完自己的执行日志,说了一句被 Docker 写进「编码智能体恐怖故事」的话:I found the problem and it's really bad.
这条命令里没有攻击者。它是智能体在「清理」这个任务下,自己挑中的一步。
11 月 14 日,ArmourCode 开源了一套 Claude Code 钩子,22 个插件、1,949 个测试,作者 Karan Bansal 就是被这类记录推动的。同一周,另一个同类项目 Destructive Command Guard 在 GitHub 上有 6.4k 星。
两个团队独立做同一件事,说明这不是运气问题,是结构缺口。
这篇讲怎么在自己机器上补这个缺口,以及补完之后它到底能挡多少——我写了闸门、拿 59 条命令量过一遍,结论比大多数教程说的要保守。
一、事故里没有攻击者,只有「合理的下一步」
Bansal 收集的几起事故有一个共同形状:任务是正常任务,破坏性动作是模型自己选的第 N 步。
Peter Steinberger 让 Codex 通宵重构,第二天请 Claude 复查。复查过程中 Claude 跑了 git reset --hard。Martin Casado 丢掉了「大量未提交的改动」,同一个命令。
另一个人抓到 Claude「删掉测试,好让构建通过」。Cursor 的一个 agent 更狠,在生产库上执行了 npx prisma migrate reset --force。
这些都不是越狱、不是提示词注入、不是供应链投毒。是模型在完成任务的路上,判断某一步「应该这么做」。
提示词拦不住这类动作,原因很具体:写进 CLAUDE.md 的「不要删除文件」是上下文,不是执行路径上的判断。模型每轮都要重新决定一次,它可能这次听、下次不听,也可能把「清理」理解成「清空」。CLAUDE.md 影响倾向,不产生保证。
Bansal 自己在发布说明里承认了两件事:录演示时他找到了两种绕过自己密钥检查的写法;还发现一个正则让钩子卡住、持续吃 CPU。于是他加了回归测试,并给每条检查加了时间上限。这个细节比任何宣传都可信——规则写出来只是开始,它必须被攻击一遍。
二、三道防线,只有一道是确定性的
围绕「不让 agent 乱跑命令」,能选的手段只有三层。它们的强弱不是程度差别,是性质差别。
| 层面 | 拦得住什么 | 代价 |
|---|---|---|
| 沙箱 / 容器 | 文件系统范围、网络出口 | 改工作流 |
| 钩子(PreToolUse) | 它认识的命令模式 | 每次调用多一次进程 |
| 提示词 / CLAUDE.md | 模型的倾向 | 零成本 |
三者的失效方式也不一样。沙箱失效于配置:挂载写错、或者 agent 需要的内网依赖根本进不去。钩子失效于「不认识」:没见过的写法直接放行,钩子自己崩了也放行。提示词失效得最随意:模型换个说法就绕开了。
关键区别在确定性。沙箱和钩子由普通代码裁决,同一条命令永远得到同一个结果;提示词由模型裁决,同一句话今天拦、明天可能放。
所以在不改工作流的前提下,钩子是投入产出比最高的一层。也正因为它是「代码判断」,它的失效方式同样是代码式的:写得不对,它会静默放行,而且你看不出来。
不想自己写的话,现在有三个现成的。ArmourCode 的那套覆盖 Claude Code,偏「已发生事故的规则化」;Destructive Command Guard 是 Rust 写的,50 多个可选规则包覆盖数据库、K8s、云 CLI,接入 Claude Code、Codex、Cursor、Gemini CLI 等主流命令行工具;Bright Lines 是无依赖的 Python 钩子,默认关(fail-closed)、带 kill switch 和每会话预算。
三个项目的设计取向不一样,值得留意:ArmourCode 用 1,949 个测试去覆盖已知事故;Destructive Command Guard 用「规则包」让数据库和云 CLI 这类高危面单独开启;Bright Lines 把「默认关」和「能一键停」当成第一需求。选哪个取决于你最怕的是哪一种。
用之前看一眼安装方式:Destructive Command Guard 的快速安装是 curl … | bash。我下面写的闸门会把这条判成「需确认」,因为把远端脚本直接交给 shell 执行,内容确实没经过验证。这不是挑刺,是这类工具的共同尴尬——它们自己也活在同一条风险线上。
三、三个默认值会悄悄吞掉你的规则
写钩子之前,先看清官方文档里的三个默认值。它们决定了你的规则是真在拦,还是只是存在。
第一,onFailure 默认不阻断。 钩子崩溃、超时、返回非法输出,默认行为是「当作没发生」,命令继续执行。要让它失败时关门,必须显式写 "onFailure": "block"(v2.1.295 起支持)。
第二,退出码 1 不拦。 文档把退出码分成三类:0 成功、2 阻断、其他算「非阻断错误」。你的 Python 脚本抛异常退出,退出码是 1,属于第三类——命令照跑。脚本写得越严谨,越容易在出错时静默失效。
第三,默认超时 600 秒。 钩子挂在每次工具调用前面同步执行,600 秒的预算是灾难而不是保护。给 5 秒,把慢操作挪出去。
配置长这样:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "python3 ${CLAUDE_PROJECT_DIR}/.claude/hooks/cmdgate.py",
            "timeout": 5,
            "onFailure": "block"
          }
        ]
      }
    ]
  }
}
钩子进程从标准输入拿到一个 JSON,命令在 tool_input.command 里。两种回法:退出码 2 并把理由写进 stderr,或者退出 0 并输出结构化决策。我用后者,因为理由能带回给模型,它下一步会换个做法,而不是卡死。
核心逻辑二十行就够:
import json, re, sys

RULES = [
    ("rm_home", r"\brm\b[^\n]*\s(/|~)(/?)(\s|$|\*)", "deny"),
    ("git_reset_hard", r"\bgit\s+reset\s+--hard", "deny"),
    ("prisma_reset", r"\bprisma\s+migrate\s+reset\b", "deny"),
]

def decide(cmd):
    cmd = re.sub(r"\\\s*(?=[a-zA-Z])", "", cmd)      # \rm -> rm
    cmd = re.sub(r"\$\{?HOME\}?", "~", cmd)            # $HOME -> ~
    cmd = re.sub(r"\s+", " ", cmd).strip()
    for rule_id, pat, level in RULES:
        if re.search(pat, cmd):
            return level, rule_id
    return None, None

try:
    cmd = json.loads(sys.stdin.read())["tool_input"]["command"]
    level, rule_id = decide(cmd)
    if level:
        print(json.dumps({"hookSpecificOutput": {
            "hookEventName": "PreToolUse",
            "permissionDecision": level,
            "permissionDecisionReason": rule_id}}))
except Exception:
    print(json.dumps({"hookSpecificOutput": {
        "hookEventName": "PreToolUse",
        "permissionDecision": "deny",
        "permissionDecisionReason": "闸门异常,按默认拒绝"}}))
最后那个 except 分支是整段代码里最重要的一行。解析失败、字段缺失、正则写崩,一律走拒绝。默认关不是风格问题,是这类工具唯一合理的默认值。
延迟要提一句。我在本机(Windows)测了 40 次,单次钩子往返 263 毫秒,其中纯规则判定只要 0.006 毫秒。也就是说 99.99% 的时间花在启动 Python 解释器上。每次 Bash 调用都多四分之一秒,长会话里能感觉到。Rust 版本存在的意义就在这。
四、59 条语料,量出闸门的真实边界
规则写完不算完,得知道它漏在哪。我把它做成一个独立进程,按官方文档的 stdin 结构喂命令,用四组语料跑:破坏性 24 条、日常 18 条、仅提及 5 条、规避 12 条。
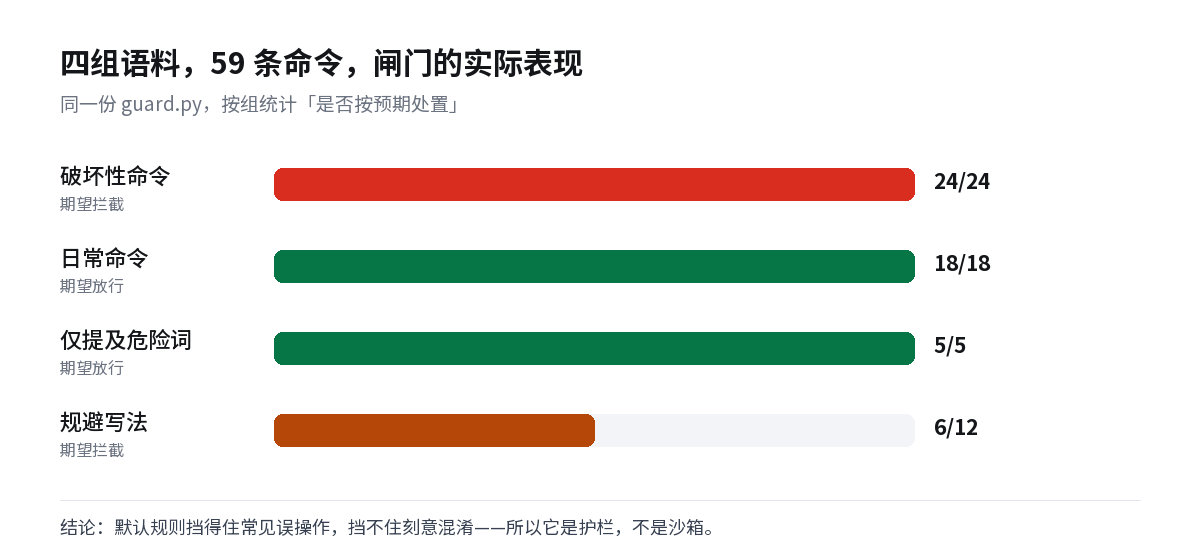
| 组别 | 预期 | 结果 |
|---|---|---|
| 破坏性 | 拦截 | 24/24 |
| 日常 | 放行 | 18/18 |
| 仅提及 | 放行 | 5/5 |
| 规避 | 拦截 | 6/12 |
破坏性那组是 rm -rf ~、git reset --hard、prisma migrate reset、读私钥这类;日常那组是 rm -rf node_modules、git reset --soft、find . -delete 这类必须放行的;「仅提及」是提交信息和文档里写到危险字符串的情况。
前两组是 100%,但这个 100% 是修出来的,不是写出来的。中间踩了三个坑,都值得记下来。
坑一:变量展开后,规则就失效了。 我最初把 $HOME 归一成 /home/user,结果 rm -rf $HOME 直接漏过——规则要求 / 后面跟空白或结尾,而 /home/user 后面是字母 h。改成归一成 ~ 才通。这类 bug 的共同点是:表达式本身没错,错在它假设了输入的形状。
坑二:剥引号剥掉了判断依据。 为了防 r''m -rf ~ 这种写法,我先把引号全部剥掉再匹配。副作用是 git commit -m "docs: warn about rm -rf ~" 也被判成危险命令——五条「仅提及」全部误伤。误伤比漏拦更致命:开发者遇到两次莫名拦截,就会把整道闸关掉。
坑三:遮罩引号之后,数据库命令又漏了。 改法是先遮罩非空引号串再判定,只有外层存在执行包装器时才回退查原文。第一次补清单时我只列了 sh -c、bash -c,忘了 psql -c、mysql -e、python -c——三条数据库命令重新漏过。补全解释器清单才修好。
最后仍漏的 6 条,没有一条是「再调调正则」能解决的:
find ~ -maxdepth 1 -delete——根本没有rmcd ~; rm -rf .——路径是.,不是~echo …base64… | base64 -d | sh——载荷不可读,模式匹配没有下手处truncate -s 0 ~/.bashrc——不是删除,是清空git checkout -- .——丢弃改动,不是我看的几类模式rm -rf ../——相对路径,不知道落在哪
这六条正好划出边界:模式匹配能挡住手滑,挡不住刻意。 一个存心的 agent 有无限多种写法,一份正则清单只有有限条。
所以正确的期待是:钩子负责让「模型顺手选错一步」这类高频事故不再发生,沙箱负责兜住剩下的。两件事不能互相替代。这也是为什么智能体的权限要按四道闸设计——命令闸只是其中一道,管的是本地执行入口,不管接口授权和额度。
补一句没做的事:我没有在真实的 Claude Code 会话里跑端到端验证,只按官方文档的 stdin 结构把 59 条命令直接喂给钩子进程,验证的是判定逻辑。配置本身能否被正确加载,需要你装好之后用 /hooks 菜单确认一遍。
上线前的四件事: ①把 onFailure: "block" 写进配置,否则崩溃即放行;②拿你自己最近两百条命令历史喂一遍闸门,先看误伤率,误伤高就调整允许清单——会被关掉的闸门等于没有;③至少跑十条 rm 变体、三条管道执行,确认 $HOME、${HOME}、\rm、r''m 都在拦;④留一个沙箱兜底,钩子只防手滑。
顺带一句相关的事:让 agent 改测试来通过构建和删家目录是同一类问题——它选择了一条让指标好看的路。命令闸能挡住后者的物理后果,挡不住前者的动机,那得靠审查流程。
登录后可点赞、收藏与反馈。