Windows 下 Arc 跑 ComfyUI:报错清单与配置对照
从驱动、Python、XPU wheel 三者的版本对齐讲起,把 Windows 上用 Arc 跑 ComfyUI 的高频报错整理成「报错—原因—改法」表,并说明 xformers 为何装不上、显存不够时该动哪几个参数。
Windows 上 Arc 跑 ComfyUI,报错看着五花八门,真正的原因集中在四处:装的不是 XPU 版 PyTorch、驱动缺了组件、显存分配撞上单次上限、社区节点里调了 XPU 上没有实现的算子。把这几类分开,绝大部分红字都能对上号。
这篇按「装之前对齐什么 → 装的时候怎么装 → 报错怎么改」的顺序写,最后给一份可以直接对照的表。版本基线是 2026 年 11 月 18 日核对的官方文档,ComfyUI 侧对应 0.45.0,PyTorch 侧对应 2.15.0+xpu。
装之前要凑齐的三个版本
三样东西必须同时满足:显卡驱动、Python 版本、PyTorch wheel。任意一项不对,症状都是「跑起来了但用的是 CPU」。
| 项目 | 最低要求 | 当前可用版本 | 不对会怎样 |
|---|---|---|---|
| 显卡驱动 | 32.0.101.9033 WHQL,且含 LevelZeroSDK | 32.0.101.9175(2026-11-04) | torch.xpu.is_available() 为 False |
| Python | 3.11(2.15 起不再提供 3.10 轮子) | 3.11–3.15 都有 win_amd64 包 | pip 找不到匹配版本,或退回旧 torch |
| PyTorch | 2.15.0+xpu | download.pytorch.org/whl/xpu | 装成 +cpu / +cu###,全程 CPU |
驱动这一条最容易被「我已经装最新了」糊弄过去。OEM 预装的驱动常常是精简版,版本号看着新,但没带 Level Zero 组件。判断方法在 Intel 的 PyTorch 前置条件页里写得很明确:驱动版本要 ≥ 32.0.101.9033,且安装包需包含 LevelZeroSDK,torch.compile 依赖它。
这三条之外还有一个容易忽略的:Windows 的显存口径。任务管理器里「专用 GPU 内存」才是卡上的,「共享 GPU 内存」是系统内存划过来的额度。
ComfyUI 启动时打印的 Total VRAM 读的是设备上报的总量,跟任务管理器里那个数经常差几百 MB,差的是驱动预留。判断够不够,用 ComfyUI 自己报的数字。
换驱动的时候建议一次装干净。Intel 的通用驱动会覆盖 OEM 定制驱动,但残留的旧服务和新 DLL 混在一起时,加载到的可能还是旧的那一份运行时。遇到「装完驱动版本号变了、行为没变」,先彻底卸载再装一次,比继续查代码快。
Python 这一条是 2.15 的新变化。XPU 索引里 2.14.1 还有 cp310 的 Windows 包,2.15.0 最低只到 cp311。用 Python 3.10 的环境直接 pip install torch --index-url .../xpu,拿到的是 2.14.1 而不是最新版——不是命令写错,是这个版本组合不存在。
安装:从同一个索引装 torch 和 torchvision
在已经装好驱动的 Windows 11 上,建一个干净的虚拟环境再装:
py -3.12 -m venv .venv
.\.venv\Scripts\Activate.ps1

# ComfyUI 只用 torch 和 torchvision,不需要 torchaudio
pip install torch torchvision --index-url https://download.pytorch.org/whl/xpu

# 验证:版本号里要带 +xpu,后面要是 True
python -c "import torch; print(torch.__version__, torch.xpu.is_available(), torch.xpu.device_count())"
这里用 --index-url 而不是 --extra-index-url,是有原因的。--extra-index-url 会让 pip 在 PyPI 和 XPU 索引之间挑版本号最高的那个,而 PyPI 上的 torch 版本号通常更新,结果就是装回一个 CUDA 版。--index-url 把源限定成唯一一个,版本配对才由索引保证。
PyTorch 官方文档给的命令是三个包一起装,但 ComfyUI 的依赖清单里没有 torchaudio,可以不装。少装一个的实际好处是少一个版本约束:2026 年 11 月 18 日查 XPU 索引,torchaudio 的 wheel 最高只到 2.11.1,而 torch 已经到 2.15.0。三个一起装时,最终落到哪个 torch 版本由依赖关系决定,不是由最新版决定。
装完先 pip list 看一眼 torch 和 torchvision 的版本,再跑上面的验证命令。如果 torch.xpu.is_available() 是 True 但版本号比预期低,多半就是被某个包的依赖拉回去了。
然后再装 ComfyUI 的依赖。顺序不能反:先装 requirements.txt 的话,里面那行没锁版本的 torch 会从 PyPI 拉一个 CUDA 版下来,之后再补 XPU 包就是两个版本混在一起。
git clone https://github.com/comfyanonymous/ComfyUI
cd ComfyUI
pip install -r requirements.txt
python main.py --oneapi-device-selector "level_zero:0"
启动日志里出现 Device: xpu:0 Intel(R) Arc(TM) ... 才算走对。如果显示的是 Device: cpu,往下看对照表。
原生 Windows、WSL 还是别的路
WSL2 是官方支持的路径之一,PyTorch 文档把 Windows 11 和 WSL2 Ubuntu 24.04 并列写在验证列表里。区别在驱动归属:WSL 里 GPU 由 Windows 宿主的驱动持有,guest 只装用户态包。所以驱动要在 Windows 侧更新,在 guest 里再装一遍驱动没有意义。
原生 Windows 的好处是省一层。torch.compile 从 PyTorch 2.7 起就支持 Intel GPU 的 Windows 路径,不用为了这个特性专门开 WSL。两条路径在算子覆盖和性能上没有可靠的可比数据,选哪条主要看你要不要用 Linux 侧的其它工具。
DirectML 是另一条老路,它不在 PyTorch 官方 XPU 路径里。走这条路意味着模型代码、节点依赖、报错信息都跟主流教程对不上,出问题时能对照的资料很少。除非你有明确理由,否则没必要为了绕过安装问题去换一套栈。
报错 → 原因 → 改法
下面这份表覆盖了 Windows + XPU 组合里最常见的一批。报错文本按实际会出现的原样写,方便直接搜。
| 报错或现象 | 原因 | 改法 |
|---|---|---|
Torch not compiled with CUDA enabled | XPU 不可用,ComfyUI 退到 CUDA 分支 | 别按 CUDA 方案重装,改装 XPU 版 torch |
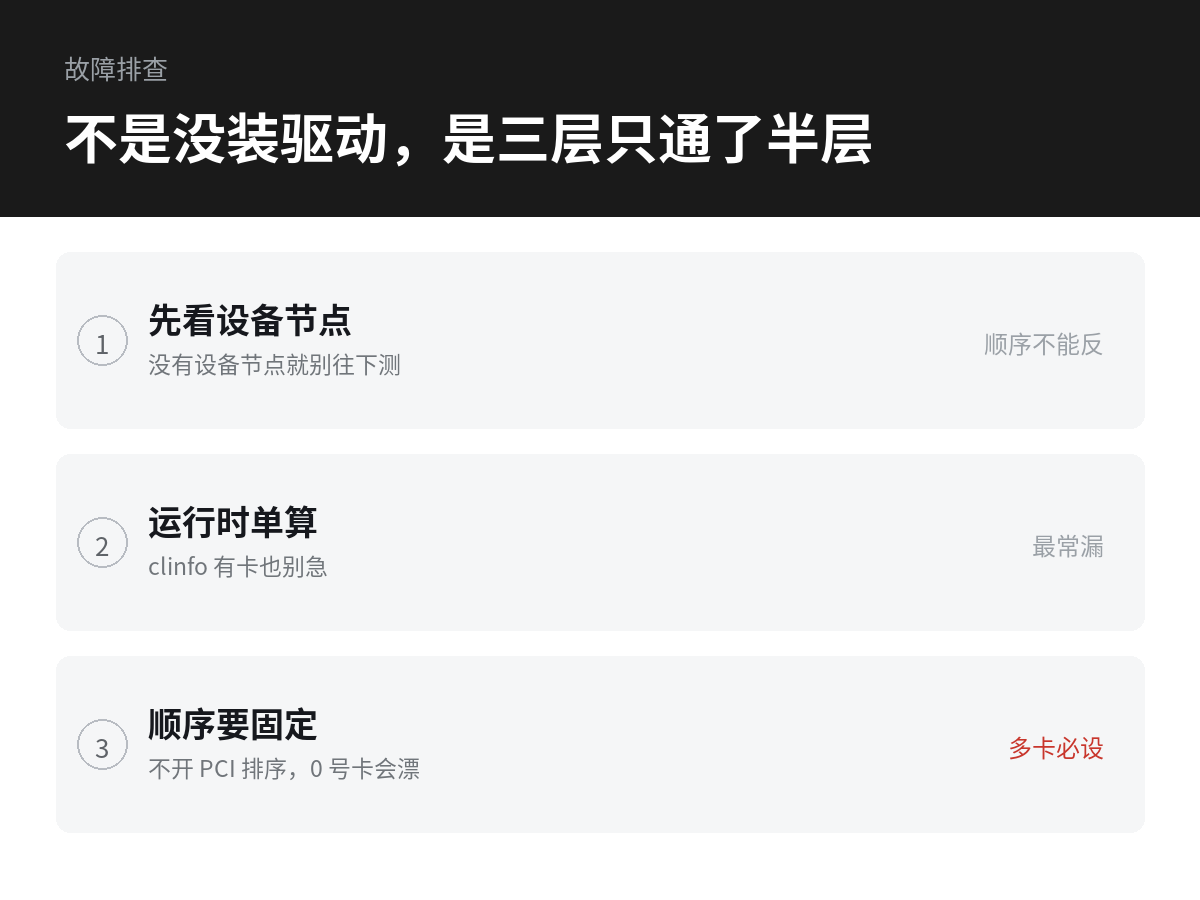
torch.xpu.is_available() 为 False | 驱动缺 LevelZeroSDK,或版本低于 9033 | 换 Intel 官方完整驱动,别用 OEM 精简版 |
Could not find a version that satisfies the requirement torch | Python 3.10 配 2.15 | 升到 3.11+,或显式装 torch==2.14.1 |
operator torchvision::nms does not exist | torchvision 没有 XPU 的 NMS 内核 | 该节点改走 CPU,或绕开依赖 NMS 的节点 |
| 提示找不到 xformers / 装 xformers 失败 | xformers 没有 XPU 轮子 | 不用装,ComfyUI 在 XPU 上本就不启用它 |
XPU out of memory. Tried to allocate ... total capacity of ... | 单次分配超过 4GiB 上限,或显存真不够 | 先设 UR_L0_ENABLE_RELAXED_ALLOCATION_LIMITS=1,再降分辨率 |
| 出图慢、显存没满 | 进入低显存模式,UNet 分块跑 | 加 --reserve-vram,或降低分辨率与批量 |
| 出黑图、色偏 | fp16 VAE 精度问题 | 换 --fp32-vae 或 --bf16-vae |
| 启动即报 DLL 加载失败(WinError 126) | 依赖库不全,或 torch 与 torchvision 不同源 | 卸掉这两个包,从同一索引重装 |
表里前两条占了实际问题的大多数,先查这两个,再往下看。
torchvision::nms 这一条值得单独说。torchvision 至今没有为 XPU 提供 NMS 内核,PyTorch 的 vision 仓库里对应 issue 仍然开着。
有第三方项目在 2026 年 8 月的讨论里给出的分发表是:CPU 可用、MPS 可用、XPU 不可用。所以凡是自定义节点里调 torchvision.ops.nms 的(检测、分割、人脸类节点居多),在 Arc 上必然抛这个错,跟显存和驱动都无关。这类节点只能换实现或改到 CPU 上算。
xformers 装不上,也不需要装
在 N 卡上 xformers 是提速标配,很多人照着教程装,然后在 Arc 上卡住。原因是 xformers 没有 XPU 构建,pip 里根本没有能装的包。
更关键的是,ComfyUI 在 XPU 上会主动禁用 xformers。源码里 xformers_enabled() 的第一个判断就是「如果是 Intel XPU 就返回 False」。也就是说,即便想办法装上了,它也不会被调用。注意力会走 PyTorch 自带的 SDPA 路径。
所以要做的不是「找个替代品装上」,而是接受这条路径,把注意力参数留在默认值。看到启动日志里没有 xformers version: 这行,是正常的。
替代它的是 PyTorch 自带的 SDPA。PyTorch 2.8 之后,XPU 上的 SDPA 能直接处理分组查询注意力,不需要先把 KV 头复制成和 Q 头一样多。这一点在 Hugging Face 的 Intel GPU 文档里有明确说明,影响的是长上下文下的显存占用和速度。换句话说,不装 xformers 不等于没有优化,只是优化来自另一个地方。
启动参数里的 --use-split-cross-attention、--use-quad-cross-attention 都是给显存吃紧时兜底的旧方案,帮助文本里写着「使用 xformers 时被忽略」。在 XPU 上 xformers 不启用,这两个参数理论上会生效,但它们换的是显存不是速度,别指望用来提速。
显存不够时,先分清是哪种不够
ComfyUI 现在的显存管理有两套:动态显存(DynamicVRAM)和传统的分档加载。启动参数的行为跟着变,这也是很多老教程失效的原因。
一个直接的例子:--lowvram 的帮助文本写的是「动态显存开启时这个参数不起作用」。也就是说在默认配置下加 --lowvram 可能什么都不会发生。要让手动分档生效,得先 --disable-dynamic-vram。
--reserve-vram 的帮助文本写的是「默认会按操作系统预留一定量」,也就是说这个值不是 0。手动指定只是把它调大或调小,调大给桌面留余量,调小则把更多显存让给 ComfyUI,代价是切换窗口时更容易卡顿。
实际能动的旋钮是这几个:
# 给系统和其它程序留出 2GB,避免整机卡死
python main.py --reserve-vram 2

# 关掉动态显存,再用传统低显存档位
python main.py --disable-dynamic-vram --lowvram

# 关掉智能内存管理,模型用完立刻挪回内存(更慢但更稳)
python main.py --disable-smart-memory
显存不够其实分三种,处理方向完全不同。权重根本放不下,只能换更小的模型或更低的量化档;权重放得下但峰值超了,降分辨率、降批量、去掉 ControlNet 这类附加模型;碎片导致分配失败,重启进程往往比调参数有效。
先判断是哪一种,别一上来把所有低显存参数全打开,那样只会更慢。
在 12GB 的 B580 上,SDXL 属于「能跑但不宽裕」,Flux 这类模型要看量化档位。分辨率和批量对峰值的影响比模型本身更大,先把 1024 降到 768 试一次,往往比调参数更快定位。
具体的容量估算可以对着本地跑大模型要多少显存那张表,把 UNet、文本编码器、VAE 分三段加起来看,别只算权重。
低显存模式还有一个前置条件容易被忽略:系统内存和页面文件。模型被挪到内存里之后,如果物理内存不够、页面文件又设得很小,失败的方式就不是 OOM 报错,而是进程直接退出或者卡死。工作站上跑 12GB 卡配 16GB 内存,先加内存比调参数有用。
还有一条只影响 Arc 的特殊项。oneAPI 的 release notes 里写过:统一运行时的 Level Zero 适配器默认会在单次分配超过设备允许的最大值时直接失败,部分 Intel GPU 上这个上限在 4GiB 左右,需要靠 UR_L0_ENABLE_RELAXED_ALLOCATION_LIMITS=1 放开。
表现出来就是显存明明还有十几个 GB,却在加载某个大张量时报 OOM,报错里的「total capacity」比你要分配的量还大。这种矛盾组合就是这个限制的典型特征。
$env:UR_L0_ENABLE_RELAXED_ALLOCATION_LIMITS="1"放开之后要自己保证不超总量,否则拿到的是更难懂的失败。
节点和模型格式的边界
ComfyUI 本体能正常跑起来,报错基本都出在第三方节点上。判断一个节点能不能用,看它依赖什么算子:
- 只调
torch.nn.functional和基础张量运算的,基本都能跑。 - 调
torchvision.ops.nms、torchvision.ops.roi_align这类视觉算子的,大概率在 XPU 上没有实现。 - 依赖
xformers、flash-attn、triton自定义内核的,在 XPU 上装不上也跑不了。 - 依赖 CUDA 特定扩展(
.cu编译的自定义 op)的,只能等作者出 XPU 版本。
还有一个判断依据是报错出现的时机。加载阶段就失败,多半是显存或格式问题;执行到某个节点才失败,基本是算子缺失;出图之后才崩,看 VAE 和保存环节。
模型格式这边,GGUF 需要额外的 ComfyUI-GGUF 节点,反量化走的是普通 torch 算子,能跑但不算快;.safetensors 是最稳的路径。
至于 checkpoint 里带 fp8 权重的,ComfyUI 的 --fp8_e4m3fn-unet 参数,帮助文本写的是「把 UNet 权重存成 fp8」。它是省显存的手段,不等于在 Arc 上启用了 fp8 计算。这一点目前没有公开的实测数据说明加速效果,别把它当性能开关。
另外提醒一句:ComfyUI 官方排障文档里仍然保留了 IPEX 那条安装路径,命令里锁的是 torch 2.3.1。那套东西对应的仓库 intel-extension-for-pytorch 已经归档,最后一次提交是 2026 年 3 月 30 日。新装机不要走这条路,用原生 XPU 就行。
ComfyUI 的依赖清单本身是锁版本的,前端包、工作流模板都写了精确版本,唯独 torch 那一行没有锁。这个设计对多后端是必要的,代价是把版本配对的责任交给了使用者。所以每次 pip install -r requirements.txt 之后,都值得再确认一次 +xpu 还在不在。
排错时还有一条纪律:先关掉所有自定义节点,用默认工作流跑一遍。ComfyUI 的排障文档把「禁用全部自定义节点」列为首选手段,因为绝大多数报错来自节点而不是本体。确认本体能出图之后,再逐个开节点,二分法定位,比对着红字猜快得多。
python main.py --disable-all-custom-nodes装完怎么确认没踩坑
跑一遍下面四条,全过就说明环境是对的:
python -c "import torch; print(torch.version)"输出里带+xpu。torch.xpu.device_count()返回的数目和你插的卡对得上。- ComfyUI 启动日志有
Device: xpu:0,且Total VRAM那一行显示的容量接近标称值。 - 跑一张 512×512、20 步的默认工作流,任务管理器的 Compute 引擎有占用。
第 4 条最容易被忽略。很多工作流在 CPU 上也能出图,只是慢,不看曲线根本发现不了,于是被当成「Arc 就这水平」。
四条里有任何一条不对,回到对照表按报错文本找。
ComfyUI 本身对配置的要求,ComfyUI 对电脑配置要求里按显存分档讲过一遍,选卡和选量化档位可以对着看。装完之后的性能预期,取决于模型、分辨率和驱动版本三者的组合,没有一组通用的数字可以照搬。
登录后可点赞、收藏与反馈。