#Intel显卡
Intel 推理服务默认绑 0.0.0.0:一个不该默认开启的端口
框架的默认监听地址本来是回环,是启动脚本和端口发布把它推到了所有网卡。从局域网、云安全组到容器映射拆开暴露面,说明算力盗用与数据外泄的实际损失,并给出五个可执行的收紧动作。
torch.xpu 返回 False:八个原因逐条验证
同一个 False 可能来自驱动、运行时、wheel 来源、Python 标签、设备选择器、容器透传、WSL 节点或用户组。按从内核到 Python 包的顺序给八条验证命令,每条都能单独定性。
用 Intel 显卡搭内网模型服务:四个组件的选型
把「内网可用」拆成推理引擎、网关鉴权、可观测、模型分发四层,每层给出候选与取舍标准,并给出一套 12GB 单卡起步的最小组合、可执行的启动配置与三步扩容路径。
Arc Pro B60 24G 多卡:四卡方案的账怎么算
四张 B60 是 96GB 显存,价格约等于一张 RTX 5090 的一半,但多卡补的是容量不是速度。按官方规格与可查实测,拆开带宽、并行方式、功耗与故障域,给出「什么规模才值得上多卡」的判断线。
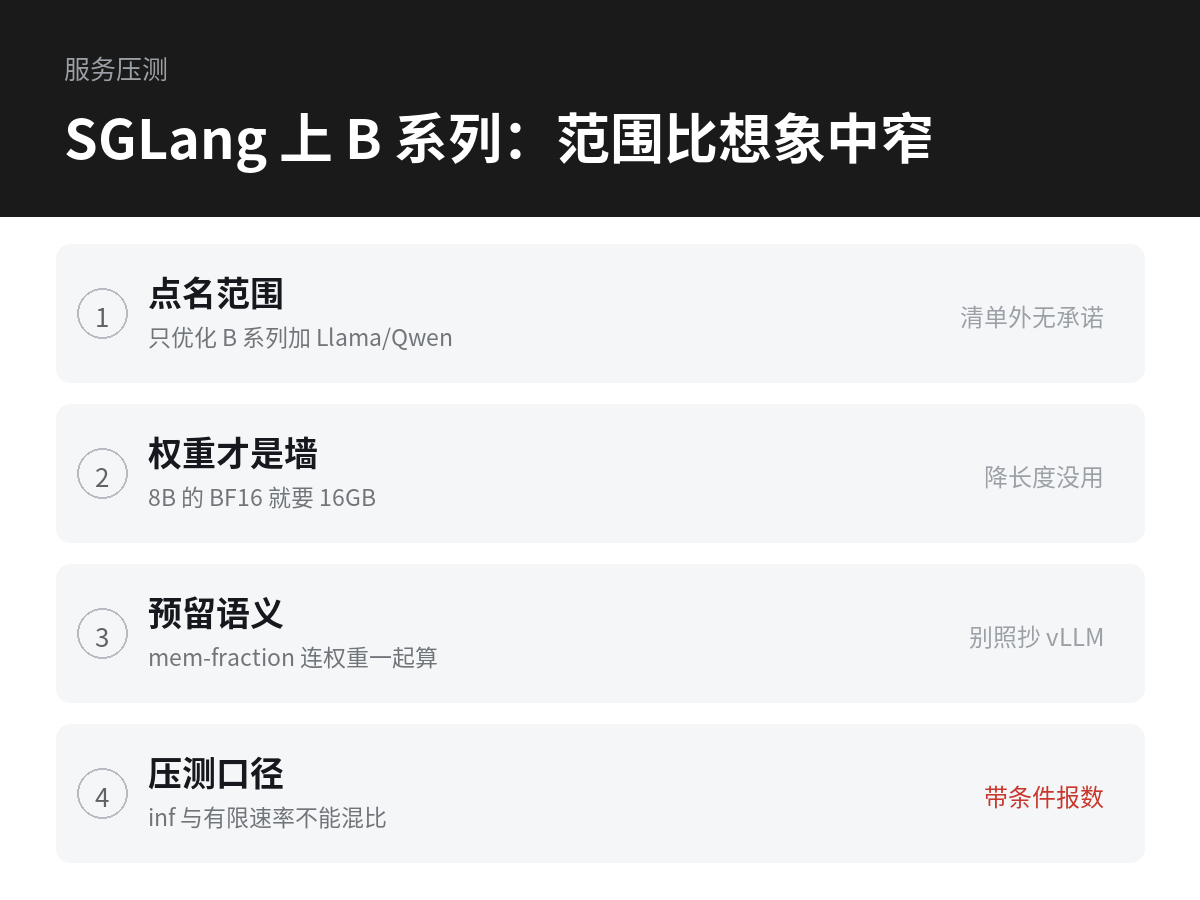
SGLang 在 Arc B 系列上跑:并发压测与显存预留
SGLang 对 Intel 的支持是「按卡型加按模型清单」的,本文逐条核对官方承诺范围,给出源码与镜像安装命令、mem-fraction-static 与 page size 的取舍,以及一套不编数字的并发压测方法与指标口径。
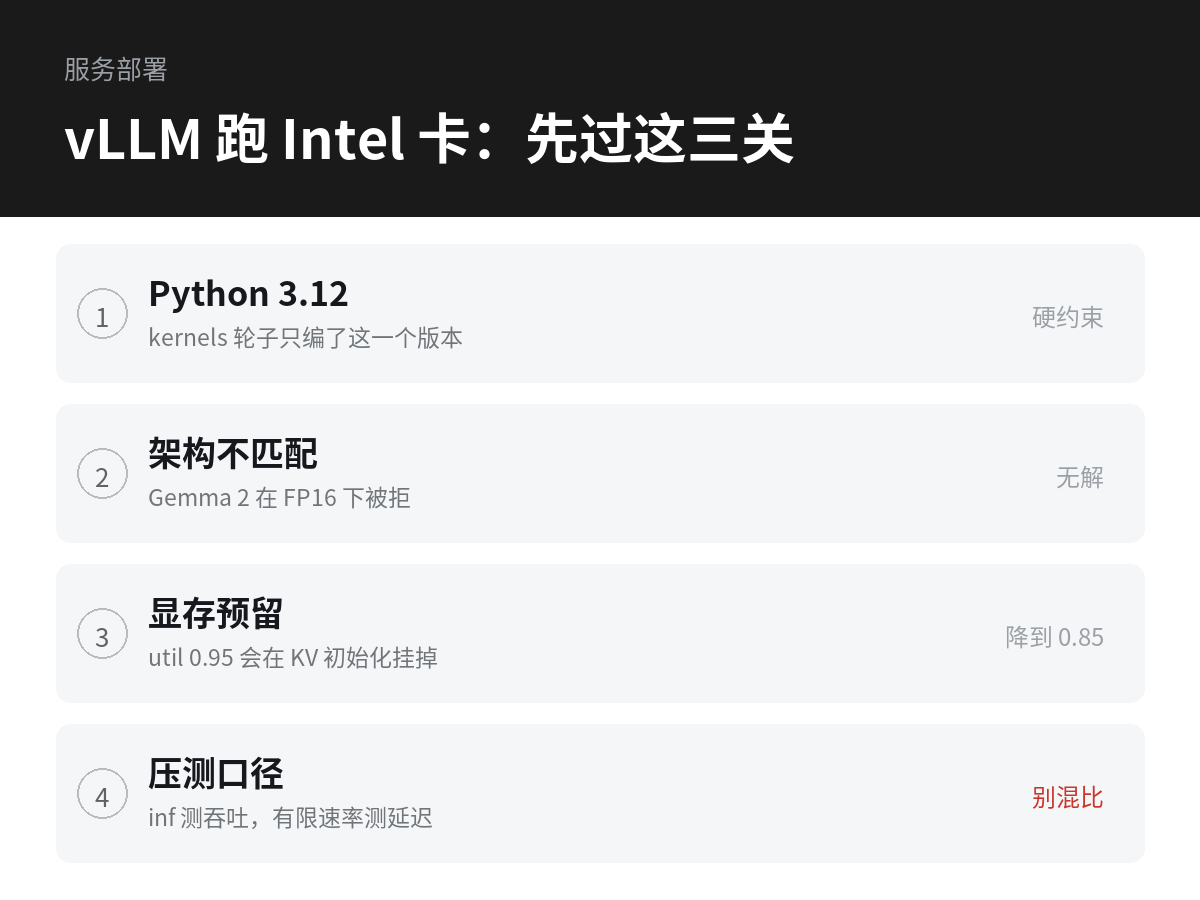
vLLM XPU 部署 OpenAI 兼容接口:完整命令与三个坑
从 wheel、源码、Docker 三条安装路径讲到起服务,逐项解释显存比例、最大长度、dtype 的真实含义,并拆解 Python 3.12 硬约束、模型架构与 dtype 不匹配、显存预留过高这三个高频失败点,附 curl 与压测口径。
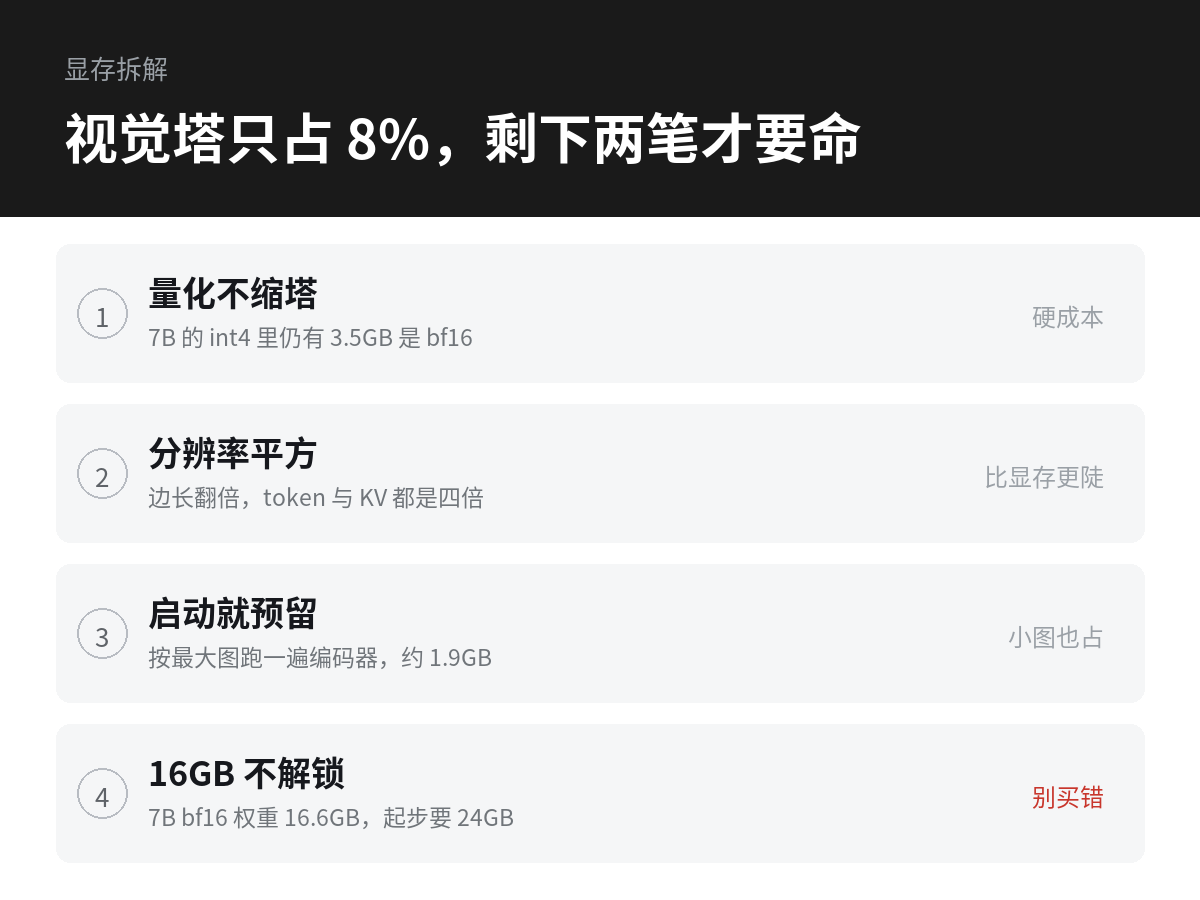
Arc 上跑多模态模型:视觉编码器吃掉多少显存
VLM 的显存是三笔账:视觉塔权重、图像 token 撑起的 KV、引擎启动时按最大分辨率跑视觉编码器的激活预留。Qwen2.5-VL-7B 的视觉塔只占 8%,但 AWQ 后仍有 3.5GB 是 bf16。
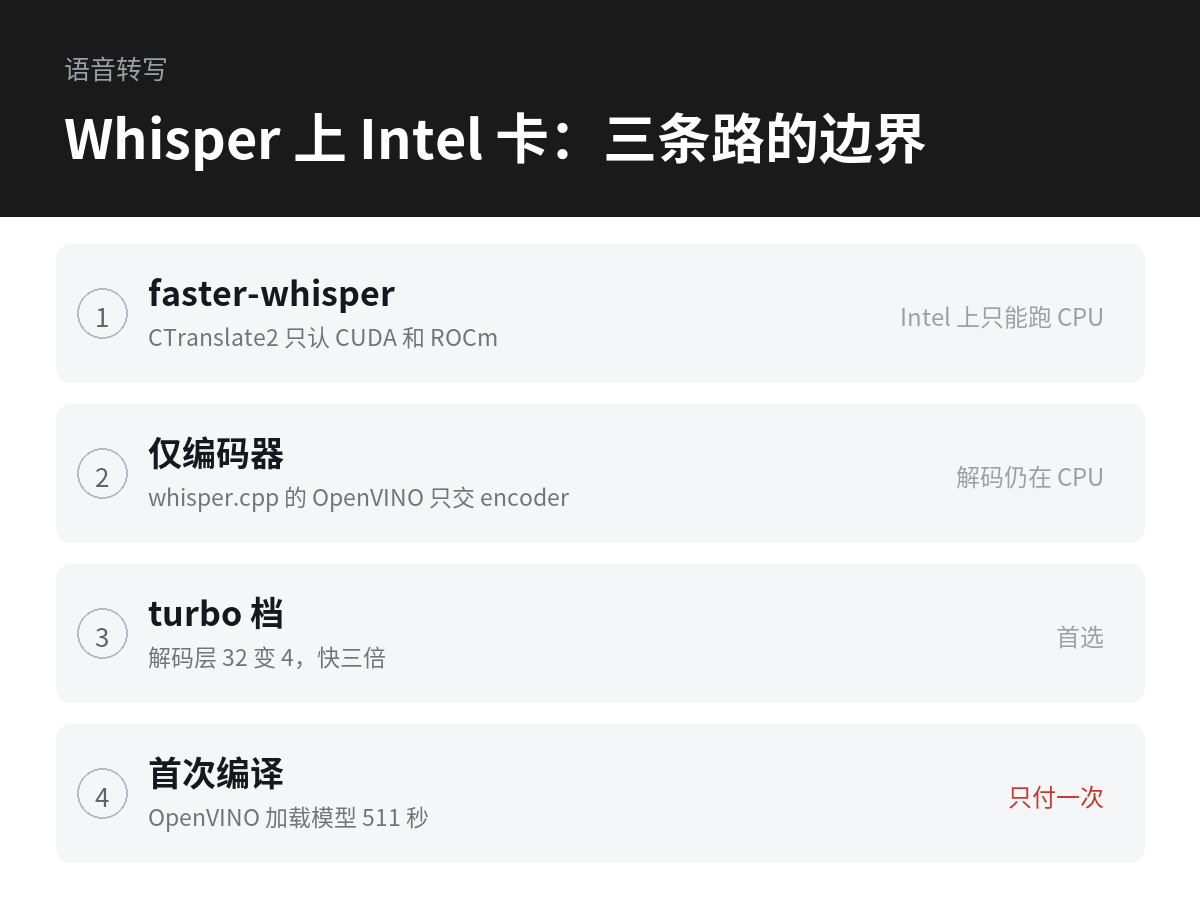
Intel 显卡跑 Whisper:三种后端的速度与取舍
对比 whisper.cpp 的 SYCL 与 Vulkan 后端、faster-whisper、OpenVINO 三条路在 Intel 显卡上的真实支持范围,给出模型档位与显存关系、长音频切窗与时间戳对齐方法,以及按硬件场景的选型结论。
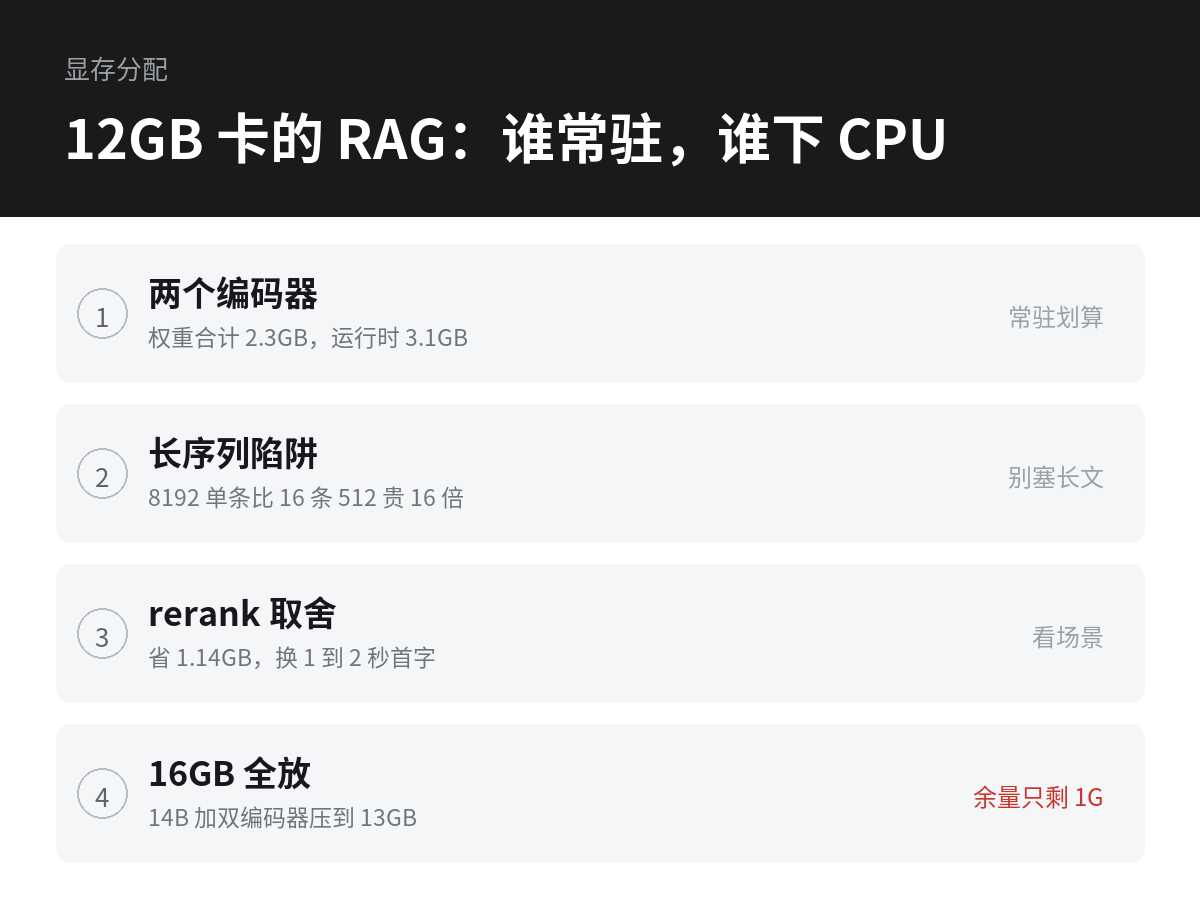
用 Intel 显卡搭 RAG:embedding 与 rerank 的显存怎么分
把 RAG 链路上的 embedding、rerank、生成三类模型拆开算显存,给出 12GB 与 16GB 卡的四种分配方案,说明 batch 与序列长度对编码吞吐的影响,并附一套可直接运行的最小服务组合。
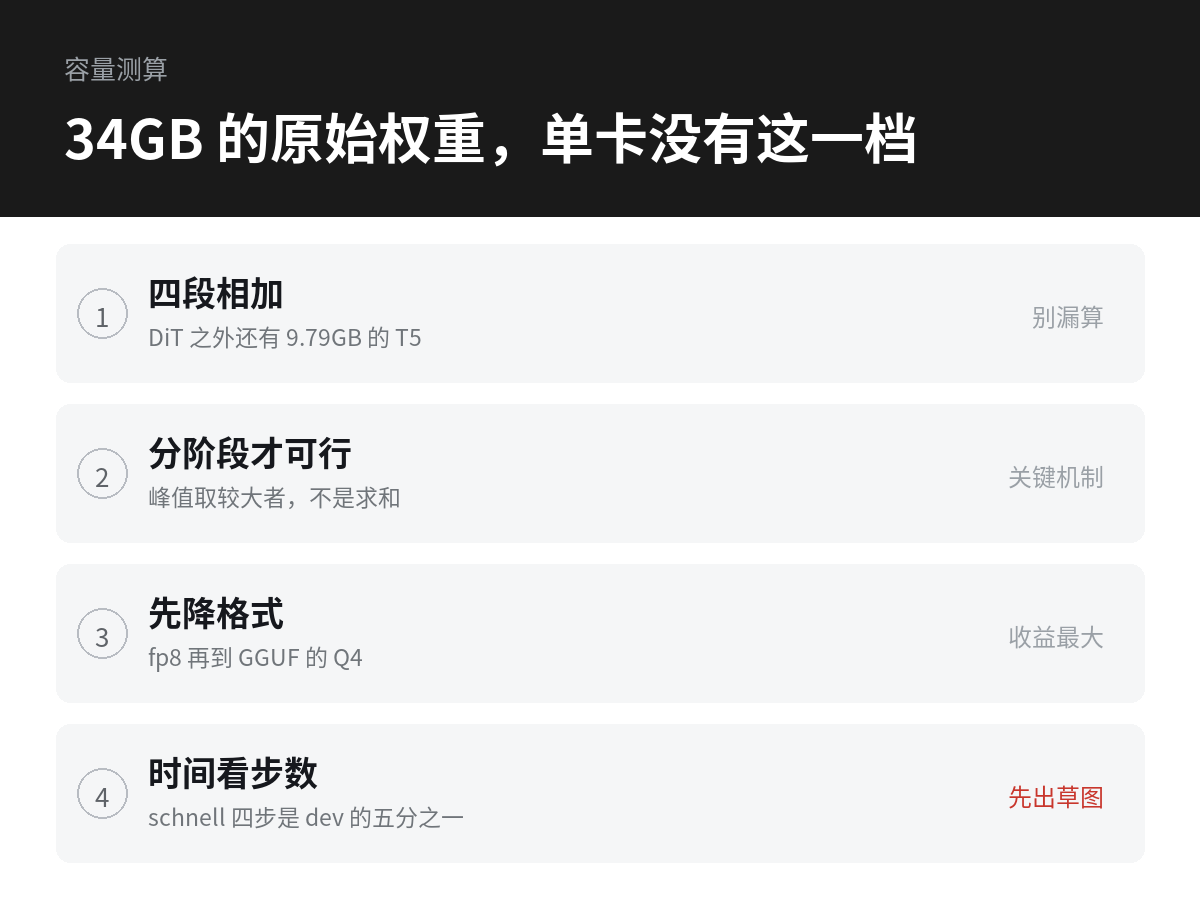
Flux 在 Intel 显卡上跑得动吗:显存账与三步降级
把 Flux 拆成 DiT、T5、CLIP、VAE 四段算显存,给出 fp16、fp8、GGUF 三档的真实体积与 12GB、16GB、24GB 卡的可行配置,再按「换量化格式、换文本编码器精度、降分辨率」三步给出降级顺序。
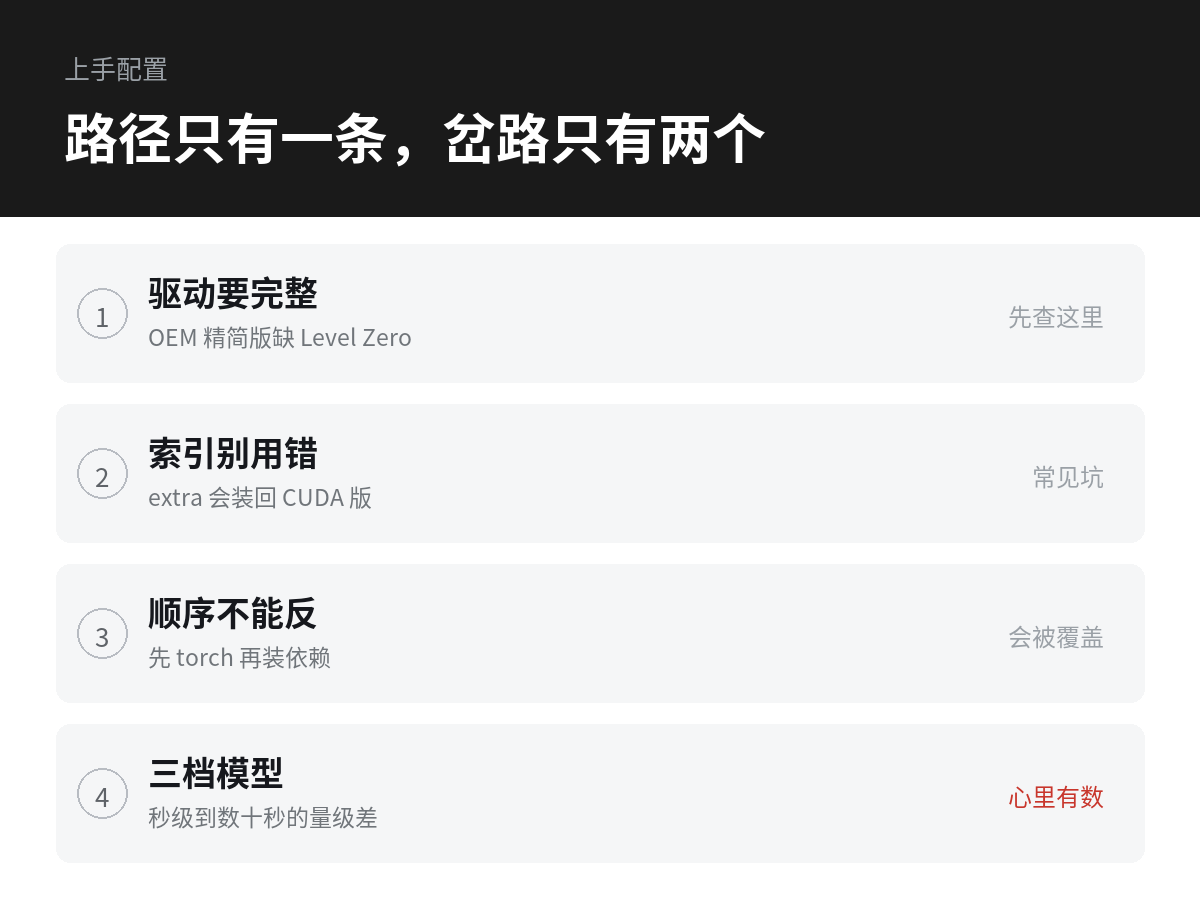
ComfyUI + Intel Arc:从驱动到第一张图的完整配置
按驱动、Python 环境、XPU 版 PyTorch、ComfyUI 本体、模型目录、首个工作流的顺序走一遍,给出每一步的验证方法和四个值得改的启动参数,并附 SD1.5、SDXL、Flux 三档的显存与耗时量级。
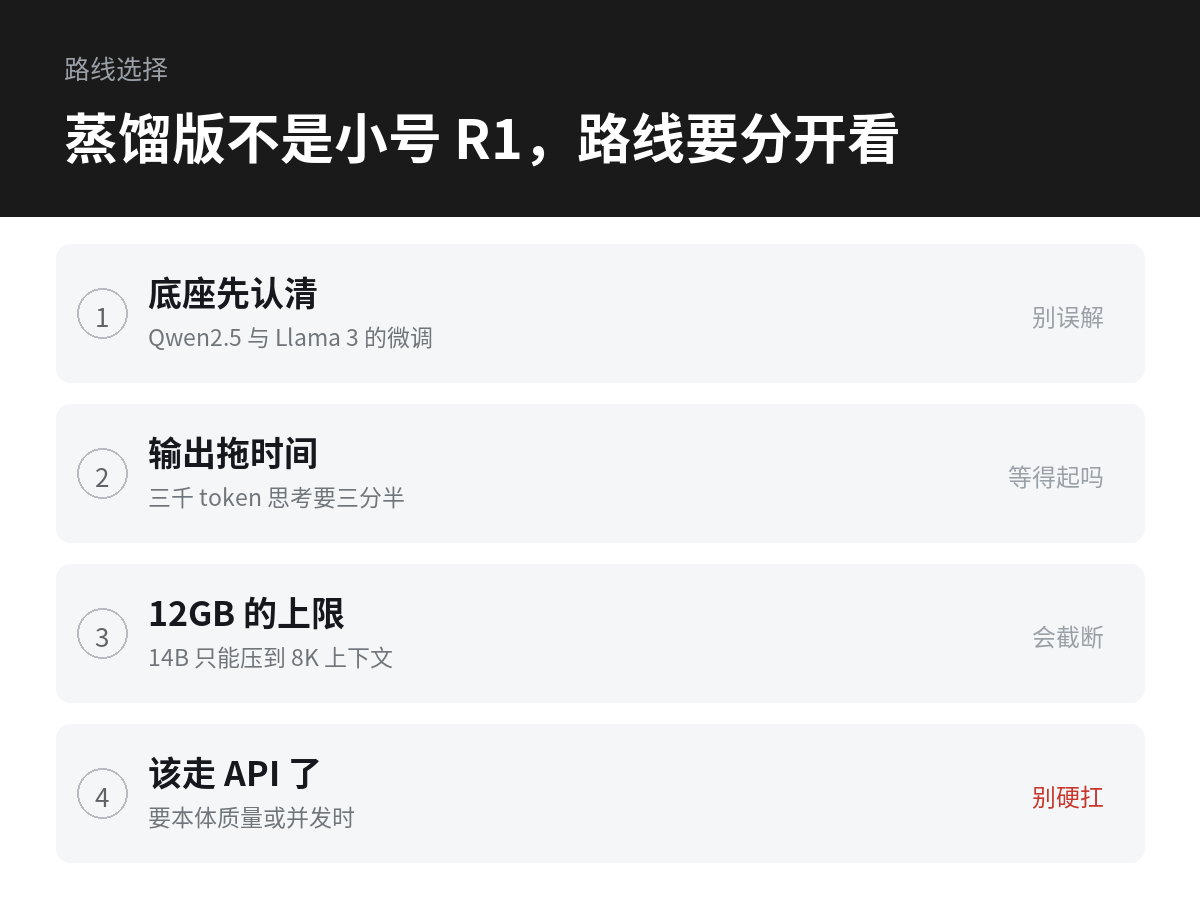
DeepSeek-R1 蒸馏版部署到 Arc:可行路线与速度预期
先说清 R1 蒸馏版是 Qwen2.5 与 Llama 3 底座的微调模型,不是 R1 本体;再按真实 GGUF 体积给出 7B、8B、14B、32B 在 12GB、16GB、24GB 卡上的可行档位,并说明推理模型为何被输出长度拖住。