Core Ultra 的 NPU 常年 0%:四条路,让闲置算力干活
Core Ultra 笔记本的 NPU 常年 0%,不是驱动坏了:Ollama、LM Studio 都没有 NPU 后端。本文给出 OVMS、OpenVINO GenAI、ONNX Runtime EP、llama.cpp 四条路线,附 Intel 官方 NPU 与核显实测对比、默认 1024 token 限制和 12 条报错急救。
11 月 21 日知乎热榜上有一条提问:AI PC 的 NPU 为什么经常处于闲置状态。高赞回答很直接——你装的软件根本没用它。
这话对 2024 年买 Core Ultra 的人尤其扎心。全网 99% 的本地模型教程默认你有 NVIDIA 显卡,或者至少是 Copilot+ 新机;你照抄 Ollama 的一键命令,任务管理器里 NPU 那条线永远贴着 0%,风扇吹的是 CPU。
先说结论:NPU 没坏,驱动也未必有问题。Core Ultra 7 155H 的 NPU 有 11 TOPS,能跑 Qwen3-8B,第三方在 NPU37XX 上记录过 6.72 tok/s;但它只认 OpenVINO、ONNX Runtime、Windows ML 这条线,Ollama 和 LM Studio 不在其中。下面把三层断点、四条能跑通的路线、以及 12 条最常见报错一次讲清。
说明:本文的命令与数字来自 Intel / OpenVINO 官方文档、OVMS 的 NPU demo 和公开用户实测;作者手头机器是 AMD 桌面平台,没有 NPU,未做真机复现。不同代际、驱动和内存配置结果会不同,文中会标出验证平台。
先分清:Core Ultra 的 NPU 显示 0%,可能是三层问题
任务管理器里的 0% 至少对应三种完全不同的情况,排查顺序不能反。
| 层 | 你看到的现象 | 先查什么 |
|---|---|---|
| 系统层 | 连 NPU 条目都没有,或没有 NPU 列 | Windows 版本、补丁、驱动 |
| 软件层 | 有 NPU 条目,跑 Ollama / LM Studio 始终 0% | 运行时有没有 NPU 后端 |
| 模型层 | OpenVINO 能编译,但报错、回退或很慢 | 形状、量化格式、上下文长度 |
系统层:NPU 列是 2026 年 5 月才补上的,而且灰度推送
任务管理器里的 NPU 总量曲线早就有;进程级、用户级的 NPU 列是后来的事。微软在 KB5089573(2026-05-26,build 26100.8524 / 26200.8524)和 KB5094126(2026-06-09,build 26100.8655 / 26200.8655)里加了「NPU」「NPU 引擎」「NPU 专用内存」「NPU 共享内存」四列,24H2 / 25H2 灰度推送。
所以「右键列头找不到 NPU」不等于驱动坏了,先看系统版本和更新历史。反过来,如果你连「性能」页左侧的 NPU 条目都没有,那才是系统没认出硬件。
驱动去 Intel 下载页拿 32.0.100.5600(2026-11-19 发布,95.9 MB),它明确支持 OpenVINO 2026.4.1 的 NPU 插件,覆盖 Core Ultra Series 1 / 2 / 3。装完重启,再用两条命令确认:
Get-PnpDevice | Where-Object { $_.FriendlyName -match "NPU|AI Boost|Neural" } |
  Select-Object FriendlyName, Status, InstanceId
python -c "import openvino as ov; print(ov.Core().available_devices)"
# 期望 ['CPU', 'GPU', 'NPU'];只有 CPU/GPU 就是驱动或安装问题这一步过不了,后面四条路全是白费。
四代 NPU 的差距:11 TOPS 和 47 TOPS 不是一回事
| 代际 | 代表型号 | NPU | Int8 算力 | Copilot+ | 动态 shape |
|---|---|---|---|---|---|
| Series 1 Meteor Lake | Core Ultra 7 155H | NPU 3720 | 11 TOPS | 否 | 不支持(静态) |
| Series 2 Arrow Lake-H | Core Ultra 7 265H | Intel AI Boost | 13 TOPS | 否 | 不支持(静态) |
| Series 2 Lunar Lake | Core Ultra 7 258V | NPU 4 | 47 TOPS | 是 | 预览(有界) |
| Series 3 Panther Lake | Core Ultra Series 3 | NPU 5 | 50 TOPS | 是 | 预览(NPU40XX 起) |
Copilot+ 的门槛是 40 TOPS,所以 155H / 265H 这两档永远等不到 Recall;但第三方应用仍可以通过 OpenVINO 用 NPU。反过来说,Lunar Lake 之后的机器虽然算力高,动态 shape 也只是「有界预览」,主要验证在视觉模型上,LLM 仍然走固定桶。
为什么 Ollama 和 LM Studio 调不动 NPU:四条软件链路的硬边界
截至 2026 年 11 月,Ollama 的硬件文档列得很清楚:NVIDIA(compute capability 5.0+)、AMD ROCm、Apple Metal、Windows/Linux 的 Vulkan。没有 Intel NPU,也没有高通 Hexagon。
容易被误读的是 AMD 那张表:Ryzen AI 9 HX 370、Ryzen AI Max+ 395 确实在列,但走的是 ROCm 的核显(gfx1150 / gfx1151),不是 XDNA NPU。「Ollama 支持 Ryzen AI」和「Ollama 能用 NPU」是两句话。
LM Studio 的运行时选择器只在 CPU 和 GPU 引擎之间切换;llama.cpp 主线也没有 NPU 后端,OpenVINO 后端是单独的预览分支。原因不复杂:NPU 不是小号 GPU,它按算子、量化格式、代际预编译内核,运行时不能靠一个开关「顺便支持」。
| 工具 | 实际后端 | 能碰 Intel NPU 吗 | 说明 |
|---|---|---|---|
| Ollama | CUDA / ROCm / Metal / Vulkan | 否 | 文档无 NPU;Ryzen AI 走核显 |
| LM Studio | CPU / GPU 运行时 | 否 | 选择器里没有 NPU |
| llama.cpp 主线 | CPU / CUDA / Vulkan / Metal | 否 | 没有 NPU 后端 |
| llama.cpp + OpenVINO | OpenVINO | 预览 | 只在 Lunar Lake / Panther Lake 验过 |
| OpenVINO / OVMS | NPU 插件 | 是 | 需驱动 + 静态形状 / 量化 |
| ONNX Runtime + OpenVINO EP | OpenVINO EP | 是 | 不支持的算子会回退 CPU |
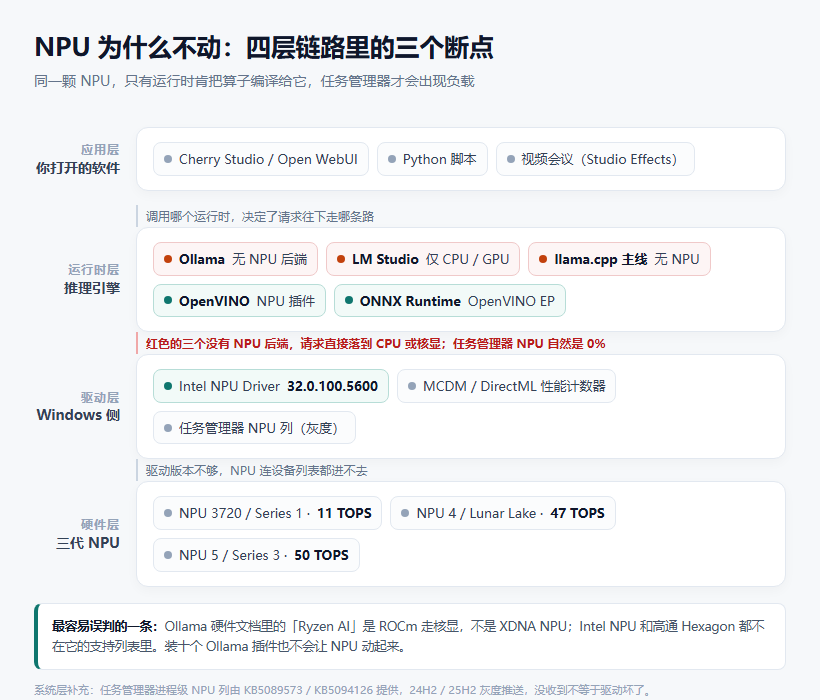
所以别再找 Ollama 的「NPU 插件」了,不存在。要动 NPU,只能换运行时;换运行时之前,先想清楚值不值。
反常识:同一台 Core Ultra,跑 Qwen3-8B 核显比 NPU 快 67%
Gartner 预测 2026 年 AI PC 出货 1.431 亿台、占 PC 的 54.7%,但软件没跟上。在讲四条路线之前,先泼一盆冷水:Intel 自己的 EDC 基准页给了 265H 三组 NPU / 核显对照(INT4、batch 1、OpenVINO GenAI LLM Bench 2025.4.1,2026 年 2 月):
| 模型 | NPU | 核显 | 首字延迟 NPU → 核显 | 能效 NPU → 核显 |
|---|---|---|---|---|
| DeepSeek R1-Distill-Qwen-1.5B | 17 t/s | 55 t/s | 1742 → 215 ms | 1.54 → 5.55 t/s/W |
| Phi-4-mini-reasoning | 12 t/s | 23 t/s | 2434 → 492 ms | 1.08 → 1.98 t/s/W |
| Qwen3-8B | 9 t/s | 15 t/s | 4545 → 825 ms | 0.57 → 1.17 t/s/W |
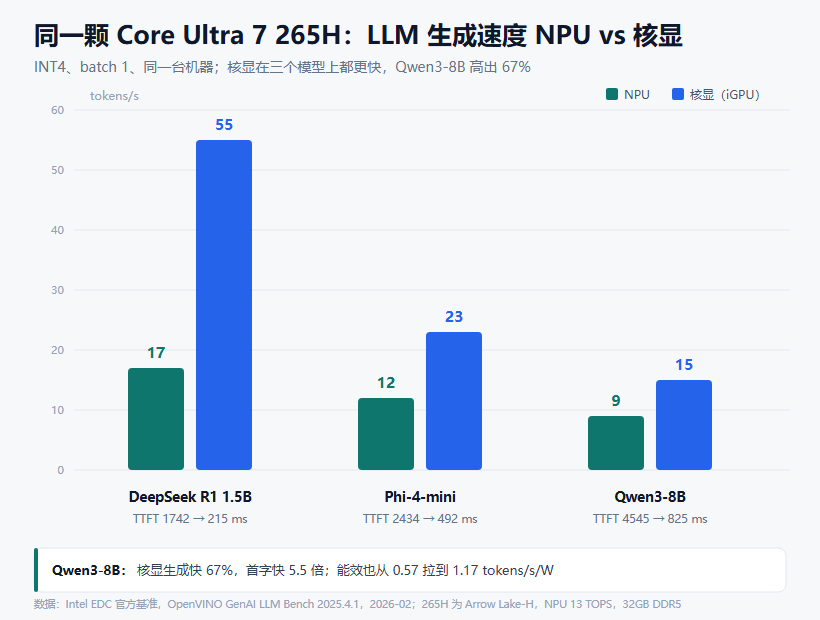
Qwen3-8B 上,核显生成快 67%,首字快 5.5 倍,连能效都是 NPU 的两倍。这不是 NPU 坏了,是分工问题:LLM 解码是带宽受限的矩阵向量乘,核显的 XMX 和内存子系统更合适;NPU 的长处是固定形状、低占空比的常驻任务。
所以「让 NPU 干活」的正确目标不是把聊天机器人塞进去,而是把视频会议特效、语音转写、OCR 检测、图片分类这类任务放进去,把 CPU / GPU 让出来。但如果你就是要一个能被客户端连上的本地接口,下面四条路线仍然成立,只是先接受 6–9 tok/s 的现实。
路线一:OVMS 起一个 NPU 版 OpenAI 接口(官方在 Meteor Lake 验过)
这是四条里最像「装个软件就能用」的一条。OpenVINO Model Server 的 NPU demo 明确写了测试平台:Meteor Lake、Lunar Lake、Arrow Lake,Windows 11 和 Ubuntu 24.04 都跑过。对 Core Ultra 一代用户,这是唯一有官方背书的 LLM 路线。
第 1 步 · 装驱动:32.0.100.5600,重启。
第 2 步 · 解压 OVMS:拿 2026.4.1 的 ovms_windows_2026.4.1_python_on.zip,解到 C:\ovms。缺 DLL 先装 Microsoft Visual C++ Redistributable。
第 3 步 · 初始化并拉模型:
cd C:\ovms
setupvars.bat

ovms.exe --pull ^
  --source_model OpenVINO/Qwen3-8B-int4-cw-ov ^
  --model_repository_path C:\models ^
  --target_device NPU ^
  --task text_generation ^
  --tool_parser hermes3 ^
  --cache_dir C:\models\.ov_cache ^
  --enable_prefix_caching true ^
  --max_prompt_len 2000
模型是通道级 INT4(int4-cw),正好对上老 NPU 只认对称通道级量化的限制。首次会从 HuggingFace 拉几 GB,网络不稳就设 HF_ENDPOINT 镜像,或手动把模型目录放进 C:\models。
第 4 步 · 写进配置并启动:
ovms.exe --add_to_config ^
  --config_path C:\models\config.json ^
  --model_name OpenVINO/Qwen3-8B-int4-cw-ov ^
  --model_path C:\models\OpenVINO\Qwen3-8B-int4-cw-ov

ovms.exe --rest_port 8000 --config_path C:\models\config.json
第 5 步 · 用 OpenAI 客户端验证:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v3", api_key="unused")
r = client.chat.completions.create(
    model="OpenVINO/Qwen3-8B-int4-cw-ov",
    messages=[{"role": "user", "content": "用三句话解释 NPU 和 GPU 的区别"}],
    max_tokens=200,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},
)
print(r.choices[0].message.content)
三个提醒:
- base_url 写
/v3:官方 NPU demo 用的是这个前缀;客户端如果在/v1上报 404,换过来。 - 不支持批处理:OVMS 在 NPU 上会把并发请求排队串行执行,别拿它做多人服务。
- 速度预期:265H 官方 9 tok/s;更老的 NPU37XX 有用户记录 6.72 tok/s(Qwen3-8B INT4,加载 6.15 秒)。首字要等几秒,正常。
路线二:OpenVINO GenAI 写进 Python:模型必须先转成对称 4-bit
如果你要把推理嵌进脚本、批处理或自己的小工具,这条最直接。代价是模型不能直接用 GGUF 或 HF 原权重,必须导出成 OpenVINO IR,而且量化格式有硬要求。
python -m pip install "openvino==2026.4.1" "openvino-genai==2026.4.1.0" "openvino-tokenizers==2026.4.1.0" "optimum-intel[openvino]==2.2.0"optimum-cli export openvino -m Qwen/Qwen3-8B --weight-format int4 --sym --ratio 1.0 --group-size -1 Qwen3-8B-int4-cw--sym、--ratio 1.0、--group-size -1 三个参数不能省:NPU 要求对称 4-bit、通道级(-1)或分组 128;NF4 只有 Core Ultra Series 2(Lunar Lake)及更新才支持,老机器用 int4。
import openvino_genai as ov_genai

pipe = ov_genai.LLMPipeline(
    "Qwen3-8B-int4-cw",
    "NPU",
    {"MAX_PROMPT_LEN": 1024, "MIN_RESPONSE_LEN": 256, "CACHE_DIR": "./npu_cache"},
)
print(pipe.generate("用三句话解释 NPU 和 GPU 的区别", max_new_tokens=200))
默认 MAX_PROMPT_LEN 是 1024、MIN_RESPONSE_LEN 是 128,两者相加就是上下文上限。你把 1024 改成 4096,编译时间和内存都会上去;Series 2 上超过 7B 的模型、提示超过 1024 token 时,官方提示可能要 16GB 以上内存。
第一次编译几十秒到几分钟,之后靠 CACHE_DIR 或 EXPORT_BLOB 复用;别每次启动都重编。《IPEX-LLM 已归档:中文 Intel 显卡教程为什么集体过期》 里提到的老写法别再照抄,IPEX-LLM 已经在 2026 年 1 月归档。
路线三:ONNX 模型换 OpenVINO EP:device_type=NPU 与静默回退
手里已经有一堆 ONNX 模型(OCR 检测、分类、分割)的人,不用重导 OpenVINO IR,换执行提供者就行。
import onnxruntime as ort

sess = ort.InferenceSession(
    "model.onnx",
    providers=[("OpenVINOExecutionProvider", {"device_type": "NPU"})],
)
print(sess.get_providers())
两个坑:
- 包已经换代:
onnxruntime-openvino这个内置 EP 被官方标记为弃用,新项目建议换onnxruntime-ep-openvino(插件式 EP,注册方式不同)。老项目锁 1.24.1 还能用。 - 回退是静默的:NPU 只支持 FP16;遇到不支持的算子或模型,ORT 会回退 CPU,而且不一定报错。
get_providers()只能证明注册成功,不能证明每个算子都在 NPU 上。要看日志里的节点分配,或者用 OpenVINO 原生compile_model("NPU")做对照。
动态输入要先用 reshape_input 给每个维度写上界(格式 输入名[下界..上界, ...]);不写,NPU 的内存分配容易失败或直接回退。
路线四:llama.cpp 的 OpenVINO 后端:GGUF 能上 NPU,但别在 Meteor Lake 上指望它
这是唯一能直接吃 GGUF 的 NPU 路线,也是坑最多的一条。llama.cpp 官方文档写得很清楚:OpenVINO 后端仍是预览,NPU 只在 Lunar Lake(258V,32GB,Ubuntu 26.04.1,NPU 驱动 1.38.0)和 Panther Lake 上验证过。Meteor Lake 不在验证列表里。
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
call C:\Intel\openvino\setupvars.bat

cmake -B build\ReleaseOV -G Ninja ^
  -DCMAKE_BUILD_TYPE=Release ^
  -DGGML_OPENVINO=ON ^
  -DCMAKE_TOOLCHAIN_FILE=C:\vcpkg\scripts\buildsystems\vcpkg.cmake

cmake --build build\ReleaseOV --parallel
set GGML_OPENVINO_DEVICE=NPU
build\ReleaseOV\bin\llama-cli -m models\Qwen3-8B-Q4_K_M.gguf -c 512 -n 128注意:设备用环境变量 GGML_OPENVINO_DEVICE 选,不是 -dev。-c 一定要显式给小值,默认会按模型训练上下文(比如 131072)分配,NPU 上直接 OOM 或慢到不可用。
官方列出的 NPU 限制,挑几条最要命的:
- 静态图:prefill 块固定 256,批量 / 并发都不自由;
- 不支持
-np > 1:多并发直接拒绝; -fa off会失败:flash attention 保持默认-fa auto;llama-embedding在 NPU 上失败:embedding 放 CPU / GPU;- 首次加载要编译:大模型几分钟,别以为是卡死;
- Lunar Lake 上下文一大就掉速,Panther Lake 上 Qwen3.5 可能段错误,设
GGML_OPENVINO_NPU_CONFIG=COMPILATION_NUM_THREADS=1。
所以这条适合「我就要用 GGUF 试一下 NPU」的人;想稳定日用,回到路线一或二。
四条路线怎么选:门槛、上下文与验证平台
| 路线(难度) | 模型格式 | 上下文 | 并发 | 官方验证平台 | 适合谁 |
|---|---|---|---|---|---|
| OVMS(中) | OpenVINO IR(自动拉 int4-cw) | --max_prompt_len 可设 2000 | 串行 | Meteor Lake / Lunar Lake / Arrow Lake | 想要 OpenAI 接口、接客户端 |
| OpenVINO GenAI(中高) | IR,对称 4-bit | 默认 1024 + 128 | 单进程 | 全系 NPU(受形状 / 量化限制) | 写脚本、批处理 |
| ONNX Runtime EP(中) | ONNX | 由 reshape_input 定 | 一般 | 多平台 | 已有 ONNX 流水线 |
| llama.cpp OpenVINO(高) | GGUF | -c 显式指定 | 不支持多并发 | Lunar Lake / Panther Lake | 想用 GGUF 折腾 |
如果你只是想让 NPU 别闲着,优先路线一;如果要把 AI 功能嵌进现有 Python 工具,路线二;ONNX 老项目路线三;路线四是实验。
常见翻车报错与急救清单
| 报错 / 现象 | 最可能的原因 | 处理 |
|---|---|---|
available_devices 没有 NPU | 驱动没装、版本旧、系统不认 | 装 32.0.100.5600,设备管理器确认 Intel(R) AI Boost,重启 |
Cannot create plugin for device: NPU | OpenVINO 与驱动不匹配,或装的是精简包 | 装 2026.4.1 完整包;先跑 setupvars.bat |
ImportError: DLL load failed | 缺 VC++ 运行库或 PATH 不对 | 装 VC++ 2015–2022 x64;在 OVMS 目录跑 setupvars.bat |
Unsupported operation / 动态 shape 编译失败 | NPU 只吃静态形状(Series 1 / 2 H) | 固定输入尺寸;LLM 用 OVMS / GenAI 的固定桶,不要手写动态循环 |
| 编译几十秒到几分钟,以为卡死 | 首次编译 + 没有缓存 | 正常;设 CACHE_DIR 或 EXPORT_BLOB |
out of memory / 编译期 OOM | 上下文 / 批量太大 | MAX_PROMPT_LEN 降到 1024;-c 512;关掉其他占内存的程序 |
| ORT 速度像 CPU | 不支持的算子回退 | 开 ORT verbose 日志看节点分配;用 reshape_input 固定边界;用 OpenVINO 原生对照 |
onnxruntime-openvino import 报错 | 包与 ORT 版本不匹配,或 EP 已弃用 | 锁版本;新项目换 onnxruntime-ep-openvino |
llama.cpp 报 unknown argument: -dev | 设备选择方式错了 | 用 GGML_OPENVINO_DEVICE=NPU |
llama.cpp -fa off 失败 / embedding 失败 | NPU 限制 | 保持 -fa auto;embedding 放 CPU / GPU |
| Lunar Lake 上下文一大就掉速 / Panther Lake Qwen3.5 段错误 | NPU 静态图 + 编译器问题 | 控制 -c;设 GGML_OPENVINO_NPU_CONFIG=COMPILATION_NUM_THREADS=1 |
| 任务管理器没有 NPU 列,或有列但进程 0% | 系统版本 / KB / 灰度,或进程归因没开 | 24H2 / 25H2 + KB5089573 / KB5094126;右键列头勾选;看「NPU 引擎」是否显示 NPU - Compute |
什么情况下别折腾 NPU:三类劝退与一条替代路线
三类劝退:
- 想要 14B / 32B 聊天:NPU 上 8B 已经 6–9 tok/s,14B 更慢、内存压力更大;同机核显或独显更合适。
- 需要长上下文 / 多轮:默认 1024 token 的提示上限,聊天几轮就顶到;OVMS 可以设 2000,但再长要付编译和内存代价。
- 多人并发 / 服务化:OVMS NPU 串行,llama.cpp 不支持多并发;这不是服务器。
推荐留给 NPU 的活:
- 视频会议背景虚化 / 自动取景:系统已经在用,别关。
- 语音转写、OCR 检测、图片分类、超分:固定形状,NPU 的甜点区。
- 常驻、低占空比、要省电的后台任务:NPU 比 CPU / GPU 合适。
替代路线:如果你只是想在轻薄本上跑本地模型,同机核显走 OpenVINO 往往更快(站内《Vulkan、SYCL、OpenVINO:Intel GPU 三条路线怎么选》);AMD 的 XDNA 有 FastFlowLM / Lemonade 这种一键方案(《锐龙 AI 薄本跑本地智能体:卡人的不是显存,是驱动和内存》),Intel 这边没有同等体验的东西,这是现实。
最后一句:NPU 0% 不是故障灯,它更像一个「没人给它派活」的指示灯。你要做的不是盯着它,而是决定哪些活值得派给它。
你用的是哪一代 Core Ultra?任务管理器里 NPU 是 0%,还是能跑到 30%?把「型号 + 驱动版本 + 报错原文」贴在评论区,我帮你对号入座。
登录后可点赞、收藏与反馈。


