IPEX-LLM 已归档:中文 Intel 显卡教程为什么集体过期
intel/ipex-llm 已转为只读,Intel 安全公告建议卸载。本文用仓库字段与公告时间线核实归档事实,拆解旧教程会遇到的六类故障,给出十秒识别过期教程的三个特征,并梳理四条迁移路线。
2026 年 1 月 28 日之后,任何一篇教你 pip install ipex-llm[xpu] 的中文教程,都已经是一份失效文档。这不是社区判断,是仓库状态和 Intel 安全公告共同写死的事实。
后果比「停止更新」具体得多:新驱动不在验证范围,新模型架构进不来,依赖链只能往回走,而且 Intel 自己在 2026 年 8 月发了一份公告,建议用户卸载。
这篇文章把证据、后果、识别方法、迁移路径依次讲清。
归档是三个字段,不是一句传闻
GitHub 的 REST 接口对 intel/ipex-llm 返回 "archived": true,pushed_at 为 2026-01-28T17:32:40Z。仓库首页第一行写着 THIS PROJECT IS ARCHIVED,随后三句:Intel 不再提供或保证该项目的开发与支持,含维护、缺陷修复、新版本;不再接受补丁;该项目已被认定存在已知安全问题。
第三条不是免责套话。Intel 安全中心 2026-08-11 发布的 INTEL-SA-01465,标题是「Intel® LLM Library for PyTorch Software Advisory」——这正是 IPEX-LLM 的官方产品名。
编号 CVE-2026-21387,CVSS 4.0 评分 5.4,影响范围写「所有版本」,处置建议是发布产品停用通知、建议用户尽快卸载或停止使用。
一份厂商公告里同时出现「停用」和「不可修复」两个词,含义是明确的:这不是等你升级到 2.3 就能解决的问题,而是这条路本身被取消了。
顺带纠一个高频混淆:intel-extension-for-pytorch 是另一个仓库,缩写同样叫 IPEX,2026-03-30 之后也已归档。两个仓库、两个日期、两份 README,中文教程经常把它们当成同一个东西,于是「IPEX 还在更新」这种说法能一直流传。
| 时间 | 发生了什么 | 可查位置 |
|---|---|---|
| 2025-04 | 最后一个正式版 2.2.0 上传 PyPI,同一版带 Ollama / llama.cpp Portable Zip | pypi.org/project/ipex-llm |
| 2025-05 | README 的「Latest Update」停在这一条,此后没有新条目 | 归档前 README |
| 2026-01-28 | ipex-llm 最后一次提交,仓库转为只读 | GitHub API pushed_at |
| 2026-03-30 | intel-extension-for-pytorch 最后一次提交 | GitHub API pushed_at |
| 2026-08-11 | INTEL-SA-01465 发布,建议卸载 | Intel 安全中心 |
这张表有个容易忽略的细节:README 的最后更新停在 2025 年 5 月,归档发生在 2026 年 1 月。也就是说,这个项目在正式宣告死亡之前,已经安静了八个月。对读者来说,这段时间里所有「最新版 IPEX-LLM」的说法都已经不成立,只是没人去改标题。
坏掉的是三样东西,不是一样
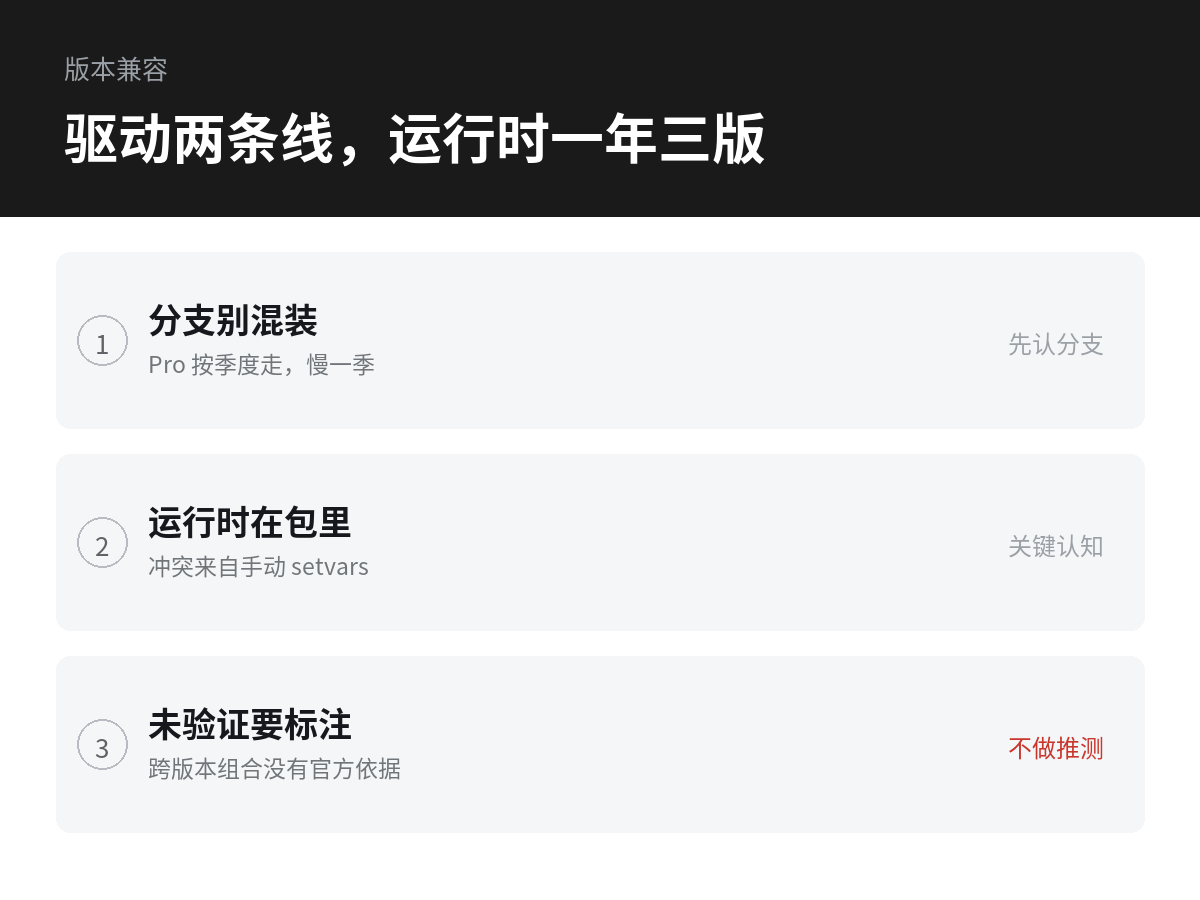
第一样是驱动适配。 归档前的安装文档只说「驱动低于 31.0.101.5122 需要升级」,没有上限。这句话在 2025 年成立,因为当时驱动就在这个量级。而现在消费级驱动是 32.0.101.9175,中间跨了十几个月、十几个版本,Level Zero 的接口与默认行为都动过。
wheel 里打包的运行时是 2025 年初的版本,这个组合不在任何一张验证表里。不在表里不等于必然崩,但出问题时没有一方会认——框架说驱动太新,驱动说软件太旧。
第二样是新模型。 IPEX-LLM 的推理路径依赖两套东西:ipex_llm.transformers 里的 Python 补丁,和 Portable Zip 里那个固定版本的 llama.cpp。前者跟 transformers 的版本强绑定,后者是编译死的二进制。
GGUF 文件头里写着架构名,这个字符串必须被二进制里的架构表认识,否则直接退出。一个 2025 年 4 月编出来的二进制,不会认识之后才进 llama.cpp 的架构。模型越新,这条路越快撞墙。
第三样是依赖链方向。 现在的 Intel GPU 主线是 PyTorch 2.15(2026-09 的 XPU 文档)、oneAPI 2026.2、llama.cpp 的每日构建。IPEX-LLM 2.2.0 的发布说明里写的是新增 PyTorch 2.6 支持。装它不是为了升级,是为了把整条链往回退九个次版本,顺带退掉 oneDNN、oneMKL 和 transformers。
九个次版本意味着什么,做过环境的人清楚:不是一次 pip install 的事,是这个环境里其他所有包都要跟着降级,而降级又会撞上别的包的版本下限。最后只能开一个专用环境,永远不会再升级。
三样叠在一起,结论很干脆:它不是一个「还能用但没新功能」的旧工具,而是一个被厂商点名建议卸载的组件。
它其实还能跑,但只在很窄的条件下
把话说全:归档不等于文件消失。PyPI 上的 2.2.0 仍然能下载,Portable Zip 仍然能解压,2025 年的模型仍然能加载。如果你的场景是断网机器、模型固定、只给自己用,那么这套东西今天仍然能跑出结果。
这个「能跑」有三个前提,缺一个就不成立。
驱动得停在原地。整套东西验证过的驱动在 2025 年上半年,你现在装的 9175 是之后的版本。只要它现在没出问题就别动——但显卡驱动往往被系统更新或游戏需求推着走,这个前提很难长期维持。
模型得不再换。已经下载好的 GGUF 文件不会过期,但任何一次「试试新模型」的冲动都会撞上架构表。这条最容易破,因为本地部署的动机之一就是想随时换模型。
机器最好不对外。CVE-2026-21387 的前提是本地访问加上高权限用户,单人工作站的风险敞口明显小于多人共享或对外提供服务的主机。
三条都满足,继续用是理性选择,只是要接受「这条路不会再变好」。任何一条不满足,迁移的收益就大于成本。判断标准不是项目死没死,而是你的使用方式有没有越过它的边界。
为什么偏偏是中文教程过期得最彻底
这件事有结构性原因,不是作者偷懒。
中文技术教程的生产链条通常是:读官方 README 与 quickstart,截图,翻译,补几句自己的踩坑记录。这条链条在项目活跃时是有效的,因为源头会更新,作者会追。项目一归档,源头冻住了,教程也就跟着冻在最后一版——而它看起来仍然完整,命令、截图、预期输出一样不缺。
更麻烦的是外部信号。仓库的 star 数还在八千八百多,fork 数一千四百多,这些数字不会因为归档而清零,反而成了「这个项目很主流」的证据。搜索结果的排序也不看维护状态。读者看到的是热度,不是日期。
再加上一层语言时差。Intel 的安全公告发在英文安全中心,归档状态显示在 GitHub 页头,两者都不会出现在中文教程的正文里。信息不是不存在,是不在读者会去看的那个位置。
所以「集体过期」不是巧合,是三个机制叠加的必然结果:源头冻结、热度残留、告警不在中文视野里。
照旧教程做,会卡在哪一步
把 2023 到 2025 年流传最广的那套步骤逐条走一遍,大概会在这些位置停住。
| 教程里的动作 | 现在的结果 | 原因 |
|---|---|---|
pip install --pre --upgrade ipex-llm[xpu] --extra-index-url .../stable/xpu/us/ | 解析到 2.2.0,并按它的依赖声明拉取旧版 torch | 索引停止更新,--upgrade 只会拿到最后一版 |
conda create -n llm python=3.11 libuv | 环境能建,但装完 ipex-llm 后 torch 被钉回旧区间 | 该库的依赖声明限定了它能用的 torch 版本 |
| 下载 2025 年的 Ollama Portable Zip | 能启动,但拉不动后来新增架构的模型 | Zip 内是固定版本的 Ollama 与 llama.cpp |
| 按文档「升级到 5122 以上」 | 实际驱动已是 9175,组合未经验证 | 文档没有写驱动上限 |
AutoModelForCausalLM.from_pretrained(..., load_in_4bit=True) | 取决于 transformers 版本,可能直接抛参数错误 | 该接口是 IPEX 自己的分支实现,非上游 API |
按教程设置 SYCL_CACHE_PERSISTENT=1 | 可能卡在加载阶段,需要清缓存目录才恢复 | 编译缓存是隐式状态,换驱动或运行时后容易失效 |
表里那行 AutoModelForCausalLM 要留余地:它到底报不报错,取决于你装的 transformers 版本。能确定的是,这套 Python 接口从来没有进过上游 transformers,它只存在于那个已经只读的仓库里。
真正要紧的是这张表背后的顺序问题——大多数人不是被某一条错误挡住,而是先花两小时配好环境,最后才发现自己在给一个停用的库打补丁。错误信息不会告诉你「这个项目没人管了」,它只会说找不到符号、内存分配失败、或者干脆卡住。
三个特征,十秒认出过期教程
不需要读完,扫一眼就能判断。
特征一:出现 ipex-llm、bigdl、ipex_llm.transformers 中的任意一个。 只要安装命令里带这几个词,这篇教程的路线就已经不是当前路线。相关但不同的写法是 intel-extension-for-pytorch、intel_extension_for_pytorch,同样已归档。
特征二:让你下载 Portable Zip。 Ollama Portable Zip、llama.cpp Portable Zip 是 IPEX-LLM 独有的分发形式,官方 llama.cpp 和 Ollama 都不这么做。看到「解压即用、免安装」的 Intel 显卡包,基本可以判定来源。
特征三:只给驱动下限,不给日期。 靠谱的教程会写清「本文基于某年某月的驱动与某个构建号」。只写「请升级到最新驱动」而不写验证时间的,通常意味着作者自己也没在近期跑过。
还有一个间接信号:文章里出现的模型是 Qwen2、Llama 3.1、ChatGLM4 这一代,且没有提到任何 2025 年下半年之后的模型。模型名比发布日期更诚实——作者会忘记改标题里的年份,但不会忘记改示例里的模型。
迁移:四条能走的路
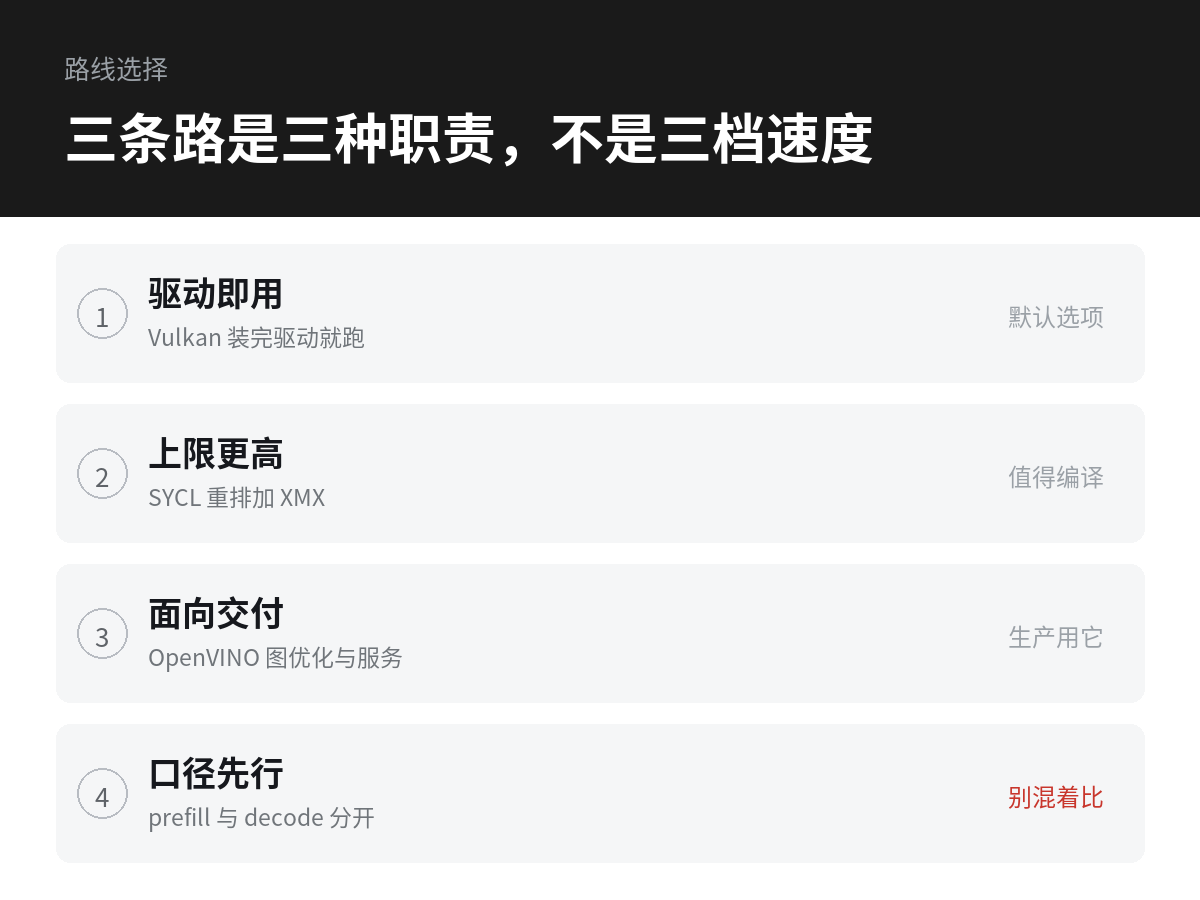
Vulkan,最省事。 不碰 oneAPI,只要有正常的显卡驱动。Ollama 从 0.30 起默认启用 Vulkan,覆盖 Intel 与 AMD 设备;LM Studio 在 Windows 上提供 Vulkan 运行时;自己编 llama.cpp 只需要一个开关。
# 自己编译(Windows 与 Linux 相同)
cmake -B build -DGGML_VULKAN=ON
cmake --build build --config Release -j
# 运行,确认日志里出现 ggml_vulkan 与设备名
./build/bin/llama-cli -m model.Q4_K_M.gguf -ngl 99 -p "hello"
代价要说清楚:Vulkan 后端在 llama.cpp 里对 I-quants 只支持一部分,多卡只能顺序切层。日常单卡聊天完全够用,想压榨 prefill 就不是它擅长的。
原生 XPU,要写 Python 时用。 直接用 PyTorch 官方的 XPU wheel,不再套一层 IPEX。
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/xpuimport torch
print(torch.xpu.is_available()) # False 就先查驱动
x = torch.randn(1024, 1024, device="xpu")这条路覆盖 Arc A/B 系列与 Core Ultra 的核显,支持训练与推理、eager 与 torch.compile。它的边界是:Arc A 系列不原生支持 FP64,用 AMP 训练时官方文档要求关掉 GradScaler。
SYCL,要性能上限时用。 需要 oneAPI,或者直接用官方预编译包(包内自带运行时,不必装 oneAPI)。2026.02 起这个后端只支持 Intel 设备,NVIDIA / AMD 插件已被移除,反而让目标更清楚。
source /opt/intel/oneapi/setvars.sh
cmake -B build -DGGML_SYCL=ON -DCMAKE_C_COMPILER=icx -DCMAKE_CXX_COMPILER=icpx -DGGML_SYCL_F16=ON
cmake --build build --config Release -j
:: Windows,先开 oneAPI 命令提示符
call "C:\Program Files (x86)\Intel\oneAPI\setvars.bat" intel64 --force
cmake -B build -G Ninja -DGGML_SYCL=ON -DCMAKE_C_COMPILER=cl -DCMAKE_CXX_COMPILER=icx -DGGML_SYCL_F16=ON
cmake --build build --config Release -jOpenVINO,做部署时用。 它是四条里唯一面向交付的:模型转 IR、图级优化、可上 Model Server。llama.cpp 也提供了 -DGGML_OPENVINO=ON 的后端,能把同一份 GGUF 交给 OpenVINO 在 CPU / GPU / NPU 上跑,但文档写明性能与算子覆盖仍在开发中。
四条路的取舍、上手成本与性能上限,在三条路线各自的坐标里单独拆开讲。这里只需要记住一点:原来那条路已经封了,其余四条都还在维护。
迁移不必一步到位。最省力的顺序是先换掉外层客户端——把 Portable Zip 换成官方 Ollama 或 llama.cpp 的 Vulkan 构建,模型文件不用动,半小时能完成,日常使用立刻回到正轨。等有了具体需求,再决定要不要为 SYCL 装一套 oneAPI,或者为部署引入 OpenVINO。反过来先啃工具链,很容易在编译阶段耗尽耐心,最后回到那个已归档的环境里将就。
确认自己有没有踩在老路上
三步,一分钟。
# 1. 环境里是否残留
pip show ipex-llm
conda env list | grep -i llm

# 2. 用的是哪个二进制、哪个版本
llama-cli --version
ollama --version

# 3. 驱动与运行时三层
xpu-smi query        # Linux,能同时看到 UMD / KMD / Level Zero loader
Windows 上把第三步换成设备管理器里看驱动程序版本,或者在 Arc Control 里查。
如果第一条有输出,说明你的环境还在用那个已归档的库。不必立刻删,但要清楚两件事:它不会再有安全修复,也不会认识下一个新模型。
判断迁移优先级的方法很简单——看你现在跑的东西有没有踩到上面任意一条。跑得动、不联网、模型固定,迁移可以从容做;一旦要换新模型或者把服务暴露到网络上,那条 CVE 就从「已知问题」变成「你的问题」。
该库归档前的 README 自己就留过一个警告:llama.cpp Portable Zip 用 mmap 加载模型,在多租户或共享主机环境可能通过侧信道泄漏数据,建议加 --no-mmap。一个连自家文档都要提醒数据泄漏的项目,再挂着它跑线上服务,风险是自己选的。
ipex-llm 那条路走到 2026 年 1 月就断了,中文教程的更新速度比仓库慢了一年。认出过期教程比修复它更省时间:看到 ipex-llm 三个字直接关掉,从 Ollama 的服务与客户端之分那条线重新开始,比在旧环境里补依赖快得多。
真要自己编,预编译包和自编译怎么选里写了构建号怎么对应;动手前先算显存,可以参考显存与精度对照表。
登录后可点赞、收藏与反馈。