Manus 的交付逻辑:从一句话到一份成品
Manus 的输出往往是一个文件而不是一段回答。本文讲清它如何拆任务、调工具、合成交付物,以及可复现性、过程透明度与数据边界三个约束。
Manus 的输出通常不是一段回答,而是一个文件:一份调研报告、一张竞品清单、一套整理好的表格,或者一个能点开的页面。这个差别看起来小,实际决定了它的用法——你要的是成品,所以验收标准也得按成品来定。
一句需求怎么变成一份成品
它的工作方式可以概括成三步:先拆任务,再调工具,最后合成交付物。
拆任务是关键。一句"帮我看看这个行业",它会先分出几个子问题:市场规模、主要玩家、产品形态、定价区间、监管口径。子问题决定了后面去哪些源找资料,也决定了成品的骨架。
调工具是过程:开浏览器检索、抓页面、必要时写代码做清洗和计算、把结果落到表格或文档里。运行环境是云端沙箱,不占用你的电脑,也不需要你在旁边确认每一步。
合成是收尾:把中间产物整合成一份结构完整的文件。这一步最容易被低估——把十个网页的信息压成三页纸,难点不在检索,在取舍。
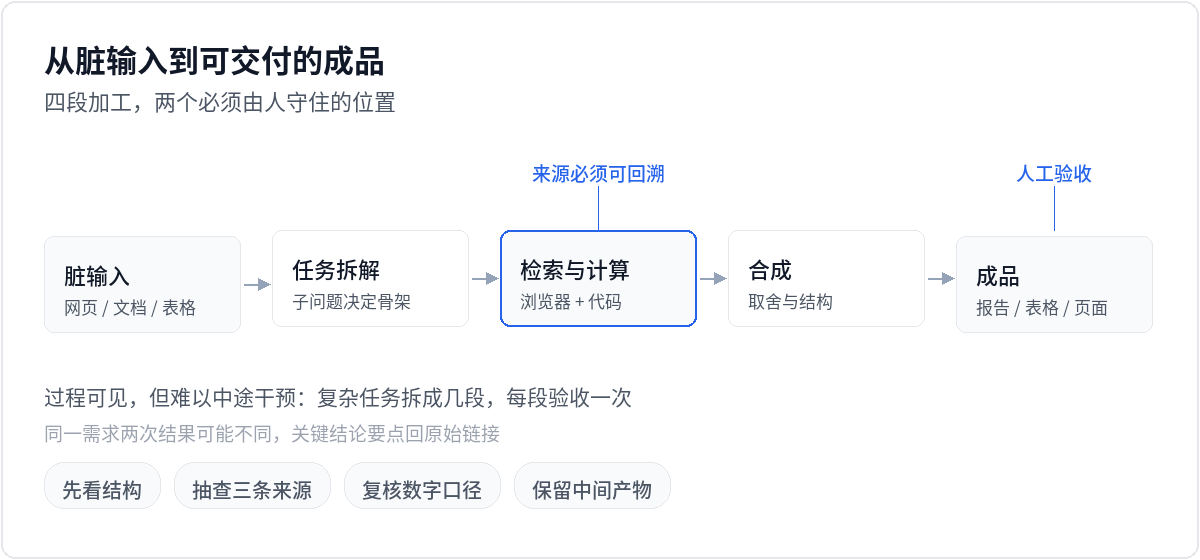
图 1 四段加工,两个必须由人守住的位置
它真正擅长的是"信息加工"
把它的能力和编码 Agent 分清楚,能省很多试错。
Manus 的强项是处理"分散、异构、需要整理"的信息:市场与竞品调研、供应商或线索清单的收集与清洗、会议与访谈材料的归纳、把一堆零散数据变成可读的表格和图表。这些任务的共同点是——输入是脏的,输出要干净,中间需要人做大量机械判断。
它不擅长的是需要长期维护的工程工作。改一个持续迭代的代码库、保证每次改动都不破坏已有功能,这类活需要稳定的上下文和可重复的验证,不是"一次任务一份成品"的模式能覆盖的。
换句话说:它擅长把一次性的事做完,不擅长把持续的事做好。
三个现实约束
第一,可复现性。同一个需求提两次,路径和结果可能不同。这对"参考"没问题,对"必须可审计"的场景是硬伤。解决办法是把关键结论回溯到来源,要求它保留引用链接,而不是只给结论。
第二,过程透明度。你能看到它做了什么,但很难在过程中干预。如果任务跑到一半方向偏了,通常只能等它结束再重做。所以复杂任务应该拆成几段,每段验收一次,而不是一次许一个很大的愿。
第三,数据边界。它会访问你给的资料、可能访问公开网页、在你的授权范围内读取本地文件夹。哪些数据可以进去、哪些不行,要在派任务之前想清楚,而不是事后检查。
和另两类工具的分界
和编码 Agent 比:一个交付代码改动,一个交付文档与数据成品。它们的验收方式完全不同——代码靠测试,文档靠人读。别用同一套标准去衡量。
和 Dify、n8n 这类平台比:那两类是"你自己搭一套系统,让它稳定地重复运行";Manus 是"你提一个需求,它这次给你做完"。前者买的是可重复性,后者买的是即时性。业务流程要跑一千次,应该上平台;这件事只做一次,用通用 Agent 更划算。
这个区分很重要,因为很多团队一开始就想"把调研流程自动化",结果发现真正需要的是先把一次调研做对——那就该先用通用 Agent 跑通,再考虑固化。
用它的人该有的验收习惯
第一,先看结构对不对,再看细节。章节顺序错了,说明任务拆解偏了,改细节没意义。
第二,抽查来源。随机挑三个结论,点开它给的链接,看原文是否支持这个说法。这一步能筛掉大部分"看起来很像"的错误。
第三,数字要复核。它会把不同口径的数据放在一起比较,而口径不一致是这类报告最常见的硬伤。
第四,保留中间产物。表格、原始抓取结果、代码片段,这些东西的价值往往高于最终报告——下次同类任务可以直接复用。
它适合谁
适合需要频繁产出"研究型交付物"的岗位:市场、运营、咨询、投研、内容策划。也适合工程团队做技术选型前的资料收集——把十篇文档压成一页对比表,比人读快得多。
不适合需要严格合规审计的场景,也不适合替代有明确 SLA 的业务系统。它是"帮你把一件事做完"的工具,不是"保证每件事都一样"的基础设施。
最后提一句:通用 Agent 的产出质量,取决于你能把需求描述到多具体。这和云端编码 Agent 是同一个道理——Codex 那篇说的"定义清楚、验收明确",换成调研任务同样成立:能写成简报的活它做得不错,需要当面沟通才能说清的活,交给它只会更快地产生返工。
登录后可点赞、收藏与反馈。