DeepSeek 聊天记录导出后:建索引、写交接单、别被覆盖
11 月 16 日起,DeepSeek 的 C 端开始限制长对话:超过 7 天不活跃就接不上,单次输入约 4 万字,每日还有额度。这篇不讲怎么绕,讲怎么把记录搬成本地资产:本地索引、交接单、分片,附零依赖脚本与实测数字。
11 月 16 日,「DeepSeek 使用额度已达上限」上了热搜。同一天多家媒体转述了用户遇到的提示:由于算力不足,不再支持超过 7 天不活跃的长对话,单次输入文字上限缩短到约 4 万字,每日对话额度也开始限制。
标题里常见「7 天删除」的写法,但弹窗原文是「不再支持超过 7 天不活跃的长对话」。记录还在,回不去的是那个上下文——新开一个窗口,你得从头解释项目背景、已定方案和踩过的坑。
这篇只解决一件事:把攒下的对话变成存在自己手里、能查、能接着用的东西。三步,全程本地,附一个零依赖脚本。
一、先看清限制卡在哪一步
三条限制的影响完全不同。混在一起看,只会得出「换个平台」这种没用的结论。
| 限制 | 实际影响 | 该做什么 |
|---|---|---|
| 7 天不活跃的长对话不可接续 | 上下文断档,不是数据丢失 | 把结论落到本地,别只留在窗口里 |
| 单次输入约 4 万字 | 长文档、贴日志会被截断 | 按边界分片,片首放索引 |
| 每日对话额度 | 长任务可能做到一半被掐 | 每步落盘,做成可续的检查点 |
三条里只有第一条不可逆。额度等一天会恢复,输入长度可以分片,但一个断掉的上下文如果没留下结构化记录,就是真的没了。
然后是导出。官方路径写在隐私政策里(2026 年 2 月 10 日版):点击头像账号区域 → 选择「设置」→ 选择「数据管理」→ 导出所有历史对话。手机 App 里找不到对应菜单时,用手机浏览器打开网页版走同一路径。
导出拿到的是一个压缩包。它解决「保存」,不解决「再用」,有四个局限要先知道:
- 它是快照。导出之后的新对话不在里面,也不会自动更新。
- 下载链接有时效。多方实测为 7 天,官方页面没有标注这一点,过期要重新申请。
- 已被删除的对话不在包里。
- 非图片附件的原件不保证在包里,通常只剩文件名和大小。
最后一条在 DeepSeek 11 月 13 日开源的 chat-demo 里写得很明确:导出包包含对话与本地存在的原图,不包含 API Key、配置项和非图片类原始附件。
这个开源前端顺带解决了一部分「接续」问题:MIT 协议的纯静态页面,有用户实测把官网导出的压缩包导进去能接着聊。但它的仓库文档只定义了自家的 v3 归档格式,没承诺兼容官网导出包,手机端导出的包还有「传上去没反应」的反馈——别把迁移全押在这一条上。另有一个必须先知道的默认行为——导入会覆盖全部本地对话和附件。官方 README 的原话是「After confirmation and successful validation, importing replaces all local conversations and attachments.」先导入一份新的,之前那份就没了。搜「备份会被覆盖吗」的人,问的多半就是这件事。
还有两个边界:直接用 file:// 双击打开 index.html,需要浏览器允许本地页面使用存储,并且 API 服务允许跨域;它默认走 Anthropic 兼容的 Messages 接口,换后端要先确认协议对得上。
二、建本地索引:先解决中文分词
导出包打开是一堆 JSON。能读,但没法用。一份跑了三个月的技术会话,120 轮、240 条消息、1.4 万字,想找「脱敏规则最后是怎么定的」,只能一条条往下翻。
用 SQLite 的全文检索建索引,这件事十分钟能做完。这类效率工具不产生新内容,只负责让你找得到旧内容。坑在中文。
SQLite 自带的 unicode61 分词器把连续汉字当成一个词。于是「合同审查」是一个词,「合同」不是——查两字词,命中数为零。拿三句话、五个查询实测:
| 方案 | 实测命中与原因 |
|---|---|
| unicode61(默认) | 0/5 命中。整段汉字算一个词,两字三字都查不到 |
| trigram | 2/5 命中。三字以上可用,「合同」「代码」失效 |
| 自己切 bigram | 5/5 命中。索引与查询都要过同一个函数 |
bigram 的做法很土:把连续汉字切成两字滑窗,「合同审查」变成「合同 同审 审查」,查询时同样切。土,但两字词是中文里最高频的查询,这一层不能省。
def bigram(s: str) -> str:
    """CJK 连续串切二字滑窗;非 CJK 保留原词并小写。"""
    out = []
    for run in re.findall(r"[\u4e00-\u9fff]+|[A-Za-z0-9_.%/#:+-]+", s):
        if "\u4e00" <= run[0] <= "\u9fff":
            if len(run) == 1:
                out.append(run)
            else:
                out.extend(run[i:i + 2] for i in range(len(run) - 1))
        else:
            out.append(run.lower())
    return " ".join(out)
建表时把原文和切好的串分开存:原文给人看,切好的串给索引。
create virtual table msg_fts using fts5(
  idx, conv_id unindexed, msg_id unindexed, tokenize='unicode61'
);
insert into msg_fts(idx, conv_id, msg_id) values (?, ?, ?);
select conv_id, msg_id from msg_fts where msg_fts match 'idx:"脱敏"';
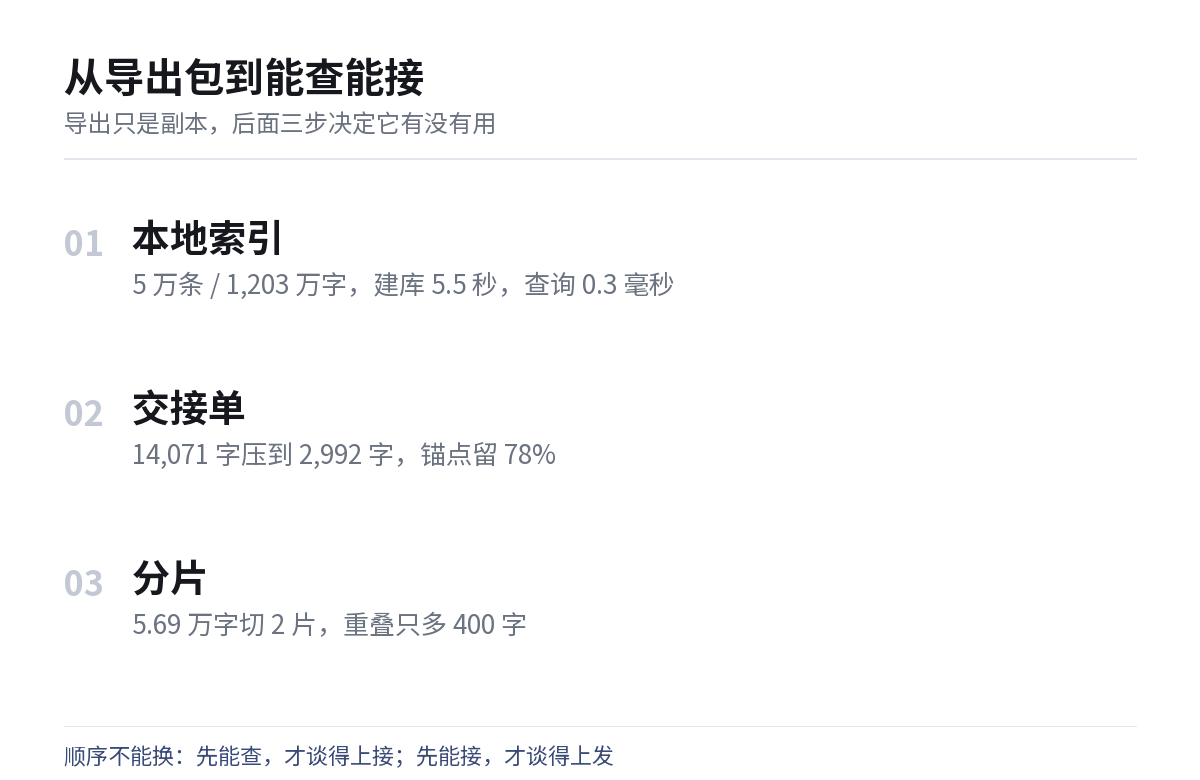
规模上不必担心。5 万条消息、1,203 万字,建库 5.5 秒,单次查询 0.2 到 0.4 毫秒。这个量级已经超过多数人几年的对话总量。
一个必须记住的约束:索引和查询必须走同一个分词函数。改了一边忘了另一边,结果永远是 0 命中,而且不报错。
三、写交接单:别把整段对话丢给新窗口
上下文断了之后,最常见的做法是把整个对话复制进新窗口,让模型「接着上面的聊」。两个问题。
第一,塞不进去。1.4 万字的会话还行,但带代码和日志的技术会话很容易到五六万字,超过单次输入上限。第二,就算塞进去了,模型会平等对待每一句——「你好,帮我看看」和「金额必须取整到百元」在它眼里权重差不多。
真正要交接的不是全文,是当前状态。我按三条规则从对话里抽句子:含约束词的(必须、不要、只能、禁止)打 3 分,含结论词的(定了、采用、改成)打 2 分,每个事实锚点(版本号、路径、阈值、口径)打 2 分,含待定词的打 1 分;再按「分值 ÷ 字数」贪心装进预算。
同一份 1.4 万字会话,三档预算的结果:
| 预算 | 压缩比 | 锚点保留 |
|---|---|---|
| 1,500 字 | 9.4 倍 | 51% |
| 3,000 字 | 4.7 倍 | 78% |
| 5,000 字 | 2.8 倍 | 100% |
这张表推翻了一个直觉:交接单不是越短越好。压到 3,000 字,72 个事实锚点里丢了 16 个;压到 1,500 字,丢一半。丢掉的多半是阈值、路径、版本号这类「看起来啰嗦」的东西,而它们恰恰是后面返工的根源。
但真正麻烦的不是漏,是冲突。
脚本在 3,000 字这档报了 11 处「同一锚点被多条约束提及」。人工核对后,其中 4 组是新旧值并存:
- 批次:早期定 5,000 条,后来因为内存降到 3,000 条
- 明细保留:先 90 天,后改 180 天
- 启动时间:6 点,后改 5 点 30 分避开备份窗口
- 渠道数:6 个,运营确认后变 7 个
四组都完整地进了交接单。把这份交接单交给任何模型,它都会同时看到「每批 5000 条」和「就用 3000 条」,然后自己挑一个。它不会告诉你挑了哪个,也不会说这里有矛盾。
这比漏一条约束危险得多。漏了,结果是做不到;冲突了,结果看起来一切正常,直到对账时数字对不上。
所以交接单要加一栏,脚本不填,人填:
| 项 | 历史值 | 当前有效值 |
|---|---|---|
| 批次大小 | 5000 → 3000 | 3000 |
| 明细保留 | 90 天 → 180 天 | 180 天 |
| 启动时间 | 6:00 → 5:30 | 5:30 |
规则只有一条:废弃的值划掉,不要删掉。删了,下一个人会重新提一遍;留着并标注「已废弃,原因是内存」,才拦得住。
四、分片与排队:把上限变成流程
4 万字上限不是靠「写短一点」解决的,靠切。分片在文档处理里是老动作:按结构切,不按长度切。
一份 5.69 万字的规范文档,按字数硬切 40,000 与 16,908 两片,第二片开头是一句被切断的话——它承接的条款在上一片末尾。改成按段落边界切,两片是 39,919 和 17,387,没有一句被切断,代价是 400 字重叠,只多 0.7% 的长度。
重叠只能救「被切断的句子」,救不了「跨片引用」。第 3 条写「按第 4 条的约定整改」,而第 4 条在下一片,重叠多少字都没用。办法是在每片开头放一张索引表,写清这一片包含哪些条款区间、哪些引用指向别处。
分片规则三条:
- 按段落、条款、代码块边界切,不按字数均分。
- 重叠留 300 到 500 字,够接住一个被切断的段落。
- 片首放索引表,别指望模型自己发现引用在别处。
每日额度是另一个问题。它不是「做不完」,是「做到一半停下,前面的白做」。对策是把任务拆成有落盘的检查点:每完成一步写一次中间结果,额度用尽时下次从最后一个检查点继续。
写代码的场景已经有现成做法——把长任务拆成「读、改、测」三段,每段结束落一次 diff。更细的成本排查可以看Token 消耗太快怎么查,那篇讲的是调用次数怎么被放大。
最后,如果你今天只做一件事:把导出包下下来,原样存一份,别动它。 剩下的三步可以慢慢做。
一、今天导出,原包别动。 链接会过期,重新申请要等,包里的东西也不会补全。
二、建索引,用三个你记得的词验证。 搜不到就是分词没对上,不是数据没进去。
三、交接单只写当前有效值。 废弃的值划掉并写明原因,不要删。
四、分片按边界,片首放索引。 重叠救句子,索引救引用。
五、别把导出包丢给来路不明的在线工具。 包里是全部对话,含你贴过的所有东西。
两句边界要说清楚。这套方法对工作型对话有效——需求、约束、结论都能结构化;对陪伴型的长对话无效,那种上下文不是靠交接单能重建的,导出只是留个纪念。AI 办公里真正难的部分很少是生成,多半是留存和交接。另外,如果你要的是团队共享的知识库而不是个人归档,AnythingLLM 离线部署那条路更合适,前提是三个:内网机器、可控的文档源、愿意维护。
这轮限制会不会变成常态,现在没有官方说法。11 月 13 日那篇额度管理的前情里,我把「可能有付费方案」这个猜测排除过一次——到今天仍然没有任何套餐、价格或支付入口。能确定的只有一件:你攒了几个月的对话,只有存在自己手里才算数。
登录后可点赞、收藏与反馈。