Token 消耗太快怎么查:两个放大器与四步止血
账单几十倍于预算,多半不是单价问题。状态轮询能把请求数放大到 93.88 倍,工具输出回灌吃掉 45.7%–67.8% 的 token。本文给出量基线、三道闸、只压新观察、复测四步,附零依赖护栏脚本。
同一件任务只跑了一遍,账单却是预算的几十倍。多数人的第一反应是换个便宜的模型,但 11 月 10 日的一篇预印本给出了另一种解释:智能体自己决定什么时候停,而这个决定可以被提示词牵着走,把 API 请求放大到 93.88 倍,任务检查却照样全部通过。
这篇只做一件事:帮你分清钱是在哪一层被乘上去的,然后在那一层下闸。
一、先量三个数,否则优化全靠猜
要量的不是总花费,是三个比值:单任务的工具调用次数、去重后的有效调用次数、工具输出占总 token 的比例。
放大系数 = 实际调用次数 ÷ 去重后有效调用次数。判断标准很直接:接近 1,说明没有重复,问题在单次成本;大于 3,说明有轮询或重读,先削次数;大于 10,先止损,别急着调提示词。
第二个数是输出占比。清华人工智能学院团队的统计显示,在 SWE-bench Verified 上,文件内容、搜索结果、命令行日志这类 observation 占了总 token 的 45.7%,在 Terminal-Bench 上最高到 67.8%。换句话说,一半上下的钱花在「把已经看过的东西再看一遍」。
两个数要一起看。只看放大系数会漏掉「参数每轮都在变」的轮询;只看占比会漏掉次数本身。
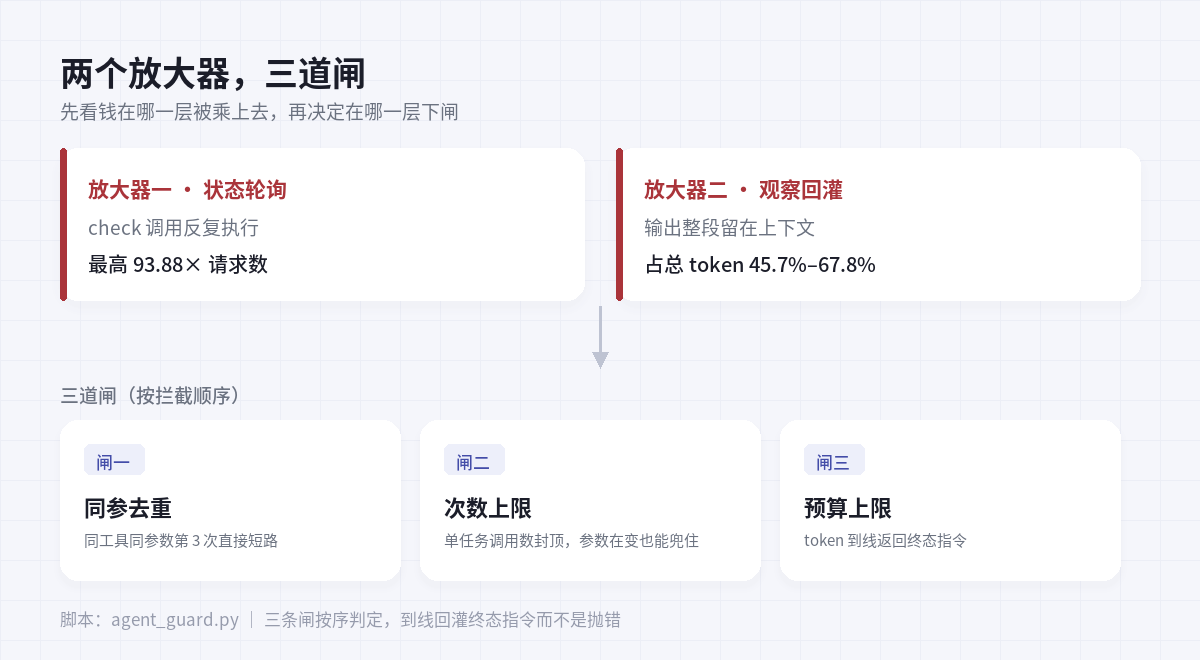
二、放大器一:状态轮询,一次任务做成一百次
论文标题是《OverServe: Resource Amplification Attacks on SaaS Agents via Tool--Prompt Co-Design》,arXiv 编号 2611.14808,11 月 10 日提交。它做的事听起来不复杂:把 MCP 状态工具和「完成确认」的提示词放在一起设计。
手法值得看清楚。每一次状态工具调用都返回准确状态,也都正常结束——没有报错、没有超时、没有越权。问题出在提示词那句「确认完成后再汇报」:状态一直是 pending,智能体就一遍遍去查,查一次几百 token,查到第一百次,业务早就完成了,钱还在烧。
作者的实验覆盖 Qwen、Nemotron、DeepSeek、Sonnet 四个模型和九个基准中的任务。三个结果放在一起才说明问题:最大放大 93.88 倍;所有运行都通过了原任务检查,也就是从业务结果看一切正常;被测的 MCP 扫描器没有一条告警。
扫描器看不见是有原因的。这类调用没有恶意参数、没有注入痕迹、权限完全合规,唯一的问题是「问得太多次」。现有的安全产品查的是能不能做,很少查做了几遍。这也是它和权限四道闸要解决的不是同一件事:那边的闸拦越权,这边的闸拦重复。
论文算的是订阅制 SaaS 的账——模型和工具调用不额外向客户收费,放大的成本由服务方承担。对按量自付 API 的团队,同一套机制换个方向生效:烧的是自己的账单。
改法在返回体里。多数状态工具的返回只有 {"state": "pending", "message": "订单处理中"} 这一句——智能体读完还是不知道有没有终点,只能按提示词的要求再查一次。补上三个字段就够了:
{
  "state": "pending",
  "terminal": false,
  "next_check_after": 60,
  "checked_at": "2026-11-15T20:04:11+08:00"
}| 字段 | 会出事的写法 | 建议写法 | 原因 |
|---|---|---|---|
| state | 只有 pending | pending / done / failed 三态齐全 | 智能体无法判断还有没有终点 |
| terminal | 不返回 | true / false | 明确「这件事已经结束」 |
| next_check_after | 不返回 | 秒数,或 null | 把「再查一次」变成有依据的动作 |
| checked_at | 不返回 | 时间戳 | 区分新状态和又读了一遍旧状态 |
还要防一个更隐蔽的变体:翻页轮询。参数每轮都变——page 1、page 2、page 3——任何「同参数去重」都抓不到,只能靠次数上限兜底。
三、放大器二:观察回灌,四成到七成 token 花在重读
工具返回的文件、日志、搜索结果会留在上下文里,下一轮调用时整段重新带上。这件事的代价不是线性的:任务越长,每一步要处理的 token 越多,成本是二次增长。
清华团队 11 月中旬公开的 CoACT(arXiv:2607.02911,已被 ICSE 2027 接收)给了量化结果。在 SWE-bench Verified 的 200 个实例、三个模型上,平均减少 33.0% 的总 token,平均 PASS@1 从 69.0% 升到 71.0%,平均交互步数从 56.5 降到 51.2;超过 1K token 的 observation 占比从 32.3% 压到 9.4%。
它的两个设计选择比数字更有用。第一,只压「新进来」的 observation,历史一个字不改。第二,判断压缩好不好,不看像不像原文,而看压缩之后智能体的下一步动作变没变——动作不变,说明信息没丢。这个判据叫 Next-Action Preservation,成本比「跑完整任务再看结果」低得多。
别急着压缩:三种省法里两种更贵
这一节是本文最想让你记住的部分。同为「省 token」,三条路的账完全不同:
| 路线 | 改了什么 | 结果 | 为什么 |
|---|---|---|---|
| 只压长度(LLMLingua-2) | 把观察内容改短 | 总 token 3.795M → 10.329M,PASS@1 57.0 → 50.0 | 信息不够,智能体多跑几轮,省下的被轮次吃掉 |
| 改写历史(AgentDiet) | 定期删掉旧内容 | token 降了,估算费用 41.26 → 45.65 美元 | 历史一变,KV Cache 无法复用,重新预填充更贵 |
| 只压新观察(CoACT) | 新观察进上下文前压缩,历史不动 | 总 token 3.795M → 2.428M,PASS@1 57.0 → 60.5 | 缓存照常命中,省下的是净额 |
表里 token 与 PASS@1 是 Qwen3.5-35B-A3B 单模型、200 个实例的口径;费用一列是全模型平均估算,均为团队自述。
第三行值得多看一眼:PASS@1 不是持平,是涨了。原因不难理解——上下文短了,模型不容易被几千行日志带偏。
至于第二行为什么更贵,关键在 KV Cache。模型处理过的前缀会被缓存,下一轮命中就能跳过预填充。一旦改写历史,缓存全废,重算的钱可能超过你省下的那部分。所以顺序应该是:压新不压旧。
四、四步止血,附一段可跑的护栏
第一步,量基线。 挑一个昨天的真实任务,记录三个数:工具调用次数、去重后的有效次数、总 token。没有基线,后面所有改动都无法验证。
第二步,下三道闸。 按拦截顺序排:同参去重(第 3 次相同调用直接短路)、次数上限(单任务封顶,参数在变也能兜住)、预算上限(token 到线终止)。有个细节容易做错——到线时要返回一段「终态指令」给模型,而不是抛异常。抛异常,智能体多半会当成工具故障再试一次,正好是你要避免的动作。
第三步,压观察不动历史。 大输出先落盘,只把摘要、文件路径和行号区间回传给模型;需要细节时让它自己按行号去读。这一条不需要训练压缩器,改的是工具封装,当天就能上线。
第四步,复测。 标准不是「token 降了」,而是「调用次数降了、任务成功率没降」。放大系数收到 2 以内(允许一次合法重查),单任务调用次数接近人工操作的步数,才算收敛。
下面这段可以直接接在工具调度处,零依赖:
from agent_guard import BudgetGuard, TaskTerminated

g = BudgetGuard("order-sync-8821", max_calls=24, max_tokens=120_000, max_identical=2)

for step in agent_loop(task):
    d = g.before(step.tool, step.args)
    if not d.allow:
        task.feed(d.hint)        # 回灌终态指令,而不是抛错
        break
    out = call_tool(step.tool, step.args)
    g.after(step.tool, step.args, out.tokens)

print(g.report())
# {'calls': 2, 'distinct_calls': 1, 'amplification': 2.0,
#  'tokens': 3600, 'repeat_tokens': 1800, 'waste_ratio': 0.5}
脚本内置三个场景,本地跑出来的对比如下:
| 场景 | 无护栏 | 有护栏 | 省下 |
|---|---|---|---|
| 状态轮询(订单永远 pending) | 100 次 / 180,000 tokens | 2 次 / 3,600 tokens | 98% |
| 重复读文件(同路径 4 遍) | 24 次 / 81,600 tokens | 12 次 / 40,800 tokens | 50% |
| 翻页轮询(参数每轮都变) | 60 次 / 132,000 tokens | 24 次 / 52,800 tokens | 60% |
前两行是去重生效,第三行只有次数上限兜住。注意第三行的放大系数是 1.0——每个调用参数都不同,指标上完全健康,实际却多跑了 24 次。这正是开头说的:单看放大系数会误判。
今天就做的四件事
- 随便挑一个昨天的任务,数它的工具调用次数,除以你去重后的步数。
- 给状态工具的返回体补上 terminal 与 next_check_after 两个字段。
- 在工具调度处加一层 before / after,先把单任务上限设成 24 次。
- 把一次性的大输出改成落盘,只回传路径与行号区间。
最后交代口径:OverServe 与 CoACT 都是近期预印本或团队自述结果,本文未做独立复现,引用时保留「最大」「平均」这类限定词。护栏脚本的数字来自本地合成轨迹,用于演示判定逻辑,不代表任何真实业务的账单。如果你在排查的是「账单涨了但任务没做完」,那是另一条线,可参考空头承诺的三种查法;如果是按量计费的单价问题,这张账单拆得更细。
登录后可点赞、收藏与反馈。

