GPT-6.2 改一句历史就丢推理:prefix_mismatch 五处改法
GPT-6.2 把 reasoning item 绑在对话前缀上:改写历史消息会让后续推理被静默移除。给手写 Agent 循环的人一套排查顺序、五处追加式改法与 11 条急救清单。
11 月 20 日,OpenAI 公布了对抗蒸馏(adversarial distillation)的防御细节:从较早请求里提取受保护推理的成功率,从 GPT-6 Astra 的 54.0% 降到 GPT-6.2 Astra 的 0.2%;当前请求从 22.9% 降到 0.9%。国内转述基本停在“安全大战”这一层。
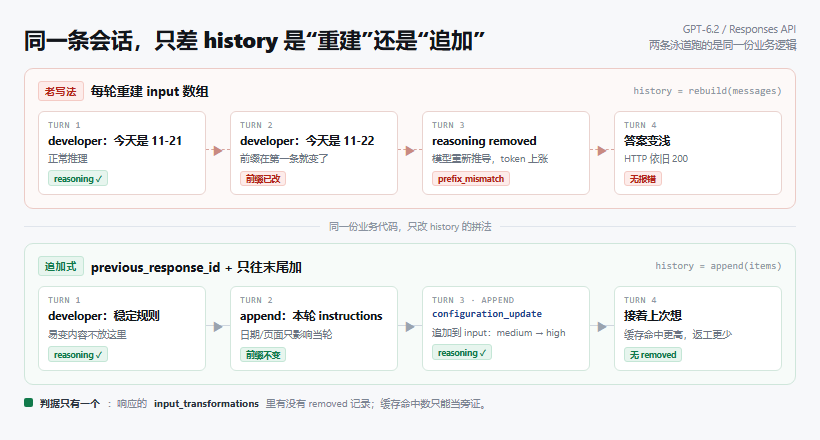
但对写 Agent 的人,真正会咬人的是同一套机制的副作用:从 GPT-6.2 起,每个 reasoning item 都绑定它之前的那段对话历史。你把历史里任何一条消息改掉——哪怕只是把 developer 消息里的日期从 11-21 改成 11-22——API 就会把这条消息之后的推理丢掉。
它不报错。HTTP 200,结构完整,答案看起来也正常,只是变浅了、变贵了。这篇不写安全分析,只写给手写 Agent 循环、自己拼 history 数组的人:怎么发现、五处怎么改、哪些情况别折腾。
为什么不能照抄上一代的上下文管理
先对齐三个词。reasoning item 是 Responses API 的一种输出项,装着模型的推理状态;它不是给人读的文本,你能看到的只有 summary。一条 reasoning item 的“前缀”,是它之前的所有对话历史:工具定义、developer 消息、之前每一轮的输入输出。
老教程教你的省 token 手法,几乎都在动前缀:滑动窗口删旧轮次、把前几轮换成自己写的摘要、每轮在 system prompt 里注入当前时间/页面/用户名、中途重写 tools 数组。这些在 6.2 之前是纯优化,在 GPT-6.2 上变成“删推理”。
官方新指南的名字就是结论:保持前缀不变(Keep the prefix unchanged)。能追加就追加,别回头改。GPT-6.2 的两个型号 11 月 17 日上线,都是 1,050,000 token 上下文、922,000 最大输入、128,000 最大输出;Astra 输入 $8、输出 $40,Sol 输入 $2、输出 $10(每百万 token,缓存输入分别是 $0.40 / $0.10)。推理被丢掉后要重算,重算按输出价计费,所以这不是“体验问题”,是账单问题。
| 老教程的默认假设 | GPT-6.2 的实际规则 |
|---|---|
| history 是你自己的数组,随时可以重建 | reasoning item 绑定它之前的历史,重建即失效 |
| 省 token 就是截断旧内容 | 截断或改写会移除其后的推理,反而更贵 |
| 换模型只是换个 model id | 跨模型族不能复用推理;同族换更弱的也会丢 |
| 前缀稳定只影响缓存命中率 | 前缀同时决定缓存和推理能不能留下 |
五个前缀变更,你的代码里大概率有一个
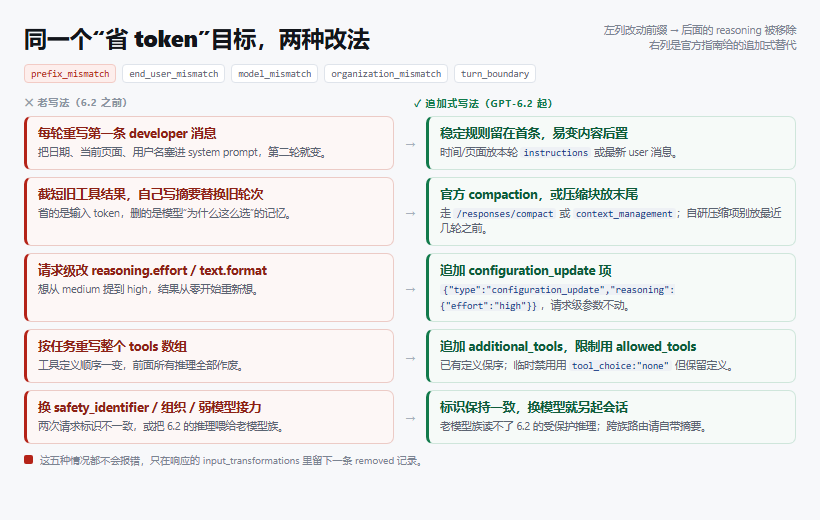
官方把“无意中改前缀”的方式列了一张表。下面五条按踩中概率排序,每条都对应一个真实写法。
1. 每轮重写第一条 developer 消息
最常见的是把“今天是几号、用户在哪一页、用户叫什么”塞进 system prompt,AI SDK 会把它作为 input[0] 的 developer 项发出去。第二轮时间变了,input[0] 就变了,第一轮的 reasoning 立刻作废。
修法不是不注入,而是把这些易变内容挪到本轮 instructions,或追加到最新一条 user 消息里。稳定的规则留在第一条 developer 消息,别动它。
2. 缩短旧工具结果、删旧轮次、自己写摘要替换
这是省 token 的主力,也是丢推理的主力。官方点名的例子就是“缩短之前的工具结果”和“用摘要替换较早轮次”。整项删除、其余项原样保留,本身不触发 prefix_mismatch;但只要你编辑了留下来的内容,后面的推理就没了。
要压缩历史,走官方 compaction;自研压缩就把压缩块放到上下文末尾,不要塞在最近几轮之前。
3. 请求级改 reasoning.effort 或 text.format
routine 轮用 low、遇到硬骨头提到 high,是标准的成本控制。但在请求级改 reasoning.effort 等于改了请求形状,前缀失效,你花 high 的钱从零开始想。结构化输出的 schema 同理。
4. 重写 tools 数组
按任务动态换工具集很常见,但官方要求保持工具定义、顺序、schema 不变。要加工具用 additional_tools;要限制本轮能调哪些,用 tool_choice 配 allowed_tools;要临时禁用,把 tool_choice 设成 "none" 但保留定义。
5. 换 safety_identifier、换组织、换模型
这三条不是“改历史”,是复用条件变了:safety_identifier 两次请求不一致(或只有一次传了)触发 end_user_mismatch;复用别的组织/工作空间的推理项触发 organization_mismatch;切到别的模型族或同族更弱的模型触发 model_mismatch。
先确认有没有中招:看 input_transformations,不看账单
这套机制最坑的是“没有异常”。想知道有没有丢,看响应里的 input_transformations:它按输入顺序列出被移除的推理项,每项四个字段:type(固定 reasoning)、id、action(固定 removed)、reason。
resp = client.responses.create(...)

for item in resp.input_transformations or []:
    # 例:rs_1 prefix_mismatch
    print(item.id, item.reason)
五种 reason 里,日常开发只会碰到前两种;剩下三种多半出现在多租户网关和模型路由里:
| reason | 触发条件 | 你要改哪里 |
|---|---|---|
prefix_mismatch | 在推理项之前插入或编辑了内容:改工具结果、改 developer 消息、重排顺序 | 改成只追加;压缩项放到上下文末尾 |
end_user_mismatch | safety_identifier 两次请求不一致,或只有一次传了 | 两次都传同一个,或两次都不传 |
model_mismatch | 切了模型族,或同族里更弱的型号 | 换回原模型;跨族路由另起会话 |
organization_mismatch | 复用了其他组织或工作空间的推理项 | 一条会话固定一套凭据 |
turn_boundary | 模型或 reasoning.context 不允许跨轮沿用 | 调 reasoning.context,或换支持的模型 |
缓存诊断是另一条线:把 prompt_cache_options.comparison_response_id 设成上一次响应 ID,诊断会报第一处差异和缓存 token 数。但官方明确说,诊断只能尽力报差异,无法证明推理有没有被复用。
所以判据顺序是:先看 input_transformations,再看 usage.input_tokens_details.cached_tokens,最后看同一任务的输出长度和返工次数。三者一起看,才能区分“缓存没命中”和“推理真丢了”。
改法一:把“改参数”换成追加 configuration_update
要中途提推理强度,不要动请求级 reasoning.effort;在 input 数组里追加一项:
{
  "type": "configuration_update",
  "reasoning": { "effort": "high" }
}
放在下一条 user 消息之前。这个设置一直生效,直到下一次 update 覆盖它;同一个项里也能改 text.format(结构化输出 schema)。请求级参数保持原值不动。
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},        # 请求级保持原值,别跟着改
    input=[
        *history,                          # 原样回放,不裁剪
        {"type": "configuration_update",
         "reasoning": {"effort": "high"}},
        {"role": "user", "content": "现在处理并发下的竞态问题。"},
    ],
)
易变内容别放第一条 developer 消息。GPT-6.2 把顶层 instructions 追加在 input 之后:它只对当轮生效,不会随 previous_response_id 带到下一轮,而且每次都按未命中缓存的价格计费。稳定的规则放第一条 developer 消息,时间、页面、用户名放 instructions 或最新一条 user 消息。
改法二:工具用 additional_tools,别重写 tools 数组
按任务加工具时,追加一个 additional_tools 项:developer 角色、带 tools 数组、按它原本的位置回放,已有工具定义的顺序不能动。要限制本轮可调用范围,用 tool_choice 配 allowed_tools。
工具多到装不下,可以用工具检索加 defer_loading: true:官方说检索到的工具会追加到上下文末尾,前面可复用的部分保持不动。这比每轮重写 tools 数组安全,也更省缓存。站内写过具体做法:《Gemini API Tool Retrieval:按需加载工具省 86% 上下文》,思路可以迁移。工具定义本身占多少 token、怎么手工裁,见《MCP 工具定义的上下文成本》。
改法三:压缩只有两条正路
历史总会满,append-only 不能解决容量。官方给了两条路,差别在“压缩项放哪”。
- 官方 compaction:走
/responses/compact或context_management。官方说这条路即使改了前缀,也会保留后面的推理项;代价是缓存可能失效。调/responses/compact时不要传instructions,把返回的 window 按原顺序传给下一次请求。 - 自研压缩:把压缩后的内容放在上下文末尾,不要放在最近几轮之前。放前面就会触发前缀变更,后面的推理全丢。
还有一条容易忽略:context_management 会保留 configuration_update 和 developer 追加的工具;如果你用的是显式压缩,下一次请求要手动把这些配置和工具恢复回去。
官方还建议:长工具输出、大文件、大图,在第一次发给模型之前就裁好,不要发完再截短——后者一定改前缀。
改法四:手动管历史时,encrypted_content 只认 output_item.done
用 store: false 或走零数据留存(ZDR)时,历史得自己管。reasoning item 里有个 encrypted_content,默认会返回,但流式响应有个坑:response.output_item.added 里的 encrypted_content 可能不完整,必须用 response.output_item.done 里的完整项。
reasoning_items = []

for event in stream:
    if event.type == "response.output_item.done" \
       and event.item.type == "reasoning":
        reasoning_items.append(event.item)   # 只收 done,不收 added

# 下一轮:按原顺序回放,别重排、别裁剪
next_input = [*history, *reasoning_items,
{"role": "user", "content": "继续"}]回放时保持原顺序,不要重新序列化后改字段。推理摘要(summary)是给人看的,不能当推理项用;原始推理 token 官方不公开。
改法五:多模型降本要另起会话,别跨族接力
老模型族读不了 GPT-6.2 的受保护推理,model_mismatch 会把它删掉。同族里换更强的模型、且其他检查通过时,兼容的推理可以保留;换更弱的模型就不行。
所以“难题用 Astra、日常用 Sol、便宜的活丢给老模型”这种路由,不能共用一条带 reasoning item 的会话。要么每段另起会话、自己带摘要,要么接受降级时推理重来。站内算过订阅额度和按量计费的账:《MiMo Token Plan 避坑:UltraSpeed 快 20 倍,额度也烧得快》,路由前先算清单位成本。
走聚合网关或中转的还要多问一句:它有没有把 reasoning item 原样回传。转发层一旦重排、裁剪,或者换了 safety_identifier,你这边看到的就是“模型变笨”,但问题不在模型。
常见翻车报错与急救清单
下面这些现象,一半不会给你 4xx,只会让账单和返工率慢慢涨。
| 现象 | 原因 | 处理 |
|---|---|---|
| HTTP 200,但答案明显变浅 | 前缀被改,reasoning 被移除 | 看 input_transformations,改回追加式 |
cached_tokens 长期为 0 | 每轮开头就在变:时间戳、页面、用户名 | 把易变内容挪到 instructions 或末尾 |
reason=end_user_mismatch | safety_identifier 两次不一致,或只传一次 | 两次都传同一个,或都不传 |
reason=prefix_mismatch,但你没改内容 | 重排了顺序,或在中间插入了新指令项 | 保持原顺序,新内容只追加到末尾 |
reason=model_mismatch | 切了模型族,或换了更弱的型号 | 换回原模型,或另起会话 |
reason=organization_mismatch | 多租户网关切了组织/工作空间凭据 | 一条会话固定一套凭据 |
| 报错:reasoning effort “none” | GPT-6.2 不接受 none | 改 low 或更高 |
| 报错:传了 temperature / top_p / logprobs | 这两个型号已移除这些参数 | 删掉;要确定性用结构化输出 |
| 工具调用在 Chat Completions 报错 | 工具调用只支持 Responses API | 换到 /v1/responses |
流式 encrypted_content 解码失败 | 取了 output_item.added 里的不完整内容 | 改用 output_item.done |
| 压缩后配置失效 | 显式压缩未恢复 configuration_update 与工具 | 下一次请求手动补回 |
这套改法适合谁,什么时候别折腾
适合:一轮里要调多次工具、跑十几轮的长任务;代码审查、运维排障这类需要“记得自己为什么这么选”的 Agent;按 token 向客户计费的 SaaS——推理重算的钱是你自己出的。
不适合:单轮问答、无工具的短会话、三轮内就结束的客服;以及纯 Chat Completions 的接入(它不暴露 reasoning item,这套规则不适用,但工具调用官方要求走 Responses API)。
代价要说清:append-only 会让输入 token 单调增长,必须靠 compaction 收口;缓存命中和推理保留是两件事,官方 compaction 保推理但可能掉缓存。如果你的场景成本敏感到必须每轮截断历史,那就接受推理丢失,或者换一个不保留跨轮推理的模型——不要既截断,又期待它记得。
一句话收束:在 GPT-6.2 上,推理是会话状态,不是缓存。缓存没了只是多花钱,推理没了是模型真的不记得自己想过什么。
你现在的 harness 怎么管上下文?滑动窗口、自己写摘要、每轮重写 system prompt,还是 previous_response_id 一路追加?把做法和大致轮数发在评论区,我帮你判断会不会踩到 prefix_mismatch。
登录后可点赞、收藏与反馈。