图片真伪检测:四层验证跑完,只有两层靠得住
11 月 13 日警方通报的天价账单案,是在真账单上用 AI 改的数字。这篇按算账、看痕迹、查来源、回原处四层拆解验证流程,附可跑脚本和三张样本的实测数据,说清哪些常见检测方法实际已经失效。
11 月 13 日中午,上海警方通报了那起"天价酒水账单"。
通报写得很直白:一家互联网酒类销售公司的负责人,组织人利用 AI 软件篡改账单金额,把饭店用的酒换成自家销售的牌子,再做成视频,靠控制账号、雇人代发推出去。15 人被抓,4 人被采取刑事强制措施,11 人被行政处罚。
这里有个细节值得所有做内容、做电商、做公关的人记住:他们没有凭空生成一张假账单,是在一张真账单上改的。
这两件事的难度完全不同,被识破的方式也完全不同。市面上讲"AI 检测"的文章,绝大多数在教你识别前者,而这次案件用的是后者。
这篇讲一件事:拿到一张可疑的账单、转账截图、报价单,按什么顺序查,能在几分钟内给出判断。文中的技术结论都来自我自己做的三张对照样本,脚本可以复制走。
通报里的动作可以拆成四步,每一步留下的痕迹都不一样。
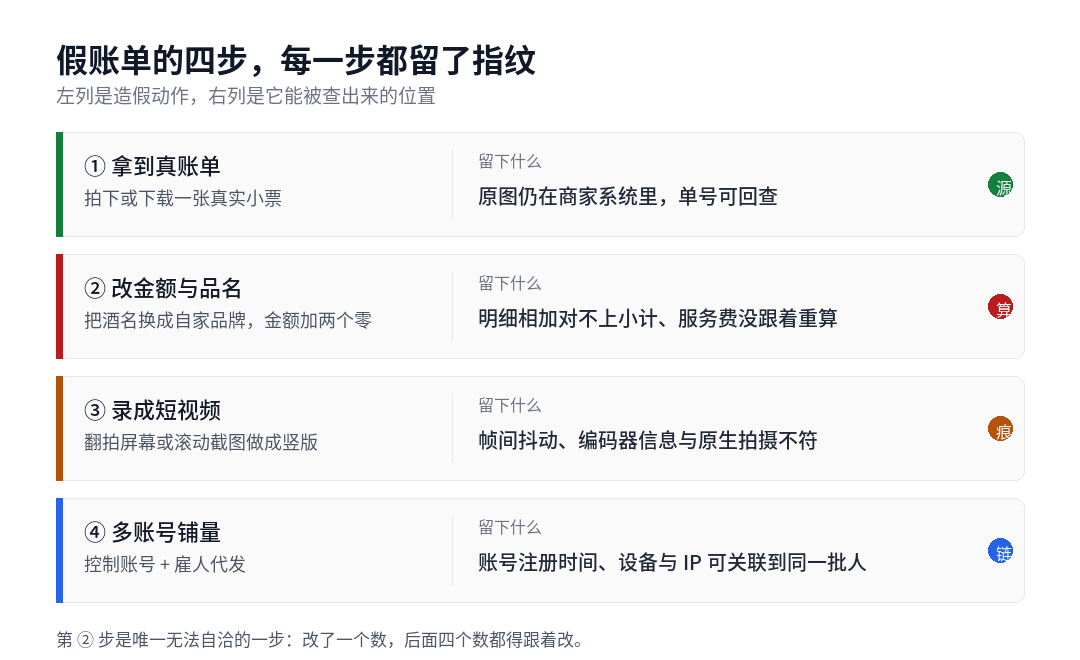
第一步是拿到一张真账单,拍下来或者下载。第二步是改金额、换品名。第三步是把它做成短视频。第四步是多账号铺量。
看起来每一步都很轻,但第二步是个死结。
一张餐厅账单上至少有五组数字互相咬合:单项金额、明细小计、服务费、税费、合计。改动其中任何一个,剩下四个都得跟着重算,而且服务费率、税率、四舍五入规则得同时对得上。
真实小票还有一个更麻烦的约束:它是打印机一次输出的,字体、字距、行距、右对齐方式全局一致。只改一行,那一行的字宽和右边距就跟别处不一样。
所以造假者面对的是一个三选一:
- 只改看得见的数字:算术关过不了,一算就露
- 全部重算:得同时复刻整张单的排版,工作量大
- 干脆重做一张:得把餐厅抬头、单号规则、打印机字体全复刻一遍
这次案件走的是第一条路,然后用视频和铺量把细节盖住。视频还有个额外好处:压缩后画质下降,很多细节"看起来正常"了。
这也解释了一件事:为什么警方通报里用"篡改"而不是"生成"。篡改和生成,留下的证据完全不是一个类型。
一、第一层:算账,三十秒能做完
这是唯一能被脚本自动化的一层,也是最容易被跳过的一层。
任何一张消费凭证,都有四道算术关。
| 关卡 | 校验内容 | 常见翻车点 |
|---|---|---|
| 行内乘积 | 数量 × 单价 = 金额 | 单价改了、金额没改,或反过来 |
| 明细求和 | 所有单项金额相加 = 小计 | 加了一行,小计忘了动 |
| 费率 | 小计 × 服务费率 = 服务费 | 只改总价,费率行不动 |
| 合计 | 小计 + 服务费 + 税 = 合计 | 用了正确的服务费去算合计,但显示行是旧的 |
第三关和第四关最容易被忽略,因为它们离"总价"最远,人的注意力都在最后那个大数字上。
我做过一张样本,专门验证这件事。
两种伪造手法,两种翻车方式
第一种是局部改金额:把一行 688.00 改成 6,880.00,其余不动。这是最常见的粗糙改法。
第二种是整图重做:加一行 39,600.00 的酒水,小计、合计、支付额全部重算,让所有看得见的数字都自洽。这是"认真造假"的做法。
把两张单的文字分别存成 txt(bill_local.txt 是局部改的,bill_remade.txt 是整图重做的),跑出来是这样:
$ python voucher_check.py --text bill_local.txt --rate 0.10
{
  "money": {
    "items": 6,
    "issues": [
      "行内乘积不符:清蒸东星斑 1×688.00≠6880.00",
      "明细合计不符:逐项 7,558.00 vs 小计 1,366.00"
    ],
    "passed": false
  }
}

$ python voucher_check.py --text bill_remade.txt --rate 0.10
{
  "money": {
    "items": 7,
    "issues": [
      "服务费不符:应 4,096.60,实 136.60",
      "合计不符:应 41,102.60,实 45,062.60"
    ],
    "passed": false
  }
}
第一种被两条规则同时抓住,在意料之中。
第二种值得多说两句。它的单价、金额、小计、合计、支付额全部对得上,人眼扫十遍也找不到问题。它栽在一个地方:造假者算合计的时候用了正确的服务费(40,966 × 10% = 4,096.60),但显示出来的服务费那一行,还是原来的 136.60。
这种错,靠眼睛基本无解,靠减法一秒就出来。
这就是自动化的价值所在。它不比人聪明,只是比人有耐心——人看到最后一个数字对上了就收工,脚本会把每一行都算一遍。
脚本
只依赖 Pillow,其余全是标准库,复制就能跑。
# voucher_check.py
import argparse, json, re
from PIL import Image

SUSPECT = ("photoshop", "gimp", "snapseed", "lightroom", "picsart", "pixlr",
           "美图", "醒图", "canva", "midjourney", "stable diffusion", "firefly")
NUM = re.compile(r"-?\d[\d,]*\.?\d{0,2}")

def container(path):
    im = Image.open(path)
    raw = im.getexif()
    exif = {str(k): str(v)[:80] for k, v in raw.items() if not isinstance(v, bytes)}
    low = open(path, "rb").read().lower()
    return {"size": list(im.size), "format": im.format,
            "exif_fields": len(exif),
            "software": [s for s in SUSPECT if s.encode() in low],
            "c2pa": b"c2pa" in low}

def money(text, rate):
    num = lambda s: float(s.replace(",", ""))
    rows, issues = [], []
    for line in text.splitlines():
        if not line.strip() or re.search(r"\d:\d|单号|桌号|人数|品名", line):
            continue
        if re.search(r"小计|合计|服务费|支付|总计", line):
            continue
        t = NUM.findall(line)
        if len(t) >= 3:
            q, p, a = num(t[-3]), num(t[-2]), num(t[-1])
            if q and abs(q * p - a) > 0.01:
                name = line.strip().split()[0]
                issues.append(f"行内乘积不符:{name} {q:g}×{p:.2f}≠{a:.2f}")
            rows.append(a)

    def pick(key):
        m = re.search(r"(?:" + key + r")[^\n]*?(-?[\d,]+\.\d{2})", text)
        return num(m.group(1)) if m else None

    sub, svc, tot = pick("小计"), pick("服务费"), pick("合计|总计")
    if rows and sub is not None and abs(sum(rows) - sub) > 0.01:
        issues.append(f"明细合计不符:逐项 {sum(rows):,.2f} vs 小计 {sub:,.2f}")
    if sub is not None and svc is not None and abs(svc - sub * rate) > 0.01:
        issues.append(f"服务费不符:应 {sub * rate:,.2f},实 {svc:,.2f}")
    if sub is not None and tot is not None:
        want = sub + (svc if svc is not None else sub * rate)
        if abs(tot - want) > 0.01:
            issues.append(f"合计不符:应 {want:,.2f},实 {tot:,.2f}")
    return {"items": len(rows), "issues": issues, "passed": not issues}

ap = argparse.ArgumentParser()
ap.add_argument("--image")
ap.add_argument("--text")
ap.add_argument("--rate", type=float, default=0.10)
a = ap.parse_args()
out = {}
if a.image:
    out["container"] = container(a.image)
if a.text:
    out["money"] = money(open(a.text, encoding="utf-8").read(), a.rate)
print(json.dumps(out, ensure_ascii=False, indent=2))
用法:
python voucher_check.py --image bill.jpg
python voucher_check.py --text bill.txt --rate 0.10
文字从哪来?不用装 OCR。手机相册长按图片就有"提取文字",微信里长按也能提取,复制粘贴存成 txt 就行。这个精度对算账够用——只要求数字认对,认错的概率远低于人眼漏看。
--rate 是服务费率。餐厅常见 10%,酒店可能 15%,外卖平台另算。这次案件里那个"天价账单",服务费的比例本身就是个校验点。
同样的逻辑,换个凭证
四道关的内核是"数字之间必须互相咬合",换凭证只需要换咬合关系。
| 凭证类型 | 咬合关系 |
|---|---|
| 餐厅账单 | 服务费率、包间最低消费、开瓶费、茶位费 |
| 电商订单 | 优惠券叠加规则、满减门槛、运费、实付金额 |
| 转账截图 | 余额变动、手续费、时间戳与聊天记录是否连续 |
| 报价单 | 单价×数量、税率、折扣前后金额、大小写是否一致 |
| 医疗/维修单据 | 项目单价、医保报销比例、自付与自费拆分 |
最后一项顺带提一句:正规单据的中文大写金额和阿拉伯数字必须一致,这个校验连脚本都不用写,肉眼对一遍即可。造假者改小写数字的时候,经常忘了改大写。
二、第二层:看痕迹,人眼能查,软件不行
算账能解决"数字对不对",解决不了"数字有没有被改过"。后者得看图像本身。
我做了两张对照样本,左边原图,右边改了第一行金额。
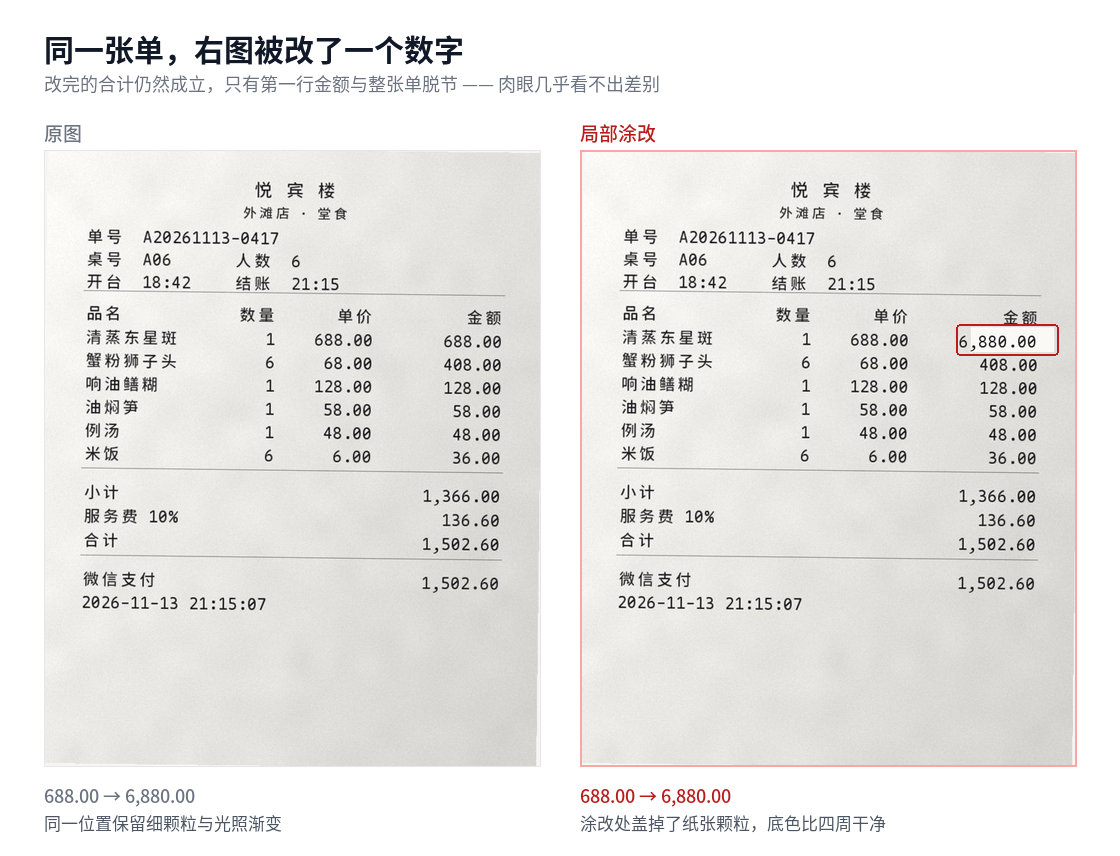
先试一下:你能在右图里找到改动的地方吗?
大多数人在这个尺寸下找不到。放大到原始像素也不一定找得到,因为这张图先走了一遍完整拍摄链路——纸张纹理、光照渐变、颗粒噪声、轻微旋转、JPEG 压缩——涂改是叠加在这之上的。
这不是眼力问题,是方法问题。
三个真正能看的物理细节
一是涂改区的纹理落差。
打印纸有颗粒,手机拍下来一定带噪点。用修图工具涂一块白色再重打字,这块区域的噪声会被抹平,跟四周形成落差。
在上面那张图里,改动处的底色比周围"干净"——这是最可靠的肉眼判据,比看边缘锯齿管用得多。
高级一点的造假会用"内容识别填充"保留纹理,落差就没那么明显。但填充出来的纹理是重复的,同一片纸纹在附近出现两次,也是破绽。
二是右对齐基线。
金额列在小票上永远是右对齐的。改过的数字宽度不同,右边缘要么被裁掉一点,要么整体左移,跟上下行的右边缘对不齐。
这条用手机横过来、贴着屏幕边缘看,很容易发现。所有金额的右端应该在同一条垂直线上,有一行偏了 2 像素就是问题。
三是字体度量。
同一台打印机出来的字,字重、字距、基线高度是完全一致的。贴上去的字,哪怕用了同款字体,字号差 1pt、基线差 1px,放在一起就能看出来。
判断方法:找一行没改过的数字,与可疑行上下叠着看,注意数字的顶部和底部是不是在同一条水平线上。
我的失败实验:三个"标准方法"全部失效
写到这里我本来想给一个自动检测涂改的脚本。业界常见的三件套是 ELA(误差水平分析)、JPEG 块效应检测、噪声一致性分析,网上教程很多。
我按标准做法实现了一遍,在三张样本上跑,结果是:
| 样本 | ELA p99 | ELA 高差异像素占比 | 块效应比(垂直) | 局部纹理方差 |
|---|---|---|---|---|
| 原图 | 5 | 0.00% | 1.038 | 11.98 |
| 局部涂改 | 5 | 0.00% | 1.037 | 11.98 |
| 整图重做 | 5 | 0.00% | 1.044 | 11.99 |
三个指标几乎完全相同。涂改区那么大一块白斑,脚本一点反应都没有。
原因不复杂,三条:
ELA 依赖足够强的压缩差异。 它的原理是把图按固定质量重新存一次,跟原图做差,差异集中的地方就是改动区。但我的样本先经了压缩、旋转、轻微模糊,高频信息被削弱,重存一次的新增差异 p99 只有 5 个灰阶。这个量级跟压缩自身的噪声混在一起,分不开。
局部方差分不清"空白"和"涂改"。 我最初的实现是按网格算纹理强度,找异常平滑的格子。结果整张图最平滑的永远是下方大片空白区,把真正的涂改盖住了。
块效应本来就弱。 JPEG 的 8×8 块边界会在图上留下周期性梯度,拼接过的图块相位会错位。但背景大片纯色时,块边界本身就不明显,这个信号弱到测不出来。
关键在于:这三道处理,微信转发一遍就全做了。
任何一张经过聊天软件转发的图,都会被重新编码、缩到较小的长边(通常 1080 上下)、剥离元数据。做完这三件事,像素级取证的价值基本归零。
这也解释了为什么那些"AI 图片检测器"的准确率众说纷纭。它们依赖的信号,在上传那一刻就没了。厂商公布的数字通常基于公开数据集的原图,不是你手上那张转过三手的截图。
所以这一层的正确用法是:人眼看纹理,软件只做参考。
三、第三层和第四层:查来源,问本人
前两层查的是"这张图本身有没有问题"。第三层查"它是从哪来的",第四层查"原始出处认不认"。
第三层:文件能告诉你什么
--image 参数会读两类信息:EXIF 里的 Software 字段,和有没有 C2PA 内容凭证。
Software 字段记录的是"用什么软件保存过这张图"。如果里面出现 Photoshop、美图、醒图这类名字,至少说明它被编辑过。脚本会把这些命中项列出来。
但有两个坑必须说清楚,不然会误判。
坑一:没有 EXIF,不能证明是假的。
截图没有 EXIF,微信转发的图没有 EXIF,绝大多数平台上传后会自动剥离。一张干干净净、什么信息都没有的图,是"正常转发"的典型状态,不是"造假"的证据。
反过来,EXIF 也能伪造。真要造假的人,填个相机型号是几行代码的事。
坑二:有 C2PA 也不能全信。
C2PA 是拍摄或生成那一刻写入的加密签名,理论上能证明来源。但目前支持它的设备和工具还不多,而且社交平台转存时普遍会剥掉。
它更适合用来"证明这张图是真的",不适合用来"证明这张图是假的"。没有签名,只能说明无从验证,不等于伪造。
在线检测工具,什么时候能用
这类工具我建议这样用:
- 只做参考,不做结论。 任何单一结果都不足以支撑举报或报案。
- 优先用在"疑似 AI 生成"的图上,不是"疑似 P 图"的图上。它们训练时见的多是整图生成样本。
- 同一张图跑两三个工具,结论不一致就说明这个场景不可靠。
- 结果只写"疑似",不写"确认"。 一旦写死,后面反转要自己承担。
真正需要出结论的场合——比如要走法律程序——应当做司法鉴定,不是跑在线工具。
第四层:回原处问,这是唯一能定性的
前三层都是筛子,能挡掉大部分粗糙的伪造,但都只能给"疑似"。
能给出确定答案的,只有回到源头。
- 账单:打商家电话,报单号查系统记录
- 转账:让对方在聊天里重新发一次实时截图,或者直接开视频
- 报价单:找发单人确认,别在转发链里问
- 新闻截图:去原始发布账号的主页找,看有没有这条
这次案件里,饭店只要出示自己的系统记录,一个单号就能说清。警方调查也正是从"这张单存不存在"开始的。
技术手段的作用,是帮你在打电话之前,先把该问的问题准备好。
四、如果你是被造谣的那一方
上面讲的是"怎么判断别人发的图"。换个位置,如果你是那张假图里的商家、品牌、个人,处理顺序不一样。
先固定证据,别急着辟谣
黄金时间是发现后的两小时,顺序不能错。
- 原始页面 URL,连同完整截图。截图必须包含账号名、发布时间、点赞转发数,缺一项后面投诉会被退回
- 录屏。从打开 App 开始滚一遍,证明内容不是拼接出来的
- 图片文件本身。右键另存,不是截图——原图才有元数据可查
- 传播节点。谁首发、谁转发、什么时候开始放量
辟谣发得再快,证据没固定住,后面全是空口。
平台投诉
用平台的"不实信息"举报入口,把证据包一起提交。多数平台对"企业名誉"类投诉有专门通道,走通用举报入口反而慢。
投诉时把话说具体:哪一句不实、真实的数字是什么、证据在第几页。别写"恶意造谣、严重侵害"这类空话,审核员一天看几百条。
报案
带证据包去派出所,说清三件事:内容不实、传播范围、造成的损失。
损失要能算出来——退单金额、客流下降、合作方解约。这类案件要够得上刑事,立案追诉标准之一是"直接经济损失五十万元以上"(另一条是停业停产六个月以上或破产)。损失算不算得清,直接决定走哪条程序。
法律依据
《刑法》第二百二十一条规定了损害商业信誉、商品声誉罪:捏造并散布虚伪事实,损害他人的商业信誉、商品声誉,给他人造成重大损失或者有其他严重情节的,处二年以下有期徒刑或者拘役,并处或者单处罚金。
这里有个容易被忽略的点。相关司法解释明确,"捏造"既包括完全虚构,也包括在真实情况基础上的部分虚构。
也就是说,"真账单 + 改数字"这种手法,在法律上和"凭空编造"是一回事,不因为底子是真的就减轻。通报里 4 人被采取刑事强制措施,对应的正是刑事程序。
至于行政处罚,《治安管理处罚法》对散布谣言、扰乱公共秩序另有规定,11 人被行政处罚对应的就是这一层。
一张可疑的截图,怎么判断真假。
按这个顺序来:
- 算账——数字对不对得上,三十秒,能筛掉大部分粗糙伪造
- 看痕迹——涂改区有没有纹理落差,右对齐有没有错位,字体度量一致不一致
- 查来源——元数据、内容凭证、发布账号的历史
- 回原处——打电话,要实时截图,找原始出处
四层里,能给出确定答案的只有两层:算账,和回原处。另外两层只能把"看起来可疑"变成"更可疑",它们决定你该问什么,不决定结论。
至于那些号称"一键检测 AI 图片"的工具——在你的图被微信压缩过一次之后,它们就已经失明了。
如果需要理解 AIGC 检测的整体原理和误差边界,可以看 AIGC 检测是怎么回事:原理、误差与应对;音视频类的造假手法与风险边界,AI 配音克隆音色:能克隆到什么程度,风险在哪 那篇讲得更细。
登录后可点赞、收藏与反馈。