Kimi OK Computer:把一台电脑交给模型
Kimi 在 2026 年 9 月灰度上线的 OK Computer,交付的不是回答而是可打开的文件。本文讲清它的虚拟电脑、三类产出,以及验收方式为何必须改变。
2026 年 9 月 25 日,Kimi 上线了一个叫 OK Computer 的 Agent 模式,灰度开放,早期打赏过 Kimi 的用户优先。它做的事可以用一句话概括:给你一台虚拟电脑,让你把需求说完,剩下的它自己在里面操作。
交付物变了,用法就得变
普通对话的产物是一段文字:你读完,判断说得对不对。OK Computer 的产物是一个能打开的东西:一个网站、一份 PPT、一张数据报表,或者一段生成好的图像与视频。
这个变化听起来只是"输出格式",实际影响的是整个使用流程。文字可以边看边改,你看到第三句觉得不对,直接说"重写第二段"。产物不行——一个网站没法"重写第二段",你只能指出哪一页哪里不对,让它重新生成那一部分。
所以用它的时候,前期把需求说清楚的价值被放大了。目标用户是谁、要几个页面、数据从哪来、风格偏哪边,这些在一开始讲明白,比事后返工省时间。
它在一台虚拟电脑里做了什么
OK Computer 的实现思路是"模型即 Agent":不确定的地方不靠预设的界面按钮,而是让模型自己决定用什么工具。
落到具体动作上,大致是三块。
浏览器:检索资料、打开网页、读取页面内容。做行业调研或竞品分析时,这一块决定了信息的新鲜度。
代码执行:跑 Python 做数据清洗、计算、画图。看到"分析这份表格"时,它不是在猜,而是真的把文件读进去算。
文件读写:把结果写成 HTML、PPTX、CSV 这些可交付的格式,落到你可以下载的位置。
三块能力单独看都不稀奇,组合起来才产生质变:从"帮我分析一下"到"分析完给我一个能发给客户的表格",中间那几十步操作由它自己串起来。
为什么"能操作电脑"是个分水岭
过去两年,多数 AI 产品的竞争点是"回答得多好"。而 Agent 的竞争点是"事情有没有真的做完"。
这两者的验证方式完全不同。回答好不好,靠人读;事情做没做完,靠打开文件看。后者更难糊弄——网站点不开就是点不开,PPT 排版错位就是错位,数据算错了对一下总数就知道。
这也是为什么"能操作一台电脑"比"能调用几个工具"更难做。工具调用是离散的,成功失败一目了然;操作电脑是连续的,中间任何一步页面变了、弹窗出来了,都可能让后续步骤失效。要撑住这种连续性,需要三样东西:能看见屏幕、能执行动作、能判断结果对不对。
底层靠什么撑住
两块基础设施值得单独说。
一是模型。2026 年 7 月发布的 Kimi K3 具备一百万 token 的上下文,权重以修改版 MIT 许可开放,主打长程编码与 Agent 任务。长上下文对这类产品是刚需——一个中等规模的项目,代码、文档、报错信息加起来很容易超过几十万 token。
二是沙箱。OK Computer 的虚拟电脑跑在云端,官方披露与阿里云共建了 Agent Infra,采用 ACS Agent Sandbox 方案,沙箱启动时间缩短一半以上,高峰期可以承载数以万计的并发请求。这项能力平时看不见,但它决定了产品能不能对公众开放——沙箱起不来的话,再好的模型也只能排队。
验收方式变了
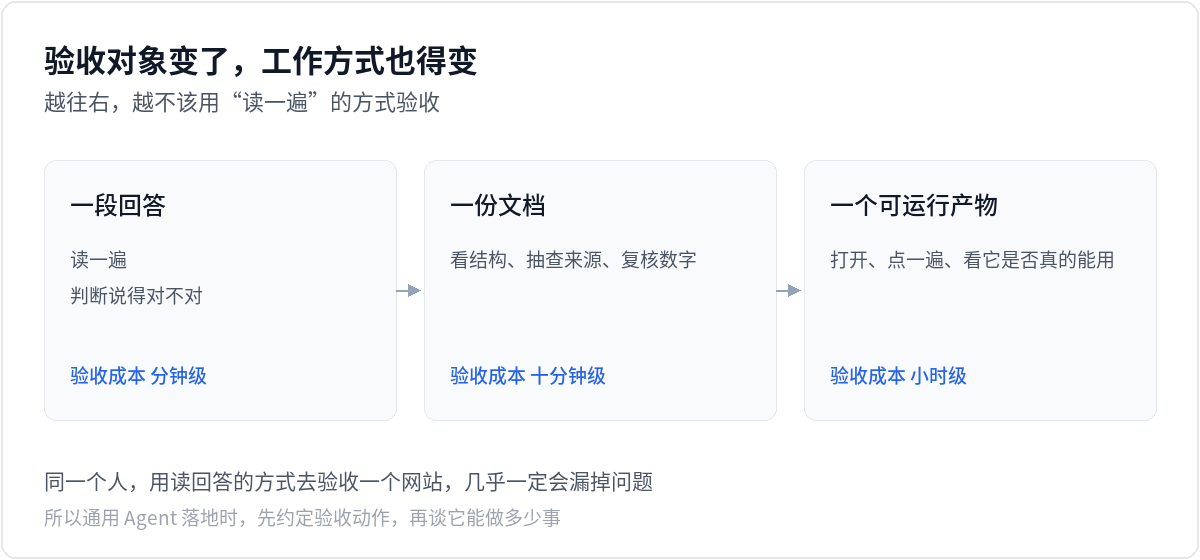
图 1 交付物越重,验收方式越不能停留在"读一遍"
这是我认为最值得记住的一点。
一段回答,读一遍就行;一份文档,要看结构、抽查来源、复核数字;一个可运行的产物,得打开、点一遍、看它是不是真的能用。
三层交付物对应三种验收动作,成本逐级上升。很多人用通用 Agent 时的挫败感,来源于用第一层的验收方式去检查第三层的产物——扫一眼觉得不错,交付出去才发现链接打不开、表格公式错了。
比较稳妥的做法是把验收拆成清单:结构对不对、关键数据能否回溯、交互是否可用、边界情况有没有处理。清单化之后,验收时间可控,也不容易漏。
三个现实约束
第一,开放节奏与额度。OK Computer 是灰度开放的,免费额度有限,重度使用需要订阅。这意味着它目前更适合"验证能不能用",而不是"承担每天的生产任务"。
第二,可复现性。同一个需求提两次,路径和结果可能不同。对创意类任务这没问题,对需要稳定输出的业务就是硬伤。缓解办法是把关键结论落成可核对的来源,而不是只留结论。
第三,数据边界。上传的文件、抓取的网页都在云端处理。涉及客户数据、未公开材料时,要先确认合规口径,而不是事后补救。
它适合谁
适合需要频繁产出"可交付物"的人:做行业研究要出报告、做运营要出页面、做汇报要出 PPT、做分析要出表格。这类工作的共同点是——过程机械、结果可验,正好是 Agent 的舒适区。
不太适合两类:需要严格可复现、可审计的流程(这类应该上工作流平台);以及只需要一段文字答案的轻量问答(用普通对话更快)。
和 Manus 那类通用 Agent相比,两者的方向一致,差别在底座:一个把虚拟电脑和沙箱弹性做成了公开的基础设施叙事,一个更强调任务编排与交付形态的完整度。选哪个,更多取决于你需要的产出类型和可接受的等待时间。
最后提醒一句:这类产品的能力上限,取决于你把它当"更快的搜索"还是"能干活的同事"。前者只需要一句提问,后者需要一份简报。用法不同,结果差得很远。
登录后可点赞、收藏与反馈。