家谱古籍扫描件转文字别再按页交钱:8 款开源 OCR 千页实测,最低 0.67 元
8 款开源 OCR 模型同卡实测 850 页老扫描件:千页最低 0.67 元,错误率全部低于 1%。选型表、跑法优化阶梯与四类静默翻车急救清单,修家谱和旧档案前先看这篇。
搜「扫描件转文字」「家谱电子化」,排在前面的永远是两类答案:一类让你把扫描件传到按页收费的云服务,一千页几十上百块;另一类是十年前的 Tesseract 教程,拿到发脆的老书扫描件上,出来的就是满屏乱码。这两条路都不是给修家谱、整地方志、扫老档案的个人用户准备的。
2026 年 11 月 18 日,Hugging Face 工程师 Daniel van Strien 做了一轮很「朴素」的实测:把 8 款开源 OCR 模型放到同一张英伟达 RTX PRO 6000 显卡上(Hugging Face Jobs 租用,2.75 美元/小时),跑同样的 850 页老材料——350 页旧版自然历史书籍(其中 282 页有人工校对转写、63 页是空白页)、250 页 1771 年版《大英百科全书》、250 页来自 44 份打字与印刷档案。结论对个人用户非常友好:最新的 LightOnOCR-3-0.8B 识别 1000 页的 GPU 租赁成本只要 0.095 美元(约 0.67 元人民币),比 18 个月前的 RolmOCR(0.51 美元)降了约 5.4 倍;282 页人工校对的书籍样本上,全部 8 款模型的中位字符错误率(CER)都低于 1%。
千页不到一瓶水的钱。但这轮实测同时揪出了四类「不报错但输出是错的」静默翻车:空白页长出文字、循环输出、被遮挡处编内容、撞输出上限截断。这篇按个人用户视角整理成可直接照做的流程,含选型表、跑法优化阶梯和急救清单,全部数字都给到出处。
主流方案 vs 开源 VLM 方案:一张表看清差别
老扫描件和手机拍的清晰文档不是一回事:纸张发黄、字迹褪色、竖排版式、油墨浓淡不均。这正是传统 OCR 和新一代视觉语言模型(VLM)OCR 分化的地方——后者是「看着图读字」,对破损、异形版式的容忍度高得多。
| 方案 | 千页成本量级 | 老扫描件表现 | 适合谁 |
|---|---|---|---|
| 按页收费云 OCR | 几十到上百元,页数越多越贵 | 能跑,但量大了烧钱,隐私材料还要上传 | 偶尔几页的临时需求 |
| Tesseract 等老开源 OCR | 免费(耗自己的时间) | 老书、褪色字迹、竖排常出满屏乱码,要大量预处理 | 清晰现代印刷品 |
| 桌面商用软件按套买 | 几百到几千元一套 | 对老材料有优化,但批量批处理不灵活 | 固定办公场景 |
| 开源 VLM OCR + 租 GPU | 实测 0.67~3.4 元 | 视觉模型读图,破损页、密排小字容忍度高 | 批量老材料的个人与小团队 |
8 款开源 OCR 模型千页成本实测:中间五款别纠结,看两头
同一张卡、同一套图像尺寸(最长边压到 2048px)、同一套持续喂页的跑法,8 款模型的千页综合成本和人工校对错误率如下:
| 模型 | 发布时间 | 参数量 | 千页综合成本 | 书籍页中位错误率(容错 CER) |
|---|---|---|---|---|
| RolmOCR | 2025-04 | 8.29B | $0.51 | 0.50% |
| dots.ocr | 2025-07 | 3.04B | $0.45 | 0.47% |
| olmOCR-2(FP8) | 2025-10 | 8.29B | $0.23 | 0.49% |
| PaddleOCR-VL | 2025-10 | 0.96B | $0.23 | 0.62% |
| DeepSeek-OCR | 2025-10 | 3.34B | $0.28 | 0.82% |
| GLM-OCR | 2026-01 | 1.33B | $0.28 | 0.44% |
| OvisOCR2 | 2026-07 | 0.85B | $0.24 | 0.72% |
| LightOnOCR-3-0.8B | 2026-10 | 0.85B | $0.095 | 0.45% |
两句话看完这张表:中间五款(2025 年 10 月到 2026 年 7 月)成本挤在 0.23–0.28 美元,作者明说这个差距在两次运行的波动范围内、排不出可靠名次,别纠结;真正的差距在两头——最新模型是 2025 年 4 月模型的五分之一,而且错误率没变差。
选型建议照抄作者结论:书籍页和打字文档直接上 LightOnOCR-3-0.8B,三类页面它都最便宜且不劣于老模型;密集历史印刷(双栏、小字号的旧书)没有明确赢家,拿它和 RolmOCR 在自己的样本上各跑一遍再定。参考成本感:8 款模型跑完全部 850 页只花了约 6 美元 GPU 费——你抽 20 页试 2 个模型,成本可以忽略不计。
关键一步:先改跑法再换模型,同一模型成本差 12 倍
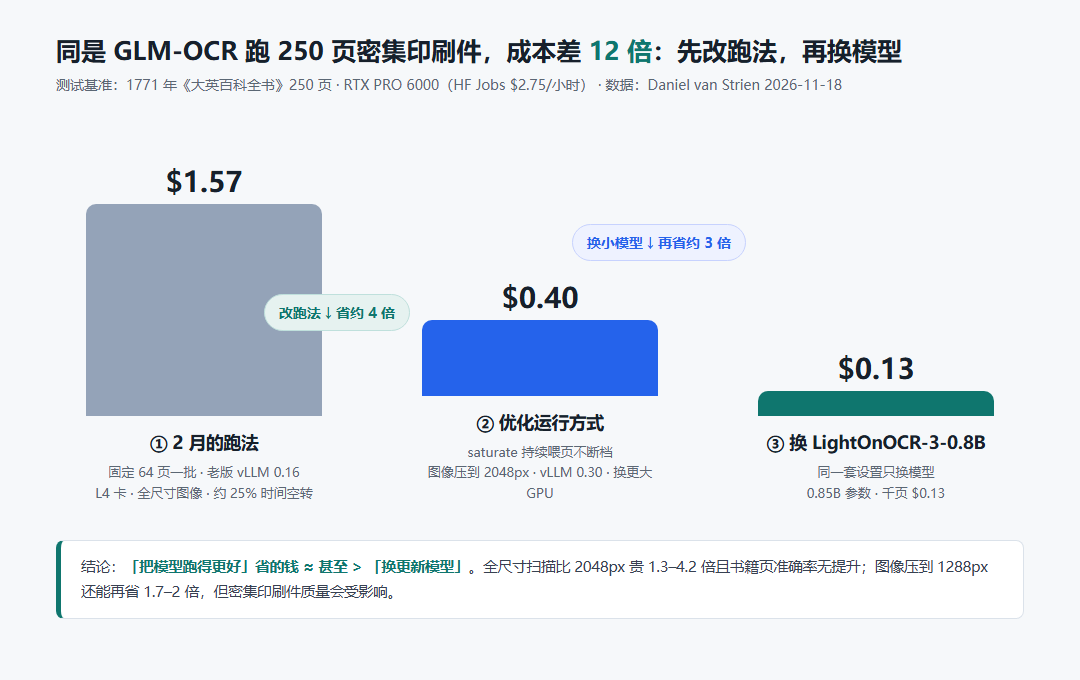
这是整轮实测里最反常识的结论:优化运行方式省下的钱,和换新一代模型相当甚至更多。同一款 GLM-OCR 跑 250 页《大英百科全书》,2 月的跑法是 1.57 美元/千页,改跑法后降到 0.40,再换上 LightOnOCR-3-0.8B 降到 0.13——改跑法省约 4 倍,换模型再省约 3 倍。很多人直接跳去追新模型,其实钱是老跑法漏掉的。
四个具体杠杆,按性价比排序:
- 喂页方式:旧脚本固定 64 页一批,批与批之间 GPU 约 25% 的时间在空转;改成持续喂页(saturate 模式),GPU 一直有活干,这是最大的一笔隐性浪费。
- 图像尺寸:全尺寸扫描比压到 2048px 贵 1.3–4.2 倍,而书籍页准确率没有任何提升;再压到 1288px 还能省 1.7–2 倍,但密集印刷件的质量会受损——老书密排小字别压太狠。
- 软件版本:vLLM 0.30 对 2025 年的模型提速 1.2–1.5 倍,先升级推理引擎再谈别的。
- GPU 档次:换更大的卡约贡献 1.5 倍降幅,租金也水涨船高,等上面三项做完再考虑。
# 个人用户的跑批顺序(参数取自实测口径,流程示意非官方脚本)
1. 空白页 / 目录页 / 夹页先单独过一遍,输出非空即记录该模型
2. 图像最长边压到 2048px(密排小字页可留一版大图对比效果)
3. vLLM 0.30 以上起服务,页面持续喂入、不要一批批干等
4. 验收顺序:输出 token 分布 → 重复内容 → 空页非空 → 最后才看错误率
16GB 显卡能不能跑?能,但只限新一代小模型
没有大卡的注意:LightOnOCR-3-0.8B 在 16GB 的 T4(0.40 美元/小时)上实测约 0.25–0.41 美元/千页,显存占用约 13 GiB 还有余量。而 8.29B 的 RolmOCR 在 24GB 卡上权重就把显存占满,一次只能装下约 6 个典型页的上下文,千页成本被推高到 2.10–2.80 美元。结论:小卡跑小模型是正路,小卡硬塞大模型是双重花钱。
四类静默翻车与急救清单:最贵的坑都在「跑完了」之后
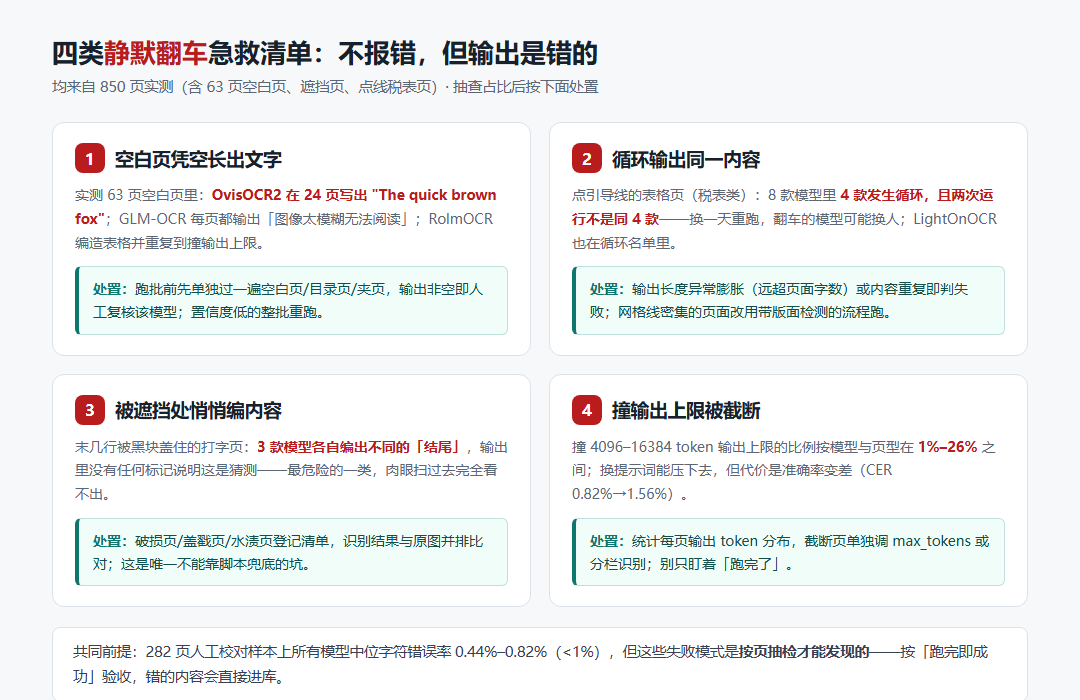
850 页样本里专门埋了 63 页空白页和若干遮挡页、点线表格页,翻出来的问题值得整个抄进验收流程——这些失败没有一个会报错,脚本看到的全是「成功」。
| 翻车现象 | 实测表现 | 急救动作 |
|---|---|---|
| 空白页凭空长字 | OvisOCR2 在 63 页空白页中的 24 页写出「The quick brown fox」;GLM-OCR 全部 63 页输出「图像太模糊无法阅读」;RolmOCR 编造表格并循环到撞上限 | 空页非空输出即标记,该模型整批人工复核 |
| 循环输出同一内容 | 点线税表页 8 款中 4 款发生循环,且两次运行不是同 4 款;LightOnOCR 也在循环名单里 | 输出异常膨胀或内容重复即判失败;网格密页改用带版面检测的流程 |
| 被遮挡处悄悄编内容 | 末几行被黑块盖住的打字页,3 款模型各自编出不同的「结尾」,输出无任何猜测标记 | 破损页/盖戳页/水渍页登记清单,识别结果与原图并排比对 |
| 撞输出上限截断 | 按模型与页型 1%–26% 不等;换提示词能压下去,但 CER 从 0.82% 恶化到 1.56% | 统计每页输出 token 分布,截断页单独调 max_tokens 或分栏识别 |
另有一个纸面细节:多款模型把旧书里的长 s(ſ)读成 f,连盲审判官都忽略了它——如果你打算把识别结果做全文检索,这类系统性错字会悄悄污染索引,检索前记得按频次排查「高频可疑错字」。
中文家谱能用吗?三个必须说清的边界
边界一:这轮实测全部是英文材料。自然历史书、《大英百科全书》、打字档案没有一页中文。0.44%–0.82% 的错误率数字不能直接套到中文竖排繁体家谱上——请把「千页 0.67 元」当成本下限,而不是中文效果承诺。
边界二:中文场景优先试 PaddleOCR-VL。它出自百度系,0.96B 参数、千页 0.23 美元的成本处于第二梯队,对中文版式的基础通常比英文系模型更值得期待——但同样要拿你自己的 10–20 页先验证,别看榜单下结论。
边界三:0.095 美元只是「识别」这一段的钱。不含翻页扫描的人工、不含校对,也不是完整数字化服务的报价。作者基于 8 个数据点拟合的「约每 9.6 个月成本减半」趋势,自己也标注了「当玩具看待」,别拿它做采购预算。
总结这套路线的适用面:修家谱、整地方志、扫老档案、旧书批量的个人与小团队,值得直接按「LightOnOCR-3-0.8B 起步 + 2048px + 持续喂页 + 空页抽检」搭流程;材料全是近十年清晰印刷品的,免费商用额度或现成工具就够,不必为此租 GPU。想先摸底自己材料的可读性,可以先看这篇《扫描件提取不出文字:AI 档案检索上线前先查这四步》,两篇正好一个管「能不能检索」、一个管「批量转文字要花多少钱」。
你手上正在扫的是哪类材料——竖排家谱、油印讲义,还是单位老档案?用的是哪款模型、卡在哪一步?评论区报配置和报错,我来帮你排查。
登录后可点赞、收藏与反馈。