PPO 象棋模型接 MCTS 反而掉 54 ELO:32000 节点里 99.4% 挤在第一步
复现腾讯无搜索象棋 AI 的开发者发现:PPO 把无搜索胜率从 .420 抬到 .576,接上 MCTS 却掉到 .4656。本文拆 αβ、MCTS、BFMS 三种接口错配,给 top1N 自检脚本、c_puct 换算和 10 条急救。
你搜「PPO 棋类 AI 加搜索」,前十条结果都在讲 AlphaZero:策略头学的是 MCTS 访问分布,天生全宽度,接上搜索当然涨棋。可你手里这个模型是 PPO 微调出来的——照抄这套,胜率会往下走。
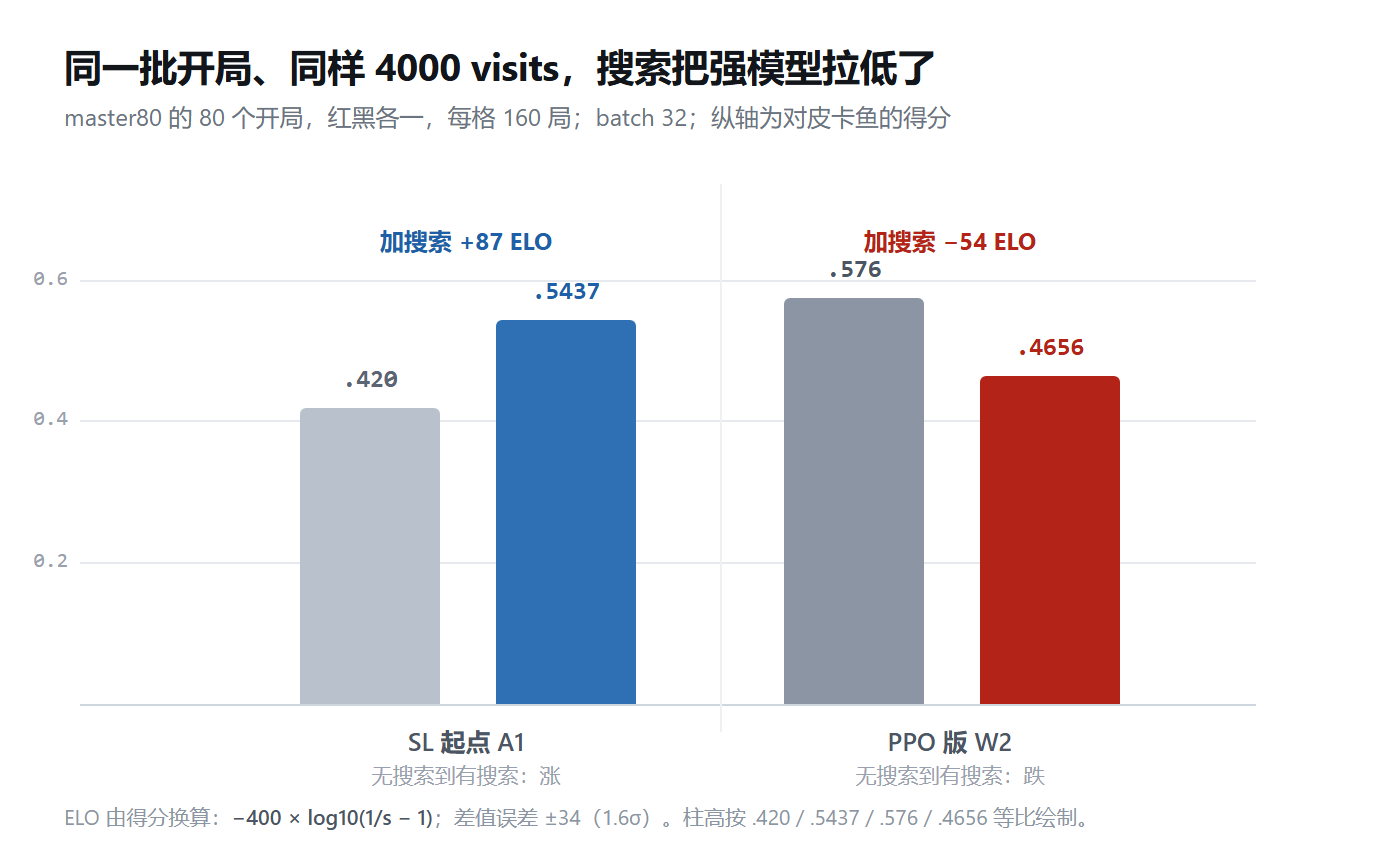
不是玄学。开发者戴·菲瑜在博客园复现腾讯光子 2024 年那篇《Mastering Chinese Chess AI (Xiangqi) Without Search》(arXiv:2410.04865)时,用同一批开局、同样 4000 visits 测了一遍:无搜索胜率从 .420 抬到 .576 的 PPO 模型,接上 MCTS 后从 .5437 掉到 .4656,折合 −54 ELO(±34,1.6σ)。
他后来把 αβ、MCTS、BFMS 三种搜索全接了一遍,三种都没成。原因不是工程量,是一句话:PPO 优化的是「最优解」,搜索要的是「全宽度排序」。下面把这句话拆成能自己量的数、能自己拧的旋钮。硬件是一张 RTX 4090,模型 11M 参数 ViT,棋谱 14.3 万局,所有对局都是同开局、等节点。
先看那一格反常识的数据:RL 让无搜索变强,却让有搜索变弱
先把两个模型摆清楚。A1 是监督学习(SL)出来的起点,架构对齐无搜索论文;W2 是在 A1 上继续 PPO 训出来的。两者接的搜索完全一样:master80 的 80 个开局,红黑各一,每格 160 局,4000 visits,batch 32。
| 模型 | 无搜索(对皮卡鱼 d1) | + MCTS 4000 visits | 变化 |
|---|---|---|---|
| SL 起点 A1 | .420 | .5437 | 搜索有用,+87 ELO(按得分换算) |
| PPO 版 W2 | .576 | .4656 | 搜索有害,−54 ELO |
只看无搜索那一列,PPO 干得很漂亮:.420 → .576,开发者本人(业9-1)跟无搜索版对弈基本持平,单次决策从业7 提到业9-1。
但把搜索接上,同一个 W2 掉到 .4656,比没训过的 A1 还低。注意这不是「涨得少」,是方向反了:训练把无搜索的分抬了 15.6 个百分点,同时把有搜索的分压了 7.8 个百分点。
原文的总结只有一句:「RL 让『无搜索』变强了,却让『有搜索』变弱了。」
主流教程默认的是 AlphaZero 路线,和 PPO 差在哪
差别不在训练框架,在策略头被要求学什么。把两张表叠在一起看就清楚了:
| 维度 | AlphaZero 路线(主流教程) | PPO 微调(你手上这种) |
|---|---|---|
| 策略头标签 | MCTS 访问分布,软标签 | 交叉熵硬标签 + 优势加权 |
| 分布形状 | 多峰,兄弟着法都留概率 | 尖峰,top-1 高、二名以后塌陷 |
| 给 αβ 的排序先验 | 大致可用 | 2 名以后概率质量不够,剪枝排序失效 |
| 给 MCTS 的 U 项 | 拉得动兄弟节点 | 拉不动,树退化成一条腿 |
| 加搜索预算 | 稳定涨棋 | 不涨,甚至掉 ELO |
为什么 PPO 模型接 αβ 会被封死(三层不可调和)
αβ 剪枝在数学上严格等价于全宽度 minimax,它不是「近似」minimax,它就是 minimax。完美排序能把有效分支因子从 b 降到 √b:象棋 b≈40,等于把 40 变成 6.3,深度翻倍。而现代引擎那些不保险的剪枝——LMR、futility、razoring、ProbCut——全都建立在「排序大致正确」上。
排序从哪来?看皮卡鱼 movepick.cpp,吃子和安静着法两套:
// 皮卡鱼 src/movepick.cpp(Stockfish 同源)
// 吃子:被吃子价值 + 吃子 history
m.value = (*captureHistory)[pc][to][type_of(capturedPiece)]
        + 7 * PieceValue[capturedPiece];

// 安静着法:main history 与 pawn history 各算两倍,再叠 continuation history
int value = 2 * (*mainHist)[m.raw()];
value += 2 * (*pawnHist)[pc][to];
value += (*ch0)[pc][to];
value += (*ch1)[pc][to];
这些 history 表不是网络权重,是搜索过程中「哪些着法曾经导致截断」的统计。也就是说,αβ 的排序能力来自搜索自己,不来自你的策略头。
策略头想插进去,只有三条路,全被堵住:
| 层面 | αβ 的要求 | 11M ViT + PPO 的现状 |
|---|---|---|
| 速度 | NNUE 约 1.5 μs/节点,4000 节点 6 ms | batch=1 时 3.58 ms/次,差 2~3 个数量级 |
| 更新方式 | 增量:走一步只改一两个格子 | self-attention 必须全量重算 |
| 并行 | 严格串行深度优先 | 靠 batch 摊薄,串行场景用不上 |
原文的说法很直接:「αβ 的算法结构与 GPU 的硬件特性相反。」
唯一有意义的接口,是把策略头当排序先验。那就得看这个先验到底有没有「全宽度」的信息。开发者用 150 个中局局面、皮卡鱼 d14 MultiPV=5 当真值,量了两件事:
| 指标(150 个中局局面) | SL 模型 A1 | PPO 模型 W2 |
|---|---|---|
| top-1 命中率 | .598 | .668 |
| top-2 概率质量 | .163 | .183 |
| 第 4 名以后概率质量 | .163 | .076 |
| top2 / top1 中位比 | — | .298 |
RL 把 top-1 命中率从 .598 提到 .668,听起来是进步。但「第 4 名以后概率质量」从 .163 砍到 .076,砍掉一半多。典型形态是「一条粗腿 + 一条细腿」。
棋盘上真实「近优着法」(±20 厘兵以内)平均 2.93 个,而模型策略分布的 exp(H) 是 4.70。翻译一下:通常有 3 个着法都值得考虑,模型只对其中 1 个有像样概率。 而 αβ 要的是把 40 个着法粗排出前 6 个,你只给得出第 1 个。
接 MCTS 前先量一个数:根节点集中度 top1N
MCTS 的入口是 PUCT:
PUCT(a) = Q(a) + c_puct × P(a) × sqrt(N_parent) / (1 + N(a))U 项靠 P(a) 拉动兄弟节点。如果 P 全压在第一位,U 就拉不动,搜索预算会一层层喂给同一条路径——树看起来很大,实际只在一条腿上长。
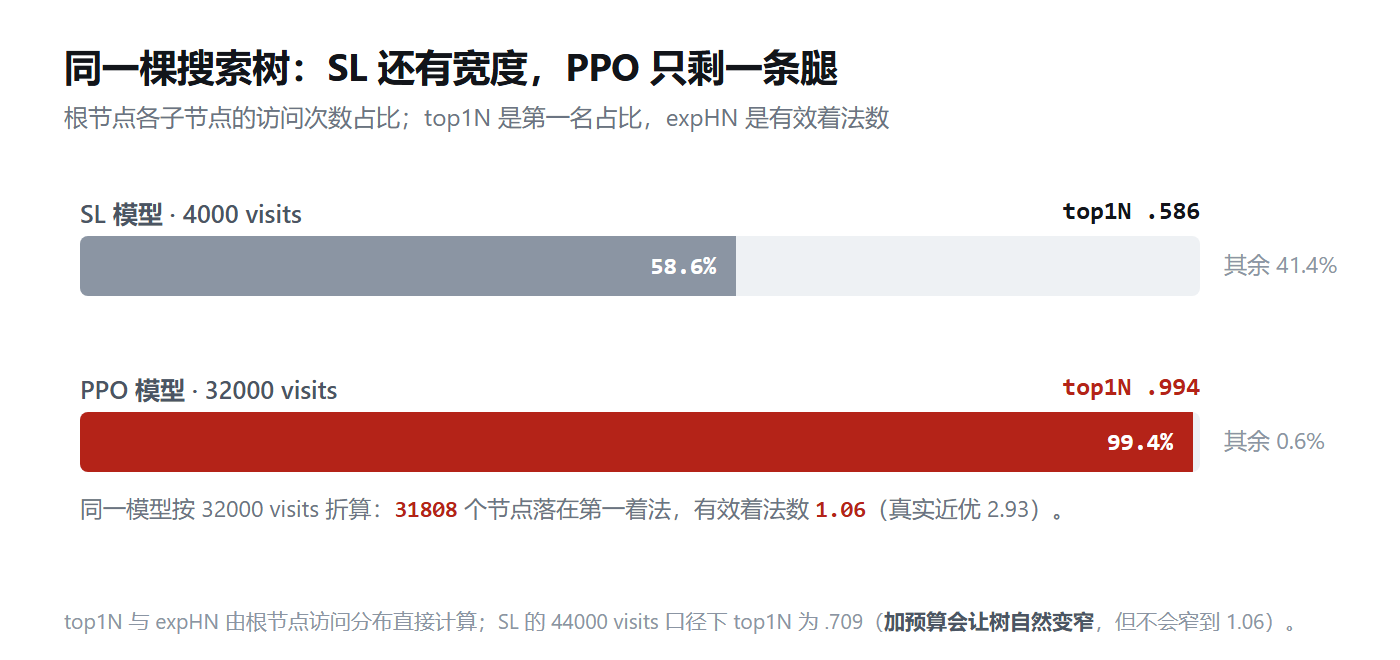
这个现象可以直接量。定义两个数:top1N 是根节点第一着法子树的访问数占根总访问数的比例;expHN 是 exp(访问分布熵),也就是「有效着法数」。
| 配置 | top1N | expHN(有效着法数) | 判读 |
|---|---|---|---|
| SL + MCTS 4000 visits | .586 | — | 正常,树有宽度 |
| SL + MCTS 44000 visits | .709 | — | 预算涨 11 倍,树变窄但没病态 |
| PPO(W2) + MCTS 32000 visits | .994 | 1.06 | 独腿 |
SL 模型从 4k 加到 44k(11 倍预算),top1N 从 .586 涨到 .709——「把树变窄」是正常现象,值越准越该窄。RL 模型 32000 个节点里 99.4% 挤在根第一着法上,有效着法数 1.06。窄到 1.06 不是变准,是病态。
给你一段能直接跑的体检脚本。把每步根节点的子节点访问数导出成 JSONL,一行一个局面:
# root_stats.py —— 算根节点集中度与有效着法数
import json, math, sys

def stats(visits):
    n = sum(visits)
    if not n:
        return None
    p = [v / n for v in visits if v]
    h = -sum(x * math.log(x) for x in p)
    return max(p), math.exp(h)          # top1N, expHN

rows = [json.loads(l) for l in open(sys.argv[1], encoding="utf-8")]
vals = [s for s in (stats(r["visits"]) for r in rows) if s]
mid = len(vals) // 2
print("局面", len(vals))
print("top1N 中位 %.3f" % sorted(v[0] for v in vals)[mid])
print("expHN 中位 %.2f" % sorted(v[1] for v in vals)[mid])
判读按上面两组分布来:top1N 在 .5~.7、expHN 和真实近优着法数(这个项目里是 2.93)在同一量级,说明先验还有宽度,加预算有意义;top1N 超过 .95 或 expHN 掉到 1.2 以下,先别加 visits,先压先验,否则多出来的预算只是在同一条腿上重复计算。
三个「压平先验」的旋钮,只有搜索侧温度真的有用
发现独腿之后,直觉是「把 top-1 压下去」。开发者试了三个旋钮,作用位置各不相同:
| 旋钮 | 作用位置 | 做法 | 实测 |
|---|---|---|---|
削峰 --maxp-cap .70 | 训练 | 只罚 top-1 超过 cap 的部分 | expHP 2.85→3.32,h2h −18 ELO |
熵地板 --ent-floor 1.25 | 训练 | 罚整批平均熵低于 1.25 | 一直罚 −.24,熵停在 1.01 |
自适应温度 --temp-target-ent | 搜索 / 推理 | 解 T 让归一化熵达标 | W2 +89 ELO,A1 −1 |
削峰最像正确答案,也最没用。它的损失是 pen = coef × clamp(maxP − cap).mean(),只罚超过 cap 的那部分——把 top-1 从 .99 压到 .70,多出来的 .29「给谁都算通过」。剂量加倍(cap .70→.60,coef .25→.50)结果一样:一条粗腿变成一条粗腿加一条细腿,三选以后的排序一个字节没动。
熵地板更反直觉。目标 1.25,训练时一直罚 −.24,熵仍停在 1.01(A1 是 1.51)——它只惩罚「整批平均熵」,模型可以靠个别局面把均值拉起来,剩下的继续尖。
真正有效的是搜索侧的自适应温度:解一个 T,让归一化熵 H/ln n 达到目标。.40→.70 之后,W2 从 .3406 回到 .4625(+89 ELO),A1 从 .5437 到 .5406(−1)。属性是「救弱不增强」:最多追平 SL 的默认口径,不可能靠它超越 SL。
还有一个更省事的验证:直接把 SL 和 RL 的策略按 P_mix=(1−a)P_SL+aP_RL 混起来接 MCTS,每臂 120 局。
| RL 权重 a | 得分 | 说明 |
|---|---|---|
| 0(纯 SL) | .5333 | 最好 |
| 0.25 | .5083 | 开始掉 |
| 0.50 | .4042 | 明显掉 |
| 1.0(纯 RL) | .3875 | 最差 |
纯 SL 最好,混得越多越差。RL 学到的「更准的 top-1」,在搜索里被「更烂的排序」抵消掉了。
c_puct 不是常数:Q 的尺度变了,探索系数要跟着改
这里有个特别容易漏的坑。PUCT 里 Q 和 U 是相加的,Q 的方差一变,同一个 c_puct 的实际含义就变了。
W2 的 Q 只有 A1 的 69% 宽(std .337 对 .485)。默认 c_puct=2.0 作用在 W2 身上,等效于 2.0×(0.485/0.337)≈2.88,探索过头。按 Q 的 std 把 c_puct 调到 1.4,W2 从 .3406 回到 .4656(+91 ELO)——策略一位没改,只是探索系数配错了。
c_eff = c_cfg * (sigma_ref / sigma_q) # 2.0 × (0.485 / 0.337) ≈ 2.88换模型、换训练阶段、换价值头,都要重算这个比值。把它当常数抄,是最常见的「调参调不动」。
batch 与 ELO:4000 visits 下 b8 比 b32 高约 80 ELO
这条对工程实现最直接。同样 4000 节点、同样 A1,只改 batch:
| batch | 8 | 16 | 32 | 64 |
|---|---|---|---|---|
| 对皮卡鱼 4000 节点得分 | .6219 | .5719 | .5094 | .4469 |
每翻一倍 batch,掉约 41 ELO。原因是宽批里混进了更多「其他分支」的位置,同一波里真正推进主变的次数变少。
不过这是等节点口径。换成等墙钟:b8@4000 打 b64@8400,20 局是 .5000,而后者还少花 34% 墙钟。所以结论是「等节点必须用小 batch,等时间下宽批不吃亏」——等节点只是评测方便,不是实战口径。开发者后来把默认公式改成 batch ≈ visits/500,4000 visits 就是 8。
顺带说清一件事:LC0 的 virtual loss 后来改成 unscored virtual visit(只加 N、不动 Q),KataGo 用 MCGS 把树当 DAG,它们的目的都是避免同一批撞到同一个节点,不是为了「让宽批变强」。LC0 文档里写得明白,batch gathering 是扩到多 GPU 的主要瓶颈,上限约 1200。
BFMS 看着最兼容,四个坑先踩为敬
BFMS(Best-First Minimax Search)的思路很朴素:根的值等于某个叶子节点的静态值,而主变叶子就是那个叶子,所以优先展开主变。它不依赖全宽度排序,只看「当前主变值不值得再往下看」——如果 PPO 只把 top-1 做准了,BFMS 理论上该比 αβ 和 PUCT 更兼容。
这是开发者 11 月做这一系列实验的动机。结果:
| 口径 | BFMS + SL | BFMS + RL | MCTS + SL | MCTS + RL |
|---|---|---|---|---|
| 4000 节点 / b128 | .212 | .113 | .500 | .438 |
| 32000 节点 / b256 | .100 | .000 | .1333 | .100 |
4000 节点下 BFMS + SL 是 .212,MCTS + SL 是 .500,差约 200 ELO;64000 visits 自对弈 8 局,BFMS 0 胜 1 和 7 负。方向对了,但差距不是一个量级。
这一路踩到的四个坑,都是代码级的:
坑一:置换表合并后,主变链会成环
DAG 合并之后 bestKid 可能指回链上已有节点,主变列表无限增长。必须对主变链和临时链都做去重:
seen, pv, node = set(), [], root
while node is not None and node not in seen:
    seen.add(node); pv.append(node); node = node.best_kid
坑二:某一层着法不够时,break 会漏节点
第二阶段按(层,孩子序号)回退,某层招法数不足应当 continue 而不是 break。写错会漏掉浅层那些招法多的节点——现象是「搜索深度上去了,质量反而下降」。
坑三:收集阶段重复编码,慢 60 倍
收集时不要调 encodeFeaturesAndMask,它内含两次 legalFor 和 19 KB memset。只存按策略概率排好的序号 ord[],实测这一步省 60 倍时间。
坑四:根上的真值差,落在单次评估噪声里
BFMS 全靠评估函数做 min/max。而这个项目根上 30 多个着法,真实值差只有 .01~.05,完全落在单次评估的噪声里。原文的判断很克制:BFMS 的上限由评估函数决定,不由搜索本身决定;评估准,它能赢 αβ,评估差,它比经典 minimax 更差。
常见翻车报错与急救清单
| 现象 | 根因 | 处理 |
|---|---|---|
| 接上 MCTS 后胜率反而下降 | PPO 先验过尖,Q 尺度也变了 | 先量 top1N,再按 σ 比换算 c_puct |
| 32000 节点 99% 挤在第一着法 | 策略分布单峰 | 搜索侧温度 .40→.70,或直接换 SL 策略 |
| 削峰训练后 expHP 涨了、棋力掉了 | 只压 top-1,2 名以后没动 | 停掉 maxp-cap,改排序监督 |
| 熵地板一直罚、熵不动 | 只罚批次平均熵 | 改推理侧自适应温度 |
c_puct 调大调小都没用 | Q 方差变了,等效系数已偏 | 按 c×σ_ref/σ_q 重算 |
| 非法着法掩码出 −inf | fp16 下 −1e9 溢出 | 掩码在 fp32 上做,再转回半精度 |
| BFMS 主变列表无限增长 | 置换表合并成环 | 主变链去重 |
| BFMS 深度上去了质量下降 | 某层着法不足用了 break | 改成 continue |
| BFMS 收集阶段慢到不可用 | 反复调 encodeFeaturesAndMask | 预算 ord[],省 60 倍 |
| top-1 准确率涨了、棋力降了 | 指标只看一选 | 看 top2/top1、近优覆盖率、Kendall τ |
什么时候该走 PPO,什么时候别碰搜索
三类人对号入座:
- 做单机对弈、要求实时出招:PPO 无搜索是合适的。11M 参数、3.58 ms 一次前向,普通显卡甚至 CPU 都能跑,不需要搜索。
- 想冲顶级棋力:劝退。顶级引擎只有两条路——αβ + NNUE,或 AlphaZero 式全宽度策略 + MCTS。前者代表是皮卡鱼,权重 50MB 左右、1.5 μs/节点;后者要求策略头从第一天就学搜索访问分布。
- 已经把 PPO 模型训好了、想抢救:先量 top1N 与 expHN。低于阈值再谈调参;压先验只能追平 SL,追不过。
如果要从头做,原文给了四条比「继续调 PPO」更靠谱的方向:蒸馏 MCTS 的访问分布(天生全宽度)、列表式损失(Plackett-Luce,把 top-k 当整体优化)、用强引擎 MultiPV 构造排序软标签、别只盯 top-1 准确率(他们有过准确率涨 1.56 个百分点、棋力反而下降的实例)。
边界也说清楚:这是一位开发者的单项目复现,中国象棋、11M ViT、单张 4090、14.3 万局棋谱;ELO 差带 ±34(1.6σ),BFMS 的 10 局对比落在噪声内,只能当方向性证据。腾讯论文本身也没公开 VECT 的截断长度 L、DOP 的温度和阈值——作者是自己扫了 L=10 与 20 才定的 10。所以「照抄论文就能复现」这件事,从一开始就不成立。
同类的「指标好看但能力没涨」还有一例:6471 个测试全绿也不能直接合并,盲区都在指标之外。评测口径本身怎么定,可以对照 关掉思考省 4.5 倍 Token 的那组数看。
最后留个问题给做棋类 AI 的人:你量过自己模型的 top1N 吗?如果 32000 个节点里 99% 都在第一步,你加的每一分预算,其实都在给同一个着法做重复计算。
登录后可点赞、收藏与反馈。


