元宝搜索的数据怎么看:8 毫秒、400 台、157 信源、13 行业
官方给的一串性能数字里,只有两个对你直接有用。把 8ms、30ms、3200→400 台、157 信源逐条拆开,能看出这套检索的能力边界在哪。
2026 年 11 月 11 日,元宝搜索在 so.qq.com 上线。官方公布的性能指标里,8 毫秒和 30 毫秒常被混着引用,157 个信源常被当成"覆盖全网"。这些数字拆开看,边界比成绩更值得记住。
8 毫秒、30 毫秒、1 秒:三个数说的不是一件事
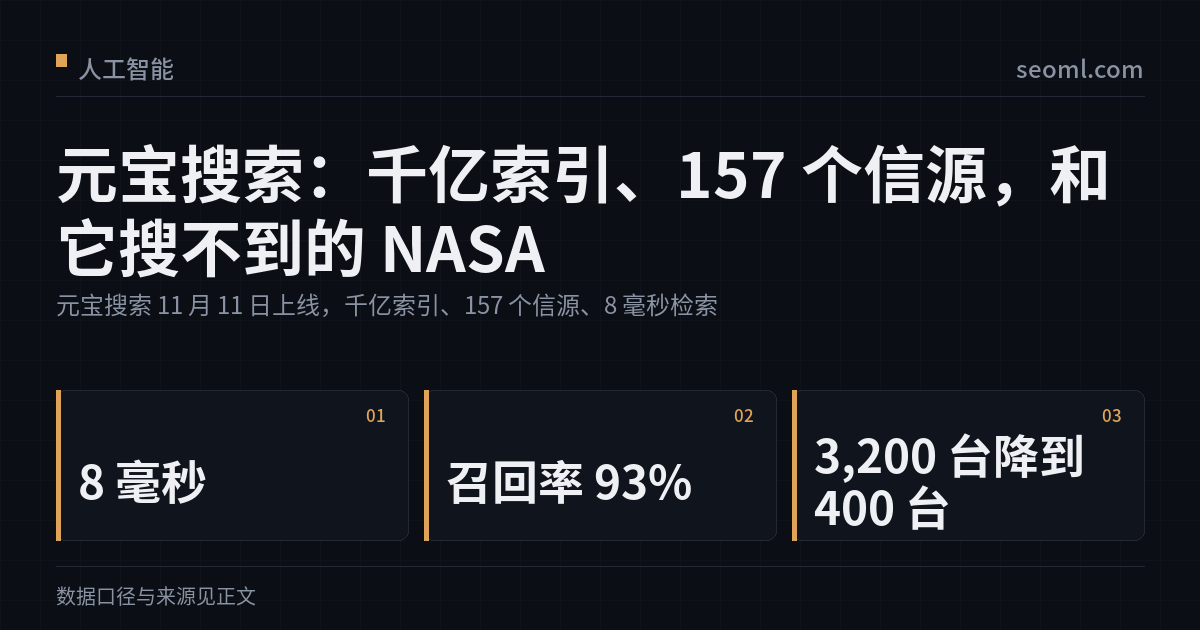
8 毫秒是底层索引检索的平均耗时,前提是保持 94% 的召回率。倒排索引、向量索引、融合提效三类索引拼在一起跑,这个数指的是"从索引里把候选捞出来"这一段。
30 毫秒是核心排序模型的推理耗时,官方说从 149 毫秒压到了 30 毫秒。这是另一段——把捞出来的候选排出先后。
1 秒是端到端收益:元宝 App 的整体响应因此少了近 1 秒。
混用会得出荒唐结论。有人看到 8 毫秒就去推"一次搜索 8 毫秒完成",但一次真实提问通常被拆成 3 到 5 个子问题,还可能调用十多个外部服务。8 毫秒只是链路上的一环,用户感知到的等待仍然在秒级。
这个区分有意义:它说明瓶颈已经从"找"转移到"想"。检索快到这个量级之后,再压 5 毫秒用户感觉不到,模型推理才是下一步的优化目标。
3200 台降到 400 台,省的是钱不是速度
这条常被当成性能进步,其实主要是成本故事。
官方口径是召回率从不足 80% 提升到 93% 以上,同时机器数量从 3200 台降到 400 台。召回率上去、机器数下来,靠的是自研磁盘向量索引和倒排索引的融合,以及 Gist Token 压缩——把长文档压成更短的表示,降低推理延迟和显存占用。
对使用者的含义只有一条:这套检索撑得住量。日均调用数亿次、支撑 WorkBuddy、ima、腾讯视频等 50 多个业务,是在对外开放之前就跑过的。ima 接入后有效信源召回量提升约 10%,腾讯视频的信息覆盖度提升 20%——后一个数字对应的是"大雨里跑了很久的韩国电影"这种模糊描述能被接住。
157 个信源,只覆盖 13 个行业
157 这个数字容易被读成"接了 157 家权威网站"。实际口径是:金融、医疗、法律、出行等 13 个垂直行业的 157 个信源。
平均下来一个行业 12 个。这个密度在垂直领域够用——财报类内容,A 股、港股、美股、日股、韩股的收录覆盖率官方称在 99% 以上。但出了这 13 个行业,157 这个数字就不提供任何保证。
所以"权威信源优先"是一条排序规则,不是一张白名单。它能保证金融、医疗这类高频领域优先出官方来源,不能保证你问的任何问题都有权威来源可引。
搜不到 NASA,是结构决定的
第三方实测里出现过搜不到 NASA 的情况。这不必然是 bug,更可能反映索引结构。
千亿级索引覆盖的是"全网网页 + 公众号 + 视频号 + 学术文献",重心明显在中文生态。境外机构站点、英文政府网站、非中文数据库,不在优先建设的方向上。官方在多个场合强调的都是中文内容纵深,不是全球覆盖。
这一点决定了两件事:查国内政策、行业报告、公众号观点,元宝搜索的起点比通用搜索引擎更靠前;查海外机构、英文一手资料,它可能连门都进不去,得换工具。
要接进自己的程序里,官方给了三条路:API、MCP、Skill。开发者侧的接入方式在 MCP 是什么 里有展开。B 端定价是每月 2000 次免费,超出后极速版 14 元/千次、标准版 20 元、旗舰版 26 元,旗舰版只对企业开放。
这些数字对你的实际用处
两条。
第一,把它当检索层而不是答案层。它的价值在于把公众号、视频号这些别处搜不到的中文内容捞出来,并给出可点开的引用。答案对不对,还得自己看原文。C 端入口是 元宝搜索,广告与答案分开陈列、可整块收起,这一点比多数 AI 搜索透明。
第二,用它之前先想清楚问的是哪类问题。国内行业信息、政策解读、公众号观点——它的强项;海外一手资料、冷门学科、非中文内容——换工具,别在它身上试。
一个可执行的判断:同一个问题,如果百度前三页都是营销稿,元宝搜索大概率能给你更好的起点;如果百度能直接搜到官方网站,元宝搜索的增量就不大。
登录后可点赞、收藏与反馈。