39健康网 SEO 实测:robots.txt 是一条 404 页面
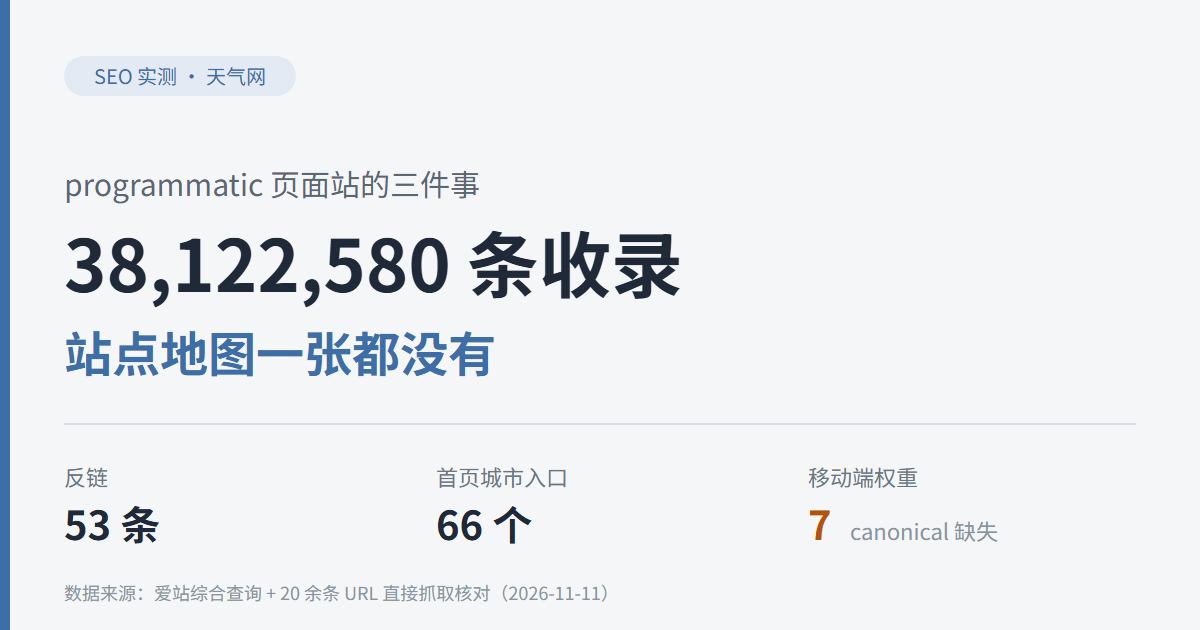
实测 39 健康网五个子域的抓取入口:主站 robots.txt 返回 200 但内容是 404 页面,四条站点地图路径全部软 404,首页 514 条内链里 271 条仍写死 http。附按优先级排序的修复清单。
39 健康网的抓取入口是坏的。访问 https://www.39.net/robots.txt 返回 HTTP 200、19,911 字节,内容是一句「抱歉,您访问的页面不存在」。
本文的结论来自 2026-11-11 18:00 的实测:curl 串行请求五个子域、四条站点地图路径与两次不存在的 URL,再用爱站数据交叉核对收录与排名口径。所有数字都可复现。
一、抓取入口:三个 200 里没有一个是 robots 文件
测试方法很直接:同一份桌面 UA,逐个子域请求 /robots.txt,记录状态码、Content-Type、响应体积,以及是否包含 Sitemap 指令。
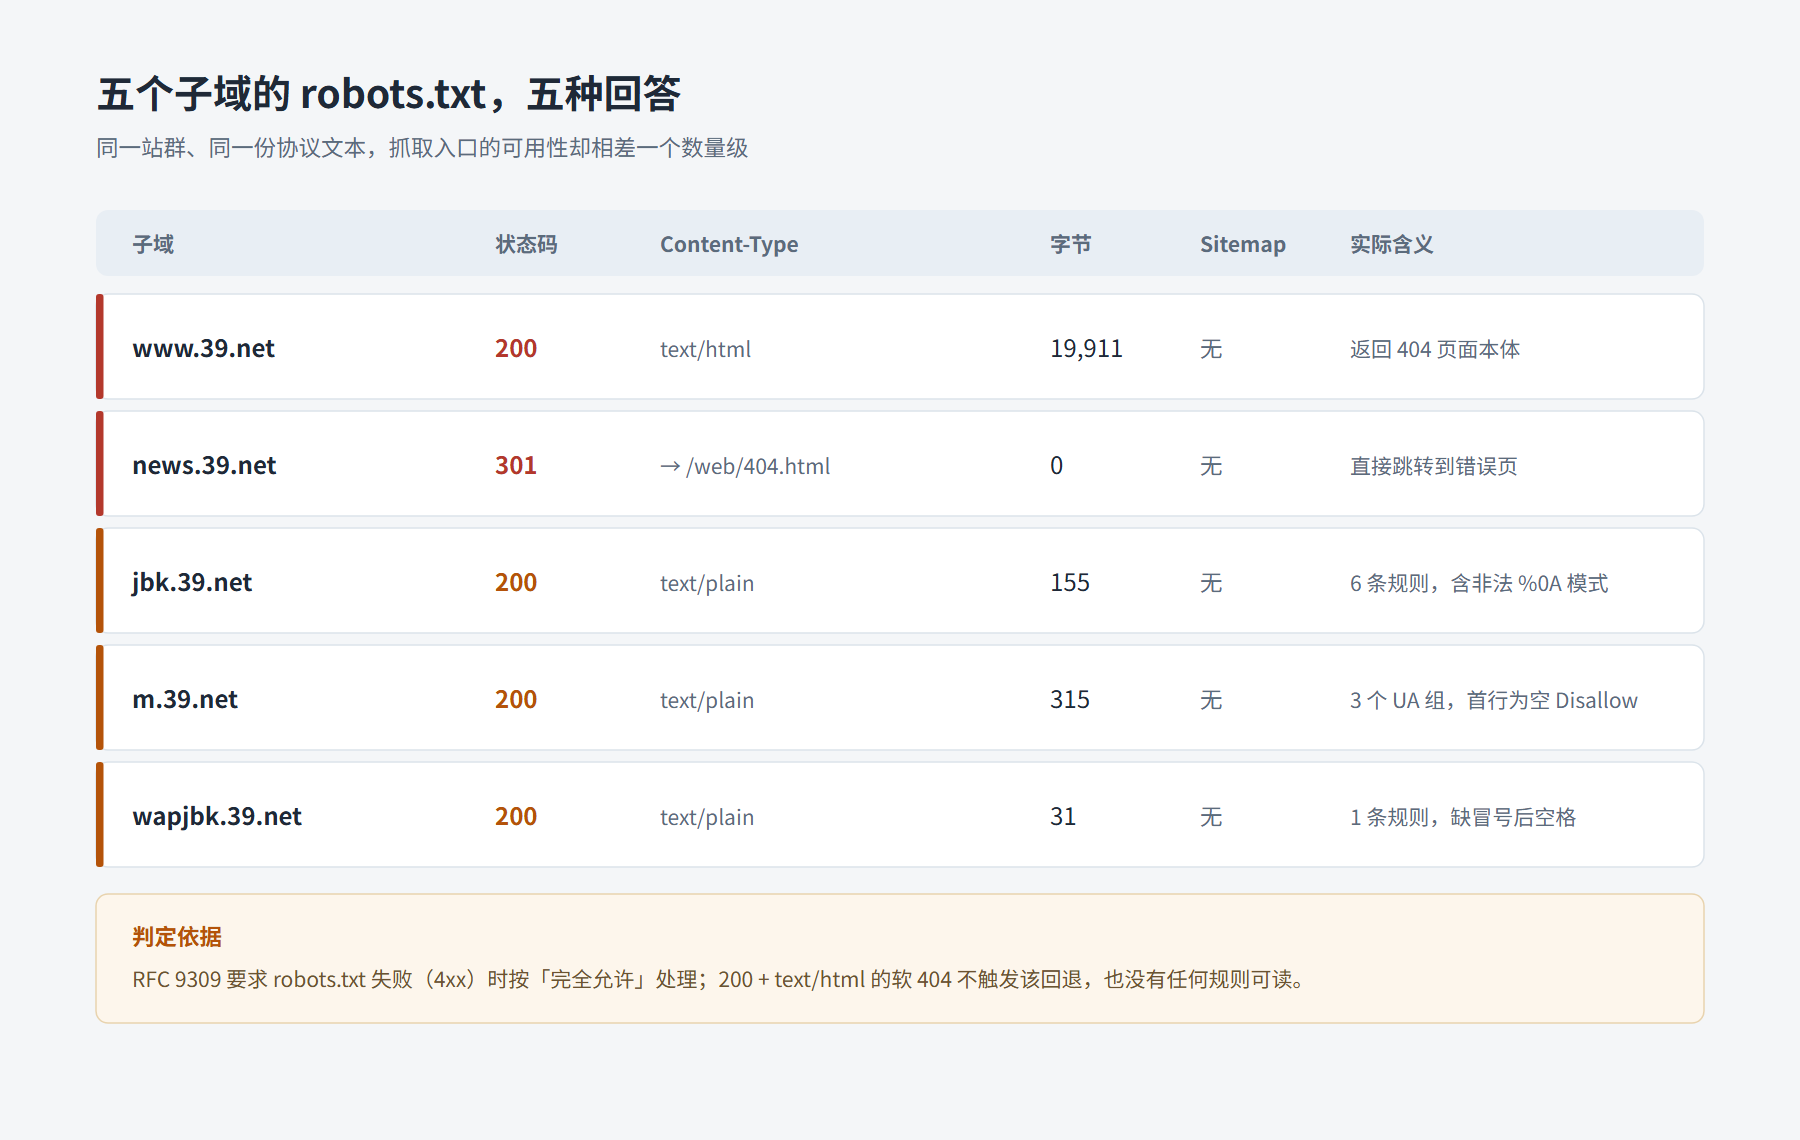
主站的情况最糟。www.39.net/robots.txt 返回 200,但 Content-Type 是 text/html,19,911 字节,与站内任意一条不存在路径的响应完全一致。
RFC 9309 的约定是:robots.txt 返回 4xx 时,爬虫应视为无限制并继续抓取。返回 200 加 HTML 则不触发这条回退——爬虫拿到一段无法解析的标记,既读不到规则,也读不到地图。
news.39.net 更彻底,直接 301 到 https://www.39.net/web/404.html。一条协议文件被跳转到错误页,等于主动声明「本子域不设 robots」。
另外三个子域给出了真正的 text/plain:疾病百科 155 字节、移动站 315 字节、移动疾病百科 31 字节。语法基本可用,细节都不干净。
疾病百科六条规则里有一条把换行符写成了字面的 %0A 混进通配模式;移动疾病百科的 Disallow 冒号后没有空格;移动站规则组首行是一条空的 Disallow,属无效行。三个子域也都没有 Sitemap 指令。
站点地图整体缺席。/sitemap.xml、/sitemap_index.xml、/sitemap.txt、/sitemap/index.xml 四条路径返回的全是那 19,911 字节的 404 页面。
404 本身也没做对。请求 /this-path-should-404-xyz/ 与 /news/99999999.html,两次都返回 HTTP 200。错误页里还嵌着 8 秒倒计时脚本,到点用 JS 跳回首页并附加 ref=404 参数。
| 测项 | 实测结果 | 判定 |
|---|---|---|
| 主站 robots.txt | 200 但为 text/html,19,911 字节 | 不可用 |
| 资讯子域 robots.txt | 301 跳转至 /web/404.html | 不可用 |
| 四条 sitemap 路径 | 全部返回 200 的 404 页面 | 缺失 |
| 不存在的 URL | HTTP 200(软 404) | 不合格 |
| 首页 canonical | http://www.39.net | 协议降级 |
| 首页内链 | 514 条中 271 条写死 http | 占 52.7% |
| 首页标题层级 | H1、H2、H3 均为 0 | 缺失 |
| 首页图片 alt | 37 张全部缺失 | 缺失 |
二、协议一致性:canonical 指向一条会二次跳转的地址
首页的 canonical 写的是 http://www.39.net。但这个地址本身要先 301 到 https://www.39.net/,页面此刻也是以 https 提供的。
canonical 的职责是声明「哪个 URL 是正版」。把一个需要再跳一次的地址当作正版,每轮抓取多消耗一跳,且与页面真实 URL 不一致。
裸域的跳转语义也不统一。http://39.net/ 返回 302 而非 301,落到 https://39.net/;而 https://39.net/ 与 https://www.39.net/ 都返回 200,两份 HTML 相差 2 字节。
于是同一个首页在四种 URL 形态下都能打开,其中三种不互相声明关系,唯一的 canonical 指向第四种。
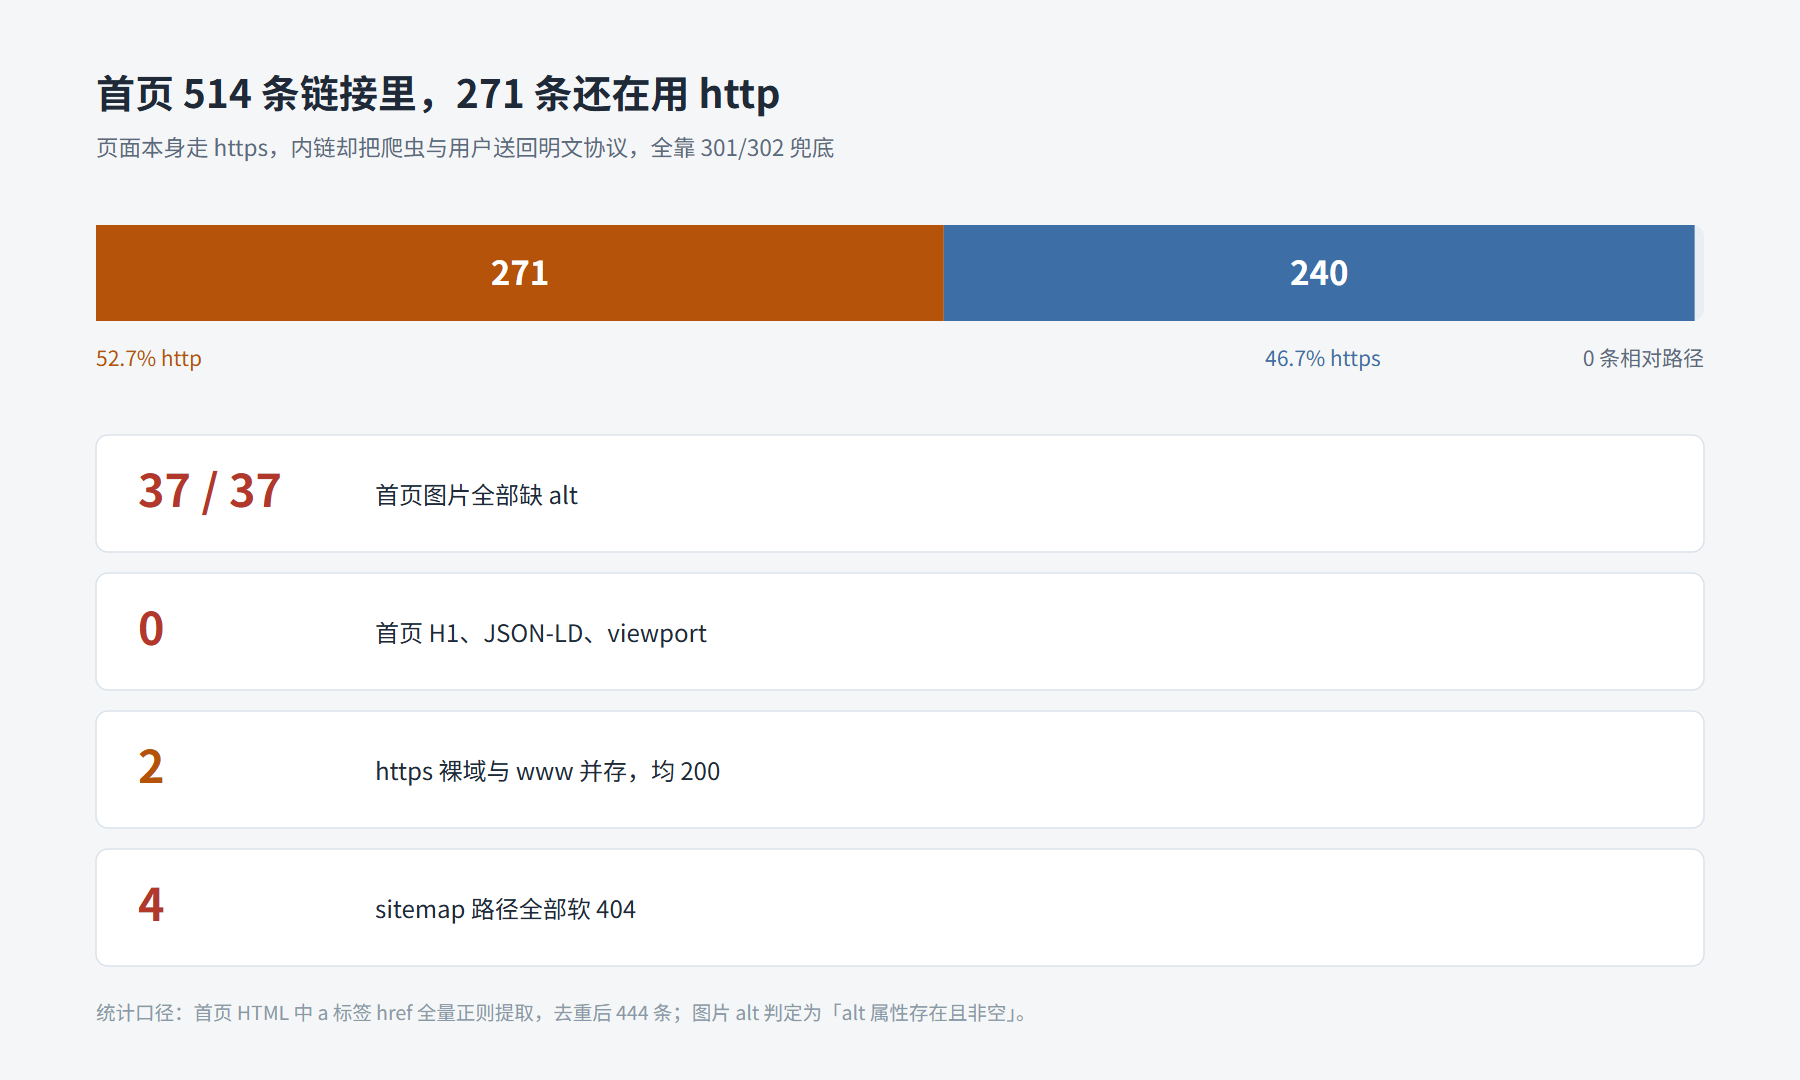
内链把问题放大了。首页 514 条 a 标签里,271 条以 http:// 开头,240 条以 https:// 开头,相对路径 0 条,全部是硬编码绝对地址。
子域各自为政更明显。首页链接指向就医助手 166 条、疾病百科 60 条、资讯 54 条、视频 24 条、育儿 21 条,共 13 个子域。
每个子域的协议与 canonical 策略都不一样:保健频道详情页 canonical 写 http://care.39.net/...,rel=alternate 写 http://m.39.net/...;资讯详情页干脆没有 canonical。http://care.39.net/ 的跳转同样是 302。
这套「按子域分治、各留一份配置」的形态在垂直站里很常见。宝宝树的 robots 白名单七条路径全部失效,也是同一种组织问题的另一种表现。
三、内容信号:首页没有一个标题标签
首页 HTML 里 H1、H2、H3 的数量都是 0。不是命名不规范,是整个文档没有标题层级,4,988 字可见正文靠 div 堆出来。
结构化数据也是 0。全站唯一的结构化输出来自资讯详情页的一段百度 cambrian 标记,字段齐全(title、pubDate、upDate、images),但只服务百度,没有 schema.org 的 Article 或 BreadcrumbList。
移动端信号是分裂的。用 iPhone UA 请求首页,拿到另一份 26,219 字节的页面:title 多出「中国」二字,keywords 变成「手机39健康网」,viewport 有了,可见正文却只有 444 字——桌面版是 4,988 字。
两份页面的 canonical 还不一样:桌面写 http://www.39.net,移动写 https://www.39.net/。
移动站的做法反而更规范。移动文章页 m.39.net/news/a_n1wttm1.html 的 canonical 指回桌面 https 版本,方向是对的;但桌面文章页没有对应的 rel=alternate,两侧关系只建立了一半。
图片替代文本基本缺位:首页 37 张图全无 alt,疾病百科频道页 56 张里 47 张没有,一条 2024 年的保健稿 34 张里 26 张没有。
四、优先级:先修抓取入口,再谈内容信号
先看这套结构目前的产出。爱站综合查询显示:百度权重 PC 1、移动 0;PC 关键词 110 个,前 10 名 29 个;移动关键词 7 个,前 10 名 0 个;百度收录 166,078 条;反链 137 条;域名年龄 29 年 9 个月。
收录量本身在剧烈抖动:11-03 显示 166,073,11-04 掉到 8,900,11-06 为 9,840,11-08 回到 166,078。这种量级的日间跳变通常不是真实增删,而是查询口径或索引分片在切换,但它会掩盖趋势。
360 侧同步在退:收录 7,120 条,一月减少 4,580 条。
流量结构也印证搜索不是主来源。预估日均 IP 约 24 万、PV 约 36 万,而百度来路只有 136 到 161 个 IP。绝大部分访问来自直接输入、书签与站外入口,搜索只贡献零头。
| 建议 | 具体做法 | 优先级 | 工期 |
|---|---|---|---|
| 修复 robots.txt | 主站与资讯子域返回可解析的 text/plain,附 Sitemap 地址 | P0 | 0.5 天 |
| 软 404 改真 404 | 错误页返回 404 或 410,删除 8 秒 JS 跳转 | P0 | 1 天 |
| canonical 统一 | 首页与保健子域改为自指 https,裸域 302 改 301 | P0 | 0.5 天 |
| 内链协议替换 | 271 条 http 绝对链接改 https 或站内相对路径 | P1 | 2 天 |
| 补齐语义结构 | 首页加 H1、Article 与 BreadcrumbList,补 viewport | P1 | 3 天 |
| 图片 alt 回填 | 首页 37 张、频道页 47 张无 alt 图 | P1 | 2 天 |
| 建立站点地图 | 按子域拆索引,lastmod 与真实更新时间对齐 | P2 | 3 天 |
| 移动信号对齐 | 桌面补 rel=alternate,两侧 canonical 互指 | P2 | 2 天 |
| 分域收录监控 | 按子域追踪收录量,替代全站 site 查询 | P2 | 持续 |
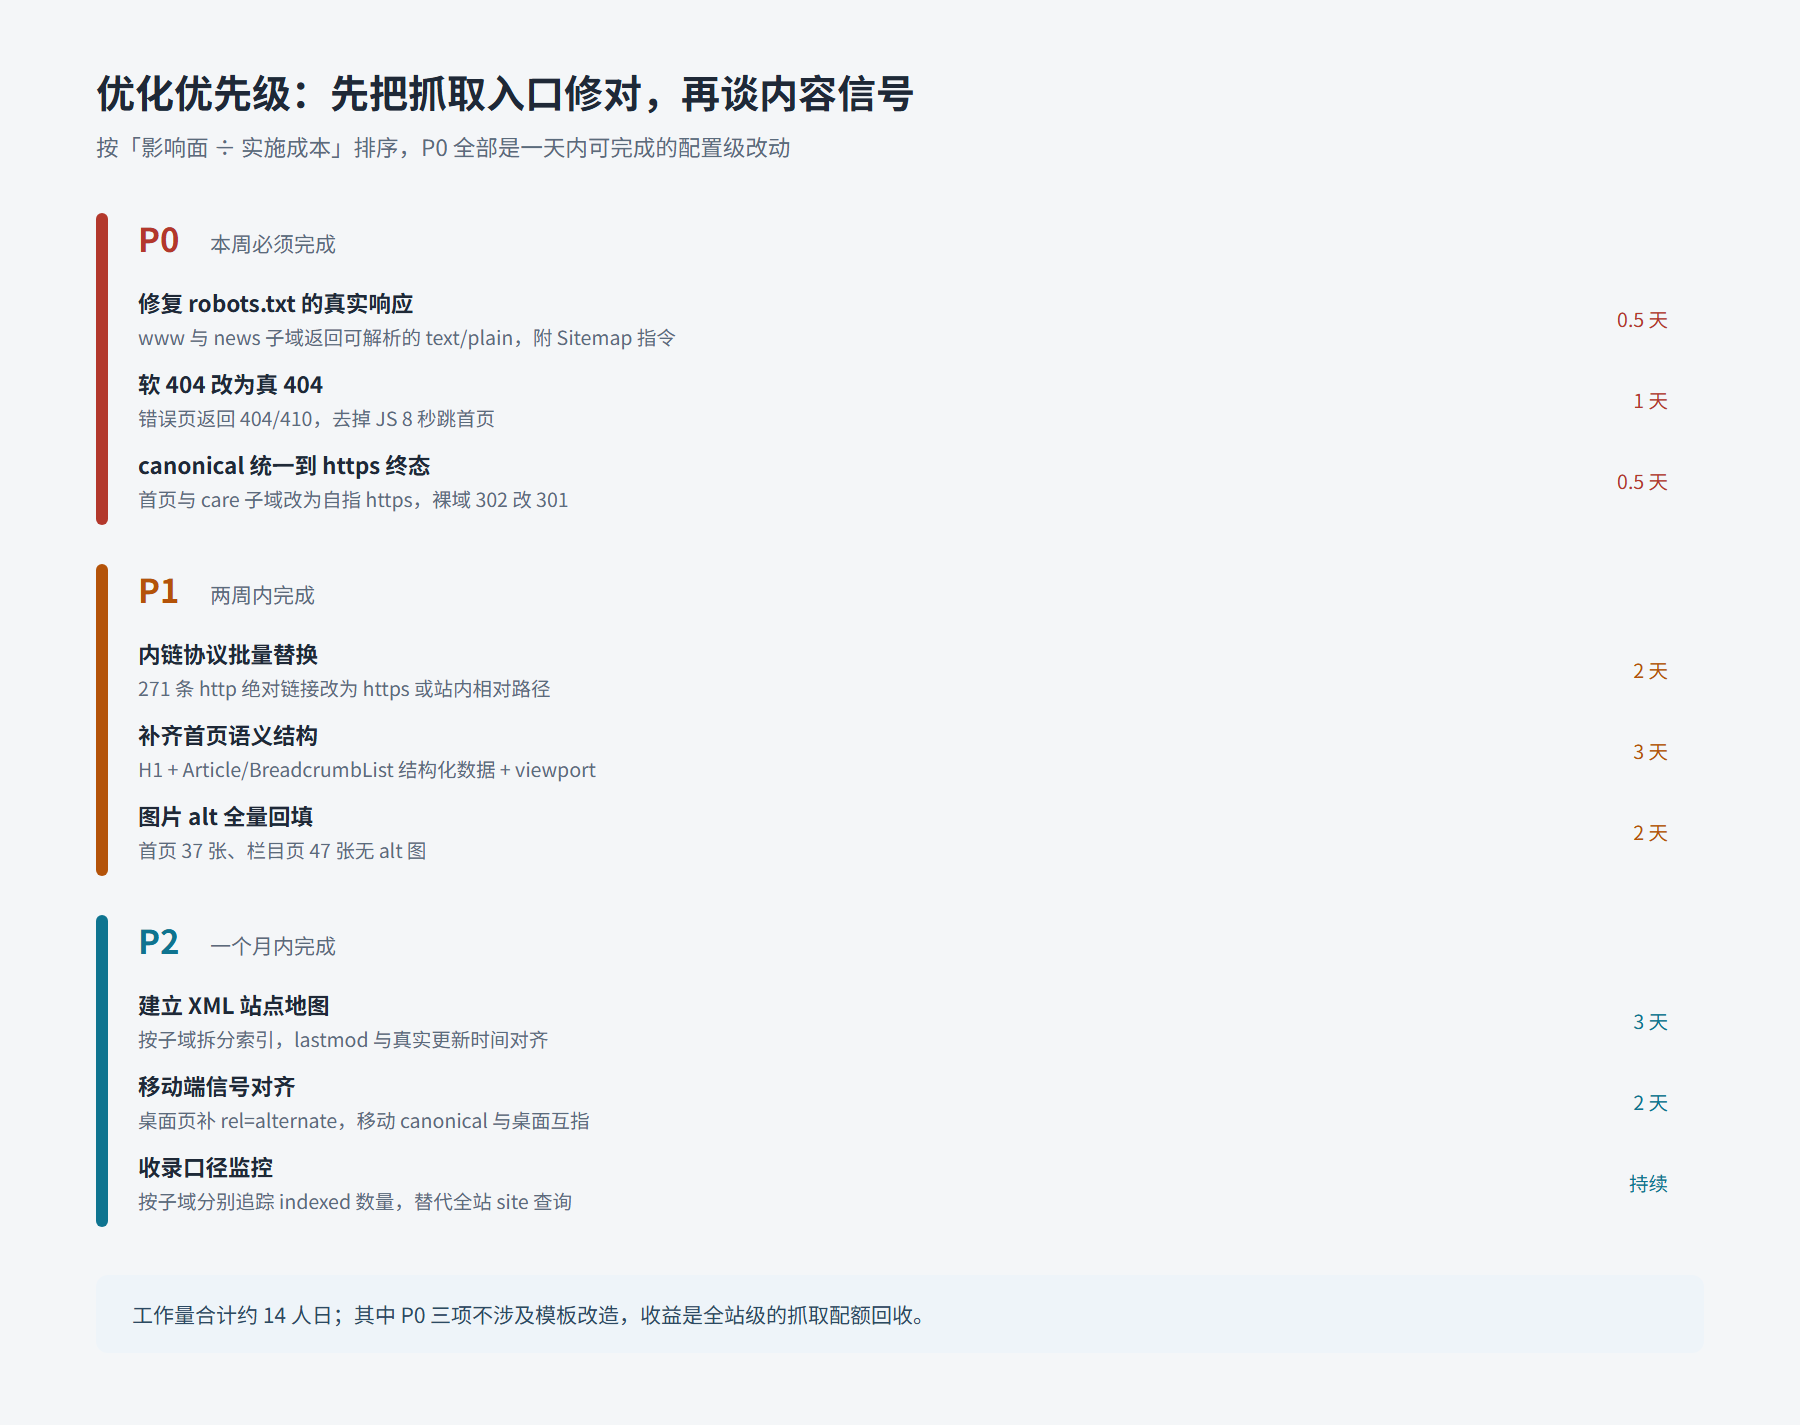
P0 三项都不涉及模板改造。robots 改成 text/plain 是运维侧半小时的工作;错误页返回 404 并去掉倒计时,只需改一个控制器;canonical 统一到 https 终态,是模板里的一个变量。
P1 里最值得做的是内链协议替换。271 条 http 链接每被抓一次就产生一次 301 或 302,按首页权重折算,这部分抓取预算的损耗是全站性的。
P2 属于长期工程。站点地图要按子域拆分并让 lastmod 与真实更新对齐——孔夫子旧书网停摆十年的 sitemap 演示过代价;华律网只覆盖 0.016% 内容的站点地图,则演示了「有文件但没意义」的另一种失败。
一句总结:39 健康网的问题不是内容不够,而是入口与信号不一致。13 个子域、四种 URL 形态、五种 robots 回答,搜索引擎每次来访都要重新判断「这站以哪个为准」。
这类损耗不会出现在任何一个单页的诊断报告里,只会体现为收录抖动与排名停滞。
登录后可点赞、收藏与反馈。