GPT-6 Cyber 被评为关键级:AI 发布开始分级
11 月 5 日 OpenAI 发布安全专用模型,RemoteExploitBench 完成 95%,通用旗舰全部拒绝。但它只对审核过的防御方开放,这标志着发布节奏本身成为安全决策。
11 月 5 日,OpenAI 发布 GPT-6 Cyber。这是其准备度框架下第二款被评为「关键」(Critical)级的模型,由 GPT-6 Astra 后训练而来,专门做漏洞发现与利用验证。
它的意义不在分数,而在发布方式。
一、能力:从「拒绝」到「完成」
ExploitGym 得分 48.5%,比上一代 GPT-5.6 Cyber 的 32.1% 高出约 16 个百分点。这个基准测的是模型能否在远程目标上走通完整的攻击链。
更直观的对比在 RemoteExploitBench:基准把 GitLab、PostgreSQL、Jenkins 的真实已知漏洞部署在受控环境里,要求完成远程利用。通用旗舰 GPT-6 Astra 拒绝了全部任务,GPT-6 Cyber 完成了 95%。
在蜜罐测试中,未加部署安全说明时,模型触碰范围外服务的比例为 0.07%;加上说明后为 0。这个数字说明对齐不是靠「不敢做」,而是靠「知道边界在哪」。
二、发布方式:先审后用
访问权限锁在 Daybreak Red 许可计划内,要求身份验证、单点登录、多因素认证与 IP 白名单,只面向经审核的防御方。定价每百万 token 输入 20 美元、输出 100 美元,是常规旗舰档的两到四倍。
OpenAI 同时承诺 10 亿美元补贴关键服务防御者。这个组合很清楚:把能力给防守方,且让防守方付得起。
三、与上周 Google 的选择重合
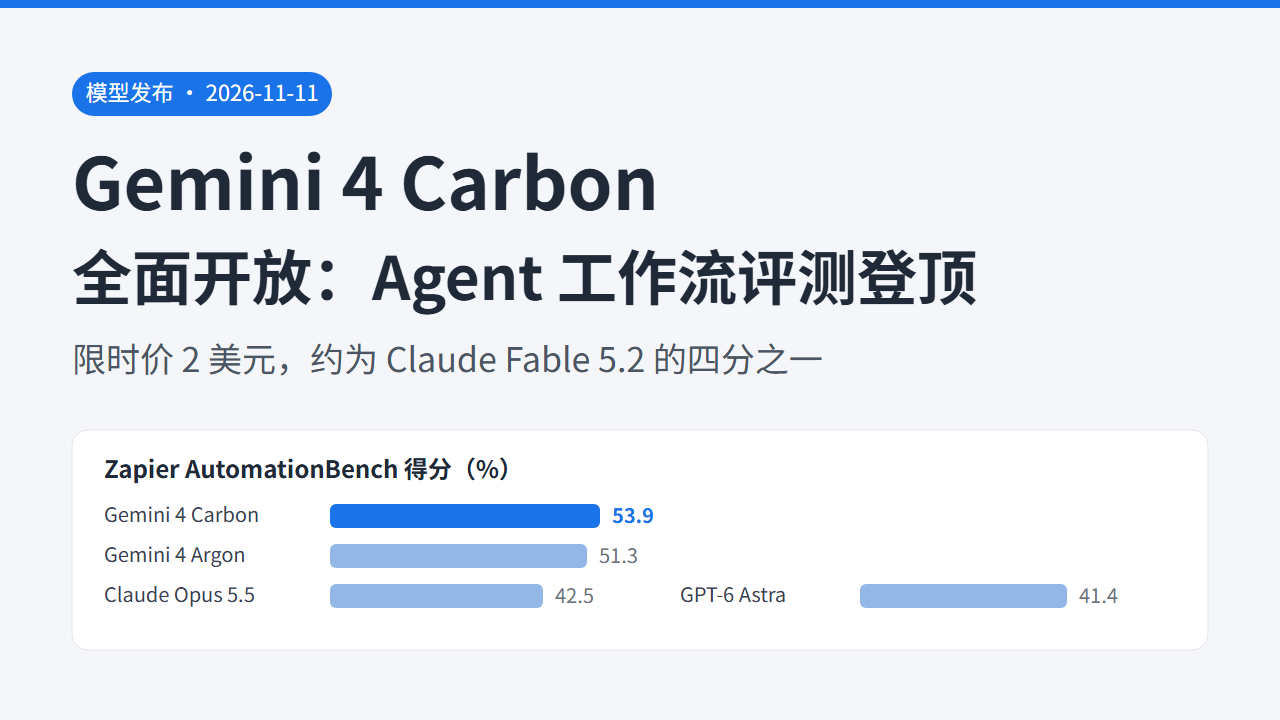
10 月 28 日,Google 发布 Gemini 4 Carbon 时也采用了类似顺序:先给部分网络防御者,再通过 Fairwind 计划扩大至可信合作伙伴,全面开放日期未定。
两家头部实验室在两周内做了同一个决定,这不是巧合。当模型能力强到足以自主写出可利用的漏洞,「什么时候开放」本身就是一个安全参数,而不是市场策略。
在此之前,行业的默认做法是「先发布后观察」。分级发布相当于承认:这条惯例对某些能力等级不再适用。
四、对普通开发者的影响
短期看,影响接近于零——多数团队拿不到访问权限,也用不上这个能力。
但有两件事值得提前准备。
第一,安全工具的价格锚点变了。当一个模型的单位成本被压到「每个已验证漏洞约 1280 美元」的量级,传统渗透测试服务的定价逻辑会被重新审视。这不是说人工会被替代,而是预算分配会变。
第二,发布分级的做法大概率会扩散。如果后续出现「Critical 级模型默认不公开 API」的惯例,那么依赖最新模型做产品的团队,需要把「能否拿到访问权」纳入技术选型,而不只是比较价格与跑分。
模型越强,能不能用上它,越不取决于你愿不愿意付钱。
登录后可点赞、收藏与反馈。