Claude Fable 5.2 发布:编程跑分登顶,30 小时形式化费马大定理
Anthropic 发布新一代旗舰 Fable 5.2 与 Mythos 5.2:同一底座、两种准入。FrontierCode 2.0 跑分 49.1% 登顶,标准价下调 20%,官方披露 1000 个 Agent 30 小时完成费马大定理形式化证明。本文梳理跑分、价格与选型建议。
Claude Fable 5.2 发布
Anthropic 于北京时间 11 月 10 日凌晨发布新一代旗舰模型 Claude Fable 5.2 与 Claude Mythos 5.2。本文梳理两款模型的定位差异、关键跑分、价格变化与官方披露的长程任务实测结果,并给出选型建议。所有评测数据均来自 Anthropic 官方口径,尚待第三方独立验证。
一、两款模型:同一底座,两种准入
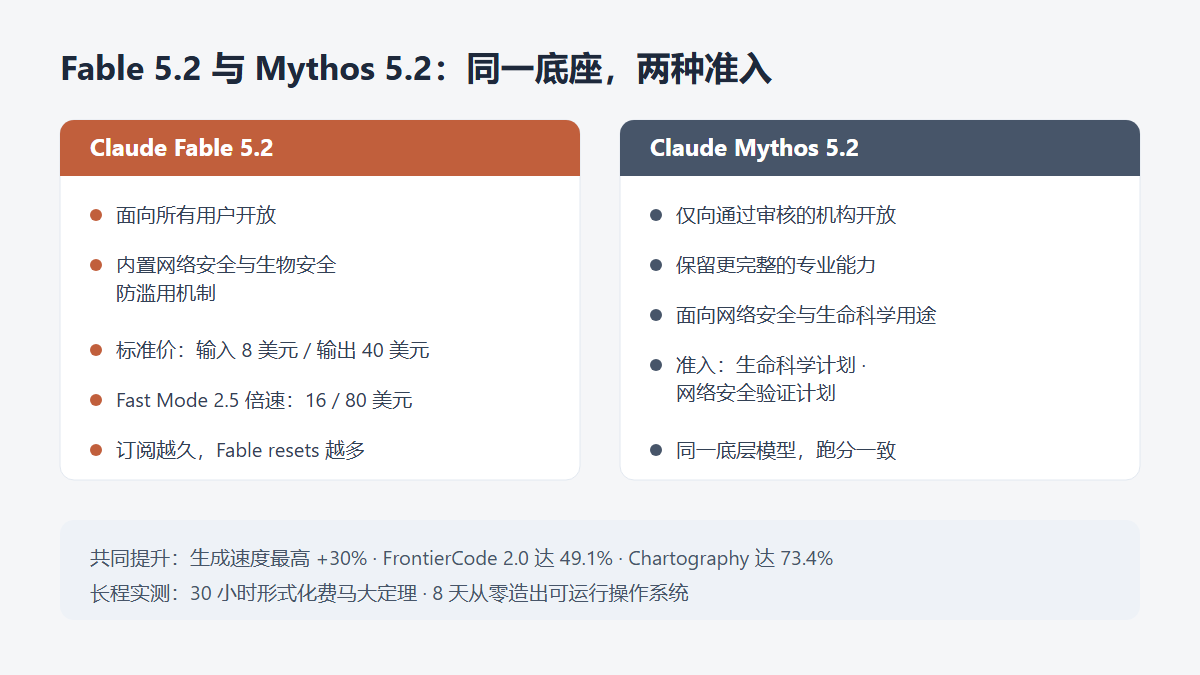
Fable 5.2 与 Mythos 5.2 采用相同的底层模型,核心区别在于安全限制与访问权限:
- Claude Fable 5.2:内置针对网络安全与生物研究的防滥用机制,面向所有用户开放,是常规使用入口。
- Claude Mythos 5.2:保留更完整的专业能力,仅向通过审核的机构开放,主要用于网络安全与生命科学等有益领域,申请通道为 Anthropic 近期扩大的生命科学计划与网络安全验证计划。
官方称两款模型的生成速度最高比上一代(Fable 5.1 / Mythos 5.1)提升 30%,并提供可选的 Fast Mode,Token 生成速度最高可提升至原来的 2.5 倍。订阅侧还引入了类似竞品的留存福利:订阅时间越长的用户,获得的 Fable resets(重置次数)越多。
二、关键跑分:编程与图表理解提升幅度最大
在 Anthropic 公布的横评中,Fable 5.2 在多数能力维度领先。变化最大的两项:
- FrontierCode 2.0(考察 AI 对开源项目的代码修改能否达到维护者愿意接纳的标准):得分从上一代的 32.4% 升至 49.1%,提升 16.7 个百分点,超过自家 Opus 5.5(45.5%)、OpenAI GPT-6 Astra(42.8%)与 Google Gemini 4 Carbon(41.1%)。
- Chartography(图表理解,关系财报图表与实验数据分析的基础能力):从 44.8% 升至 73.4%,提升近 29 个百分点。
- FrontierSWE v2(软件工程):69.9%,较上一代提升 13.6 个百分点。
- RoboDojo(模拟双臂机器人控制):成功率达 64.9%,约为 GPT-6 Astra 的两倍,反映模型依据摄像头画面判断环境、安排动作的能力明显增强。
FrontierCode 2.0 横向对比如下(得分越高越好):
| 模型 | 得分 |
|---|---|
| Claude Fable 5.2 | 49.1% |
| Claude Opus 5.5 | 45.5% |
| GPT-6 Astra | 42.8% |
| Gemini 4 Carbon | 41.1% |
| Claude Fable 5.1(上一代) | 32.4% |
值得注意的是,Fable 5.2 以较低的推理强度取得了接近 Opus 5.5 最高推理强度的成绩。
三、价格:标准价下调 20%,单任务成本约为 Opus 5.5 的一半
标准 API 定价较上一代下降 20%:
| 档位 | 输入(每百万 Token) | 输出(每百万 Token) |
|---|---|---|
| 标准模式 | 8 美元 | 40 美元 |
| Fast Mode(最高 2.5 倍速) | 16 美元 | 80 美元 |
结合跑分看,这意味着 FrontierCode 2.0 场景下的单任务成本约为 Opus 5.5 的一半。对高频调用编程智能体的团队而言,价格曲线与能力曲线出现了同向改善,这是本次发布在商业层面最有分量的信号。
四、长程任务实证:30 小时形式化费马大定理
Anthropic 披露了发布前测试阶段的一批长程任务结果:
- 数学:1000 个 Agent 协作,连续工作 30 小时,完成费马大定理的形式化证明。
- 系统工程:1000 个 Agent 连续工作 8 天,从零造出一套可在笔记本电脑上运行的操作系统。
- 硬件设计:从零设计出三款能够正常运行的电子设备。
- 基础科学:解决了两个黑洞物理学领域尚未解决的问题。
需要说明的是,以上均为官方测试环境中的自述结果,具体任务定义、评审标准与复现条件尚未完全公开,应作为能力上限参考而非确定性结论。
五、观察:IPO 冲刺期的节奏信号
这次发布有两个值得注意的背景:其一,距离 CEO 达里奥·阿莫代伊 9 月公开呼吁放缓 AI 发展速度仅过去约两个月,这是其表态后 Anthropic 首次推出前沿模型;其二,Anthropic 正筹备估值高达 1 万亿至 1.5 万亿美元的 IPO,需要用新模型证明自身技术领先性以支撑估值。
对普通开发者的可执行建议:
- 编程与智能体场景:将 Fable 5.2 与 Opus 5.5 做 A/B 成本质量对比,重点看单任务成本与返工率,而非单点跑分。
- 安全研究机构:关注 Mythos 5.2 的准入路径,提前准备生命科学计划或网络安全验证计划的申请材料。
- 成本敏感场景:若预算受限,可结合本站此前报道的轻量模型路线(如 Meta Muse Ember 的 0.14 美元单任务定价)做混合路由,把旗舰模型留给高难度任务。
相关阅读
- 上一代模型的参数与定价速查:Claude Fable 5.1 规格速查
- 轻量模型成本路线参考:Meta Muse Ember:0.14 美元一次任务,小模型接管执行层
- 国产模型的性价比对照:蚂蚁百灵 Ling-3.2-flash 发布:560B 参数只激活 25B
本文为资讯整理与原创分析,数据来自 Anthropic 官方公告及机器之心、财联社、凤凰网科技等媒体报道。
登录后可点赞、收藏与反馈。