百度词元所:日均 7000 亿 Token,平均一次调用 1.4 万
百度世界 2026 发布的词元所,试运营一个月日均调用 5000 万次、7000 亿 Token,均值 1.4 万 token 一次。平台主打验真与征信,但同一套指纹方法在 2026 年 3 月的审计里,24 个端点有 58.33% 没过关,MedQA 准确率从 83.82% 掉到 36.95%。
7000 亿除以 5000 万,等于 1.4 万。百度在 11 月 12 日的百度世界 2026 上给出这两个词元数字,一除就露出词元所的负载形状:平均一次调用 1.4 万 token,这不是聊天窗口的量级。
一、两个数字相除,先得到一次调用的体积
三个运营数字都是百度官方披露:入驻供应资源超过 100 个、日均调用次数突破 5000 万、日均调用 Token 超过 7000 亿。它们没有第三方核实,但彼此自洽,且「突破」与「超过」方向一致,都是往下保守,商值的量级站得住。
1.4 万 token 是一次调用的平均值
7000 亿 ÷ 5000 万 = 14,000。这个均值比普通对话高一个数量级:单轮问答的输入加输出通常落在 500 到 2000 token,带长文档的检索增强请求常见 1 万到 3 万。1.4 万正好落在后一档。
它说明柜台上跑的主要不是聊天,而是带上下文的任务型调用、批量处理和智能体循环。
这个判断在百度自己的另一组数字里有旁证:过去一年,百度内部日活智能体从日均 0.5 万个涨到 3.7 万个,智能体每周完成的有效任务从 8.4 万个涨到超过 100 万个。智能体天然是多步、长上下文的负载,与 1.4 万的均值互相印证。
摊到 100 个供应资源,每家每天 70 亿
100 是「资源数」而不是「供应商数」。按现场口径,同一个模型可以有多家供应商挂牌,买家能横向比价,所以真实分布是长尾,均值只能作量级参照。即便如此:7000 亿 ÷ 100 = 每家每天 70 亿 token,5000 万 ÷ 100 = 每家每天 50 万次调用。
这个体量改变的是抽检的性质。一次指纹核验不是发一个请求,而是几十到上百条探针,每条都真实消耗 token。当平台上有 100 个资源、每个资源若干模型,按月抽检一轮,成本已经是一笔需要预算的账,而不是上线前跑一遍测试。
一个分母:全国日均词元调用量
有行业分析文章把 2026 年 3 月的全国日均词元调用量写作 140 万亿。若按这个口径,7000 亿约占 0.5%。该数字未见官方发布,只能当量级参考。它说明的是柜台刚开张——0.5% 是起跑线,不是天花板。
| 指标 | 数值 | 披露口径 | 派生量 |
|---|---|---|---|
| 入驻供应资源 | 超过 100 个 | 试运营一个月 | 每家每天约 70 亿 token |
| 日均调用次数 | 突破 5000 万 | 同上 | 每家每天约 50 万次 |
| 日均调用 Token | 超过 7000 亿 | 同上 | 单次调用均值 1.4 万 |
| 全国日均调用量 | 约 140 万亿 | 行业文章引用,未核实 | 占比约 0.5% |
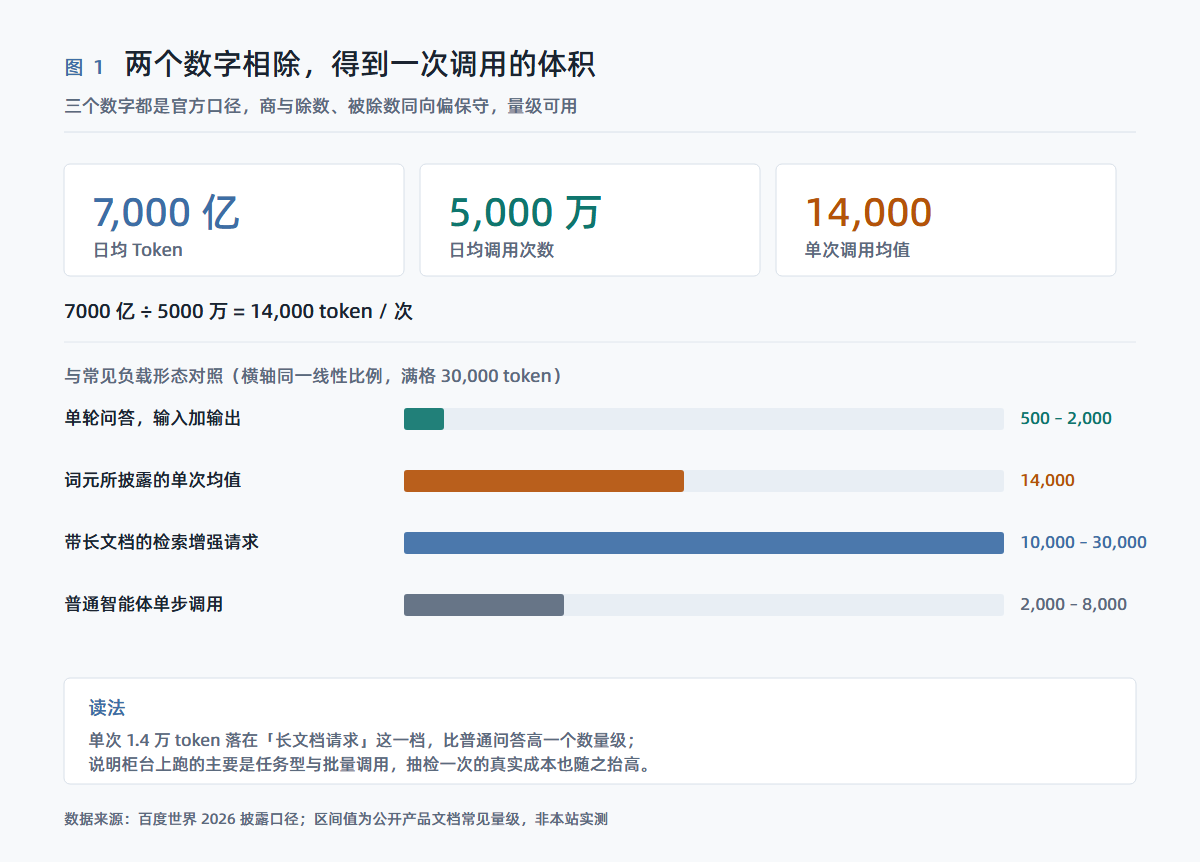
图 1:三个官方数字的商落在「长文档请求」这一档,说明抽检一次的真实成本被抬高了。
二、验真要对的是一本 2026 年 3 月的账本
词元所的验真手段在官方现场说明里是四步:模型指纹比对、能力测试、性能与可用性测试、容量压测;上线后转入定期抽检拨测和全链路实时监测。这套方法并不新。
2026 年 3 月,德国 CISPA 亥姆霍兹信息安全中心的团队用同一条思路审了 17 个影子 API,论文标题就叫《真金白银,假模型》(arXiv 2603.01919)。它的结论可以直接当成这套机制的下限参照。
24 个端点,58.33% 没过关
45.83% 未通过指纹核验,另有 12.50% 的余弦距离显著偏离官方模型,合计 58.33%。也就是说,24 个端点里只有 10 个能通过「你给我的确实是你宣称的那个模型」这一关。
这些端点不是无名小站。论文选的是被学术论文正式引用过的服务商,也就是说,有研究者用它们跑过实验、发过结论,而那些结论建立在另一个模型之上。
MedQA 从 83.82% 掉到 36.95%
医疗基准 MedQA 上,官方 Gemini-2.5-flash 是 83.82%,影子 API 平均 36.95%,差 46.87 个百分点,保留率 44.1%。法律基准 LegalBench 低 40 至 43 个百分点,推理基准 AIME 2025 上部分端点低 40 个百分点。
这就是「能力兑现度」的实体。它不是榜单上的名次变化,而是医疗问答的正确率腰斩、法律条文引用的判断变错。虚标参数在演示里看不出来,在专业场景里就是错误率翻倍。
| 审计项 | 官方 API | 影子 API | 差距 |
|---|---|---|---|
| MedQA 准确率 | 83.82% | 36.95% | 低 46.87 个百分点 |
| LegalBench 准确率 | 基准值 | 低 40 至 43 个百分点 | 同左 |
| AIME 2025 准确率 | 基准值 | 部分端点低 40 个百分点 | 同左 |
| 模型指纹核验 | 自身即基准 | 24 个端点 10 个通过 | 58.33% 未通过 |
| 价格对准确率的预测力 | 不适用 | OLS 回归无显著相关 | 不显著 |
指纹方法的准确率是 96%,不是 100%
论文在已知真值的受控实验里测了两种判别方法:LLMmap 准确率 96.0%,MET 88.3%,两者一致性 Cohen κ = 0.512。96% 意味着审 24 个端点,期望仍有约 1 个判断是错的;若平台按月抽检 100 个资源,误判的量级是 4 个。
这个精度足够做准入,不足以下结论。所以验真的正确用法是:把可疑资源挡在门外,而不是给通过者发终身通行证。
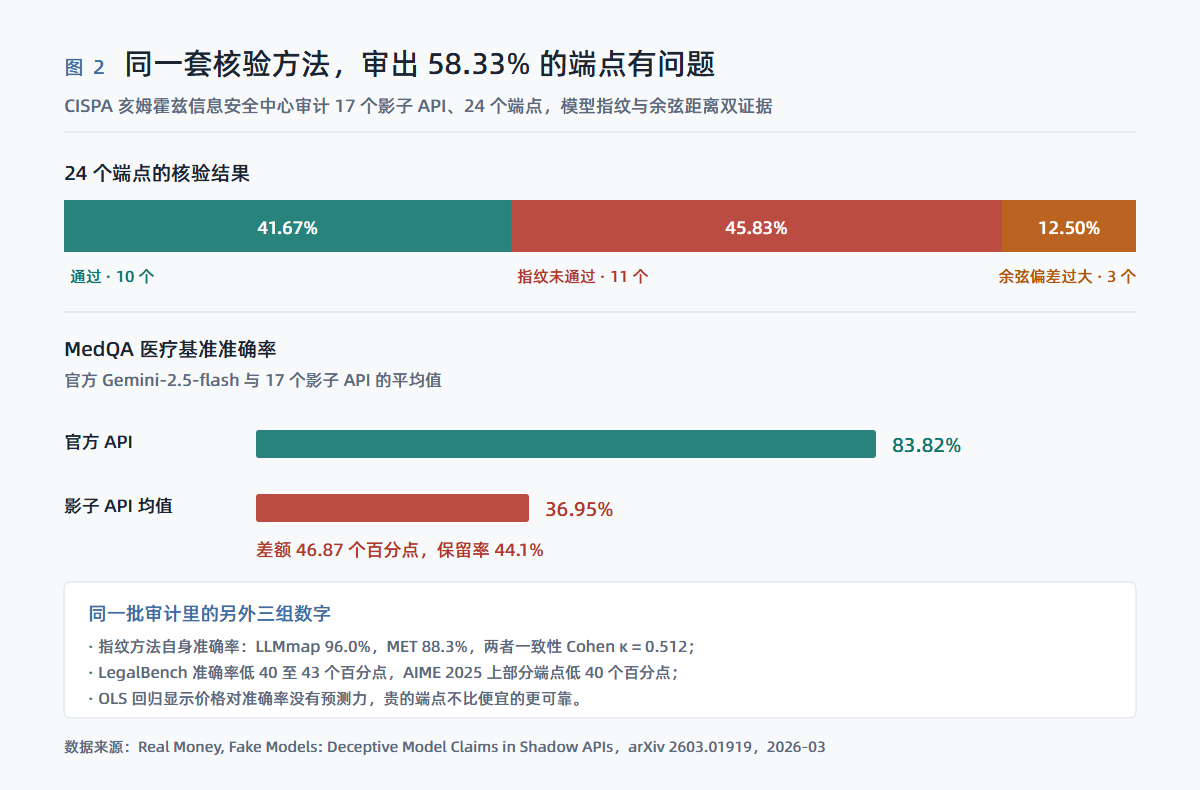
图 2:同一批审计里,价格对准确率没有预测力,延迟标准差超过官方 2 倍则是掉包的强信号。
三、交易所挂出来的是价格,买家买的是兑现
词元所的产品页把同一模型的多家供应商排在一起,字段包括价格、首 token 延迟、近 7 天调用成功率、调用量、运行状态,以及信用测评入口。这套字段对采购方是真实的进步,过去这些信息只能靠试。
但它同时暴露了缺口:这些字段都是可自动采集的「能用」指标,而买家付钱买的是「能力兑现」。
价格对准确率没有预测力
论文做了 OLS 回归,结论是价格对准确率保持没有预测力。贵的端点不比便宜的更可靠,便宜的也不必然更差。这条结论直接否掉了按单价排序的采购习惯。
词元所把价格、延迟、成功率并列展示是对的,但三者加起来仍然回答不了「我拿到的能力是不是我付钱买的那一档」。这一列只能由平台的抽检结论补上,而抽检过程买家看不到,只能看到结论——这就把信任从供应商转移到了平台。
三类风险,第三类最难抓
| 风险类型 | 具体表现 | 准入测试 | 持续监测 |
|---|---|---|---|
| 套壳换皮 | 收旗舰价,实际跑小模型 | 能拦住 | 复核 |
| 量化裁剪 | 换更便宜的量化版仍按原版标称 | 多数能拦 | 复核 |
| 静默漂移 | 模型是真的,中途换了版本 | 拦不住 | 唯一手段 |
| 参数虚标 | 宣称上下文或能力高于实际 | 看测试设计 | 容量压测 |
前两类是假货,指纹一比就露。第三类不是假货:模型是真的,只是中途换了版本,逐条比对每次都通过,问题出在时间维度上。现场提到的客户案例正是这一种——接入初期表现正常,用一段时间后质量下滑,直到投诉才发现。
这也解释了为什么「上线后定期抽检拨测」比「准入测试」更值得投入。准入是一次性动作,漂移是持续过程,闸门必须一直跑,不能只在门口跑一次。
信用分评的是差异,不是水平
官方口径把两件事拆开:质量分看能力、性能、质量、成本的绝对水平;信用分看真实性、性能、能力、合规、履约的兑现程度。
这个拆分是对的。绝对水平有公开榜单可参照,兑现程度却一直没人替买家查。但拆分也留了缺口:信用分的权重不公开,供应商无法自证,买家无法复算。这是交易平台治理的常见问题,不是词元所独有;只是当一个平台以「可信」为核心卖点,可复算就从加分项变成了必须项。
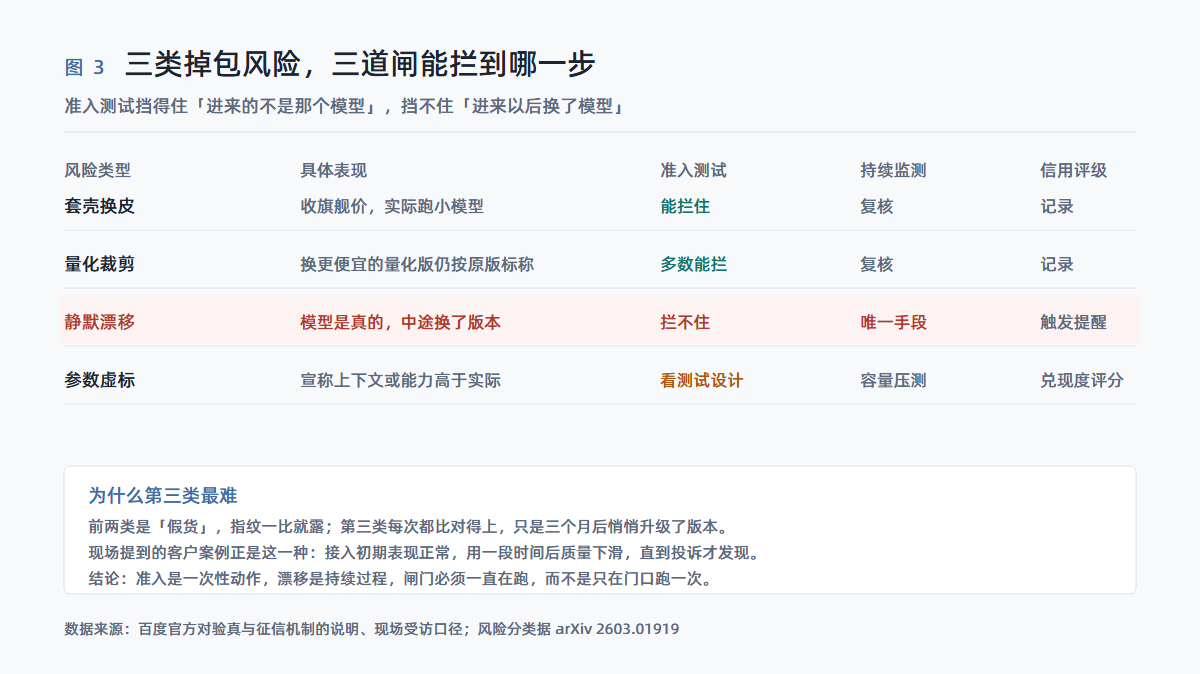
图 3:静默漂移是唯一一类准入测试必然放行的风险,也是唯一必须靠持续监测发现的风险。
四、同场的 2800 亿参数,与四条采购建议
5% 的激活率说明什么
同场发布的文心 5.5 Flash 预览版:总参数 2800 亿,每个 token 激活 140 亿,最长支持 100 万 token 上下文。2800 ÷ 140 = 20,激活率 5%。
这个比例与主流稀疏模型同一量级——DeepSeek-V3 是 671B 总参、37B 激活,约 5.5%。所以 5% 本身不构成差异点,稀疏早已是默认做法。真正的差异点在 100 万上下文的单价,而这次通稿没有给单价。
同期披露的还有两款应用模型:文心闪电深度思考模型用反馈式 KV 压缩稀疏注意力配合快慢思考协同,文心一镜微表情大模型支持 4000 字文本驱动、按 6 大维度 200 个子维度描述表情与动作。这两个是给具体场景用的,不是给榜单用的。
官方通稿这次没给分数
对 Terminal-Bench 与 AutomationBench,官方表述是「取得了具有竞争力的得分」,没有数值。
同一天,谷歌发布 Gemini 4 Hydrogen,给的是另一种密度:Artificial Analysis 智能指数默认档 51 分、超高思考档 54 分,Terminal-Bench 4.1 从 18.2% 提到 57%,定价每百万输入 1.50 美元、输出 7.50 美元。
这不是说谁藏拙,两家披露习惯不同。值得记下的是反差本身:一场以「能力可验证」为主题的发布会,自家新模型的能力披露落在可验证性最低的一档。要在词元所上被评级,文心也得接受同一套测评——规则制定者把自己放上秤,这杆秤才可能被别人接受。
采购方现在能做的四件事
① 把验真写进验收条款。不只要 API 可通,还要供应商提供指纹核验记录与模型版本号,并在合同里约定版本变更提前告知。这一条对静默漂移是唯一有效的前置手段。
② 自己攒一组固定探针。50 至 100 条覆盖自身业务的题,每月跑一次,记录准确率与延迟标准差。论文里延迟标准差超过官方 2 倍是掉包的强信号,比看任何榜单都直接。
③ 不要按单价排序。先按能力达标筛,再在达标集合里比价。价格与准确率无相关,先比价等于先放弃质量维度。
④ 把信用分的变动当事件,而不是把分数当指标。评级下调意味着兑现度变了,而静默漂移只在这个维度上可见。
词元所真正做的事,是把「Token 是不是真货」从售后纠纷变成准入条件。7000 亿一天的体量说明柜台前已经有人排队。
但交易所成立的前提是规则能被复算:指纹方法准确率 96% 而非 100%,抽检是抽样而非全量,信用分由平台算而非第三方算。这三件事决定了它现在是一个有准入的聚合平台,还不是一个可审计的交易所。
对采购方而言,结论反而简单:平台给的字段用来缩小候选集,验收标准必须自己定。把验真写进合同、把探针握在手里,比相信任何评级都可靠。
站内可对照的背景材料:单价口径见 11 月大模型 API 价格表,同一天谷歌的定价窗口见 Gemini 4 Hydrogen 的迁移成本,供给侧的资本开支结构见 Nebius 第三季度拆解。
登录后可点赞、收藏与反馈。