AI 生成内容标识怎么加:三段链、七个字段与三个丢标动作
11 月网信办通报里,一家 AI 小程序因显式标识、元数据隐式标识、导出标识三处缺失被责令下线。这篇拆开三段义务,给出 AIGC 元数据的七个字段、27 位服务编码,以及三个最容易丢标的动作。
11 月,国家网信办通报的十起执法典型案例里,第九起是一家微信小程序:提供 AI 文本对话和图片生成,被责令下线。
通报列了四个问题,前三个都跟标识有关:
未对人工智能生成合成内容添加显式标识,未在文件元数据中添加包含属性信息、服务提供者名称或者编码、内容编号等制作要素信息的隐式标识,未在提供导出功能时对生成合成内容添加显式标识。
第四个是没做安全评估。对以 AI 功能为核心的小程序来说,下线接近业务终止。
这篇不讲原则,讲怎么落地:三段链分别做什么、文件里写哪几个字段、哪些动作会把标弄丢,以及三个最容易踩的坑。
一、三个后果:下线、误判、下架
第九起案件的原文很短,但每句话都能对上产品功能:小程序里有 AI 文本对话、图片生成,用户能导出。执法部门查的也正是这三处——界面上的显式标识、文件元数据里的隐式标识、导出环节的显式标识。三处都没有,加上没做安全评估,直接责令下线。
这里有个容易误读的点:下线不是罚款的加重版,而是另一种处置。罚款之后业务还在,下线之后小程序就没了入口。对靠 AI 功能获客的团队,后者的损失更直接。
第十起是另一类:两家网站以"API中转站"方式调用多个大模型接口,对外提供对话、问答,没做安全评估,被责令改正、处理责任人、警告。通报引用的法规是《生成式人工智能服务管理暂行办法》。这说明一件事:只要对外提供生成式 AI 服务,安全评估义务就落在你身上。标识义务的判定逻辑相同——看你是不是对外提供服务,不看模型是谁训练的。"我只调用上游接口"不构成豁免。
同一个月还有一条反方向的信号。11 月 10 日,北京互联网法院发布典型案例:平台用自研算法加人工复核,认定用户唐某发布的原创文字"缺乏明显人类情感特征",属于未标识的 AI 生成内容,隐藏了内容并禁言一天。用户申诉失败后起诉。
法院的认定很关键:
平台有权依据合同约定对涉案内容是否属于AI生成合成内容进行审查和处理,但审查及处理结果应有合理依据。
算法工具和运算过程由平台掌控,平台应就判断依据作合理举证或解释说明。平台只以"技术秘密"为由拒绝解释,最终被判违约,要恢复内容、删除违规记录。
这条对创作者的意义不是"以后可以随便发",而是:误判真实存在,申诉时你要拿得出创作过程。底稿、版本记录、生成日志、时间戳,都比一句"这是我自己写的"有用。上线前的其他自查项,可以对照AI 写的 App 能直接上线吗一起过。
11 月 12 日晚,一部以 87 版《红楼梦》为素材的 AI 短剧下架。媒体报道提到 17 位演员的肖像被合成,制作方全程没有标注"AI生成";广电总局近期也把"盗脸""偷声"列为微短剧治理重点。
这个案例要单独说,因为它提醒一件事:标识解决"知情",不解决"授权"。加一行"AI生成",不会让未授权的换脸变得合法;反过来,拿到授权也不等于可以不打标。两件事要分别做。
把这几件事放在一起,标识的义务边界就清楚了:它不是一个开关,而是一条从生成到传播的链。
二、三段链:显式、隐式、导出
《人工智能生成合成内容标识办法》把标识分成两类:显式标识,用户能看见;隐式标识,写在文件数据里。真正落地时,要拆成三段。
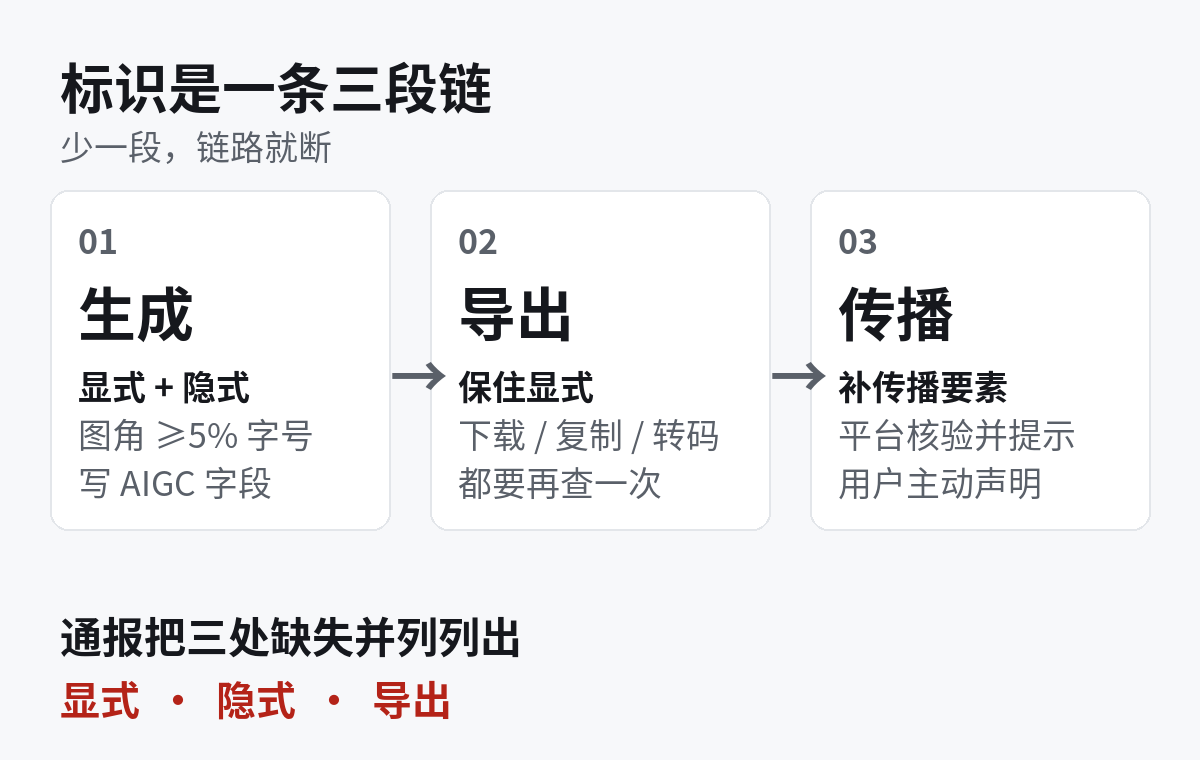
第一段,生成时,两处都要写。
显式标识是给用户看的,硬指标写在 GB 45438-2025 里,不是"加一行小字"那么简单:
| 形态 | 硬指标 |
|---|---|
| 文本 | 同时含"人工智能"或"AI"与"生成/合成";角标形式必须含"AI" |
| 图片 | 位于边或角;文字高度不低于最短边的 5%(1200×800 的图就是 40px) |
| 视频 | 起始画面边或角;同样不低于 5%;正常速度下持续不少于 2 秒 |
| 音频 | 语音标识用正常语速(约 120–160 字/分钟),或"短长短短"节奏(AI 的摩斯码) |
| 虚拟场景/界面 | 起始画面边角,或界面顶部、底部持续显示 |
注意图片和视频的 5%。一条 1080×1920 的竖屏视频,最短边是 1080,文字高度要到 54px;4K 横屏 3840×2160,最短边 2160,要到 108px。很多模板把标识做成 24px 小字放在角落"意思一下",按这个标准是不达标的。
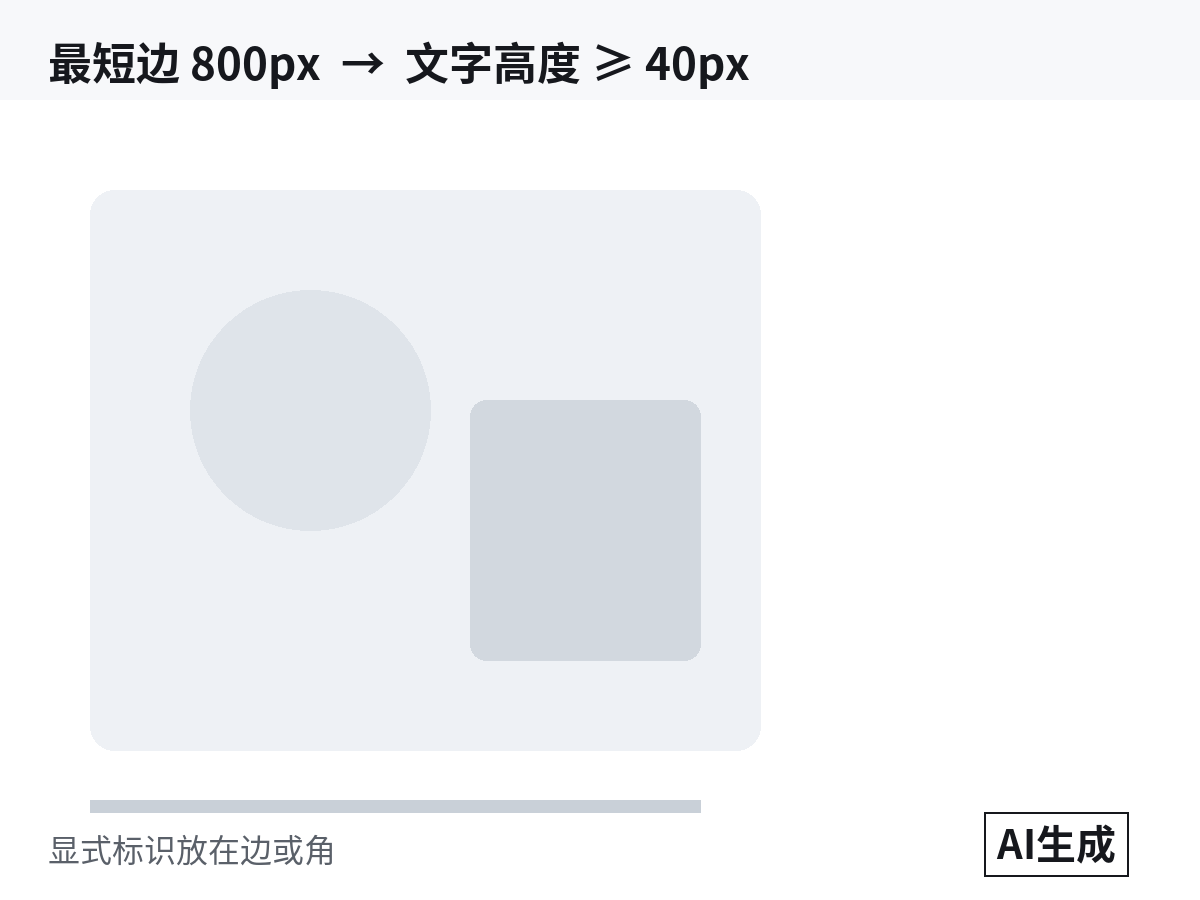
隐式标识是给平台和监管看的,写在文件元数据里,字段格式在下一节。它的作用是让平台在不看图的情况下知道"这是 AI 生成的",从而决定加哪种提示。
第二段,导出时,文件里必须带显式标识。
《标识办法》第四条最后一款写得很直接:
服务提供者提供生成合成内容下载、复制、导出等功能时,应当确保文件中含有满足要求的显式标识。
这一条是最容易漏的。产品里常见的做法是:生成页面上挂一个"AI生成"角标,用户点"保存到相册",导出的却是一张干净图。界面上的标是给当前页面看的,文件里的标才是跟着内容走的。执法通报把"未在提供导出功能时对生成合成内容添加显式标识"单独列出来,说明它不是界面问题的附属项。
第三段,传播时,平台核验并补要素。
《标识办法》第六条要求传播平台按核验结果分三种情形处理,并在元数据里补传播要素。三种情形对应 Label 的三个值:
- 元数据明确标明是生成合成内容,提示"属于";
- 没核验到,但用户声明了,提示"可能为";
- 没核验到、用户也没声明,但检测到显式标识或其他痕迹,提示"疑似"。
用户侧还有一条:第十条规定,发布生成合成内容应当主动声明;任何组织和个人不得恶意删除、篡改、伪造、隐匿标识。
三段连起来看,责任就清楚了:生成方管前两段,平台管第三段,用户管声明。任何一段空着,链子就断在那里。
三、文件里写什么:五个必要要素、两个预留字段
GB 45438-2025 附录 E 规定,元数据扩展字段的名称或关键词里必须含"AIGC",值是下面这个 JSON 字符串。这套生成合成标识的字段看着像给监管看的,实际对平台核验同样有用——平台先读字段,再决定加哪种提示。字段长这样:
{
  "Label": "1",
  "ContentProducer": "001191510100MA6DEMX01K10001",
  "ProduceID": "8f3c2a1e6b7d4c90a1f23d5e6b7c8a90",
  "ReservedCode1": "",
  "ContentPropagator": "001191510100MA6DEMX01K10001",
  "PropagateID": "8f3c2a1e6b7d4c90a1f23d5e6b7c8a90",
  "ReservedCode2": ""
}
七个字段,前五个是必要要素:
| 字段 | 含义与写法 |
|---|---|
| Label | 生成合成标签,只能是 1、2、3:1=属于,2=可能为,3=疑似 |
| ContentProducer | 生成合成服务提供者的名称或编码 |
| ProduceID | 生成方对这条内容的唯一编号,按 32 字符以内控制 |
| ContentPropagator | 传播方名称或编码;首次写入时与 ContentProducer 一致 |
| PropagateID | 传播方编号;首次写入时与 ProduceID 一致 |
| ReservedCode1 | 预留字段,可放生成方的完整性保护信息 |
| ReservedCode2 | 预留字段,可放传播方的完整性保护信息 |
两个细节,很多实现会写错。
第一,首次写入时,传播两项要复制制作两项。标准附录 E 的注 1 说得很明确:生成方第一次写元数据时,ContentPropagator 等于 ContentProducer,PropagateID 等于 ProduceID。不是留空等平台来填。留空的文件,平台核验时看到的是"五项里少两项",严格一点的校验会直接判不合格。
第二,ProduceID 有长度上限,UUID 刚好超。标准 UUID 带四个连字符是 36 位,去掉连字符正好 32 位。我第一版直接把 UUID 填进去,脚本报了 LONG_ProduceID。这不是格式洁癖——字段超长,校验严的平台会直接拒收;就算收下,截断后的编号也追不回原文了。
ContentProducer 可以填名称,也可以填编码。如果填编码,27 位按位段拆是:00(格式版本)+ 1(主体类型)+ 1(绑定方式)+ 18 位统一社会信用代码 + 1(服务类型)+ 0001(序号)。
- 第 1–2 位:格式定义码,当前固定
00; - 第 3 位:主体类型,
1组织,2个人; - 第 4 位:绑定方式,
1统一社会信用代码,2身份证号等; - 第 5–22 位:18 位主体代码;
- 第 23 位:服务类型,
1生成合成服务,2内容传播服务; - 第 24–27 位:4 位自定义序号。
上面那串拼出来是 001191510100MA6DEMX01K10001,正好 27 位。按这个规则拼一遍,不用手数位。
字段写在文件里的哪个位置,标准给了分格式的落点:JPEG 写 APP1 的 XMP,PNG 写 iTXt 的 XMP 字段,WebP 写 XMP 块,MP4 用 -metadata AIGC=...。但实际接工具时,你会遇到第二个落点:EXIF 的 UserComment。
我测试时构造了两类文件:一类把 JSON 写进 XMP,一类写进 EXIF UserComment。只读 XMP 的脚本,在第二类文件上会报"没有标识",但用看图工具打开属性,字段明明在那里。所以检查逻辑要两处都读;写入时按目标平台的要求选一处,拿不准就两处都写。
还有一个容易混淆的概念:C2PA。它是国际上的内容来源标准,记录"谁生成、用什么工具、做过哪些编辑",靠证书链验证。中国的 AIGC 字段记录的是"Label + 服务提供者 + 编号",两者目的不同,字段体系也不一样。
Koncile 11 月 8 日发布的抽查覆盖 37 个模型、428 个文件,结论是:C2PA 的覆盖率参差不齐,有的签名证书不在信任列表,有的清单格式不合法,有的干脆没有;能公开验证的接口,当时只有 OpenAI 一家可用,且限制在每小时约 20 次。所以,生成器给你的 C2PA 清单,不能当作中国的 AIGC 标识;反过来,写了 AIGC 字段,也不等于 C2PA 验证能过。做合规检查时,认字段,不认 logo。元数据只是验证的一层,真伪判断还要回到像素和来源,这一点在图片真伪检测里拆过。
平台代写也不等于代你合规。火山引擎的文档写得很清楚:它可以帮助写入 Label、ContentProducer、ContentPropagator,但 ProduceID 和 PropagateID 属于"生成方对资源的映射",平台无法代写,必须由生成方自己传。也就是说,调完 API 之后,你还得检查这两项到底有没有值。
四、怎么查、怎么补:四种格式与三个丢标动作
我用一个零依赖的脚本跑了下面几组对照,它只读写文件头,不做模型调用。图像生成、视频生成这类功能,导出链路比纯文本长得多,更需要一个能反复跑的检查动作。不想装脚本,也可以先用 exiftool 看字段在不在:exiftool -a -G1 -UserComment -XMP:all demo.jpg。
先看一个典型的不合格样本。生成方只写了前三个字段,传播两项留空:
$ python aigc_label.py check demo_three.jpg
{
  "format": "jpeg",
  "has_aigc": true,
  "fields": {
    "Label": "1",
    "ContentProducer": "001191510100MA6DEMX01K10001",
    "ProduceID": "8f3c2a1e6b7d4c90a1f23d5e6b7c8a90",
    "ContentPropagator": "",
    "PropagateID": ""
  },
  "issues": [
    {"level": "warn", "code": "MISSING_ContentPropagator", "message": "ContentPropagator 为空或缺失"},
    {"level": "warn", "code": "MISSING_PropagateID", "message": "PropagateID 为空或缺失"}
  ],
  "verdict": "warn"
}
加 --strict,这两项会从 warn 变成 error,退出码非零,可以直接挂到发布流水线里当闸门。
补写就是把上面那段 JSON 写进文件头;我用脚本包了一层,一条命令:
$ python aigc_label.py write cover.jpg \
    --producer 001191510100MA6DEMX01K10001 \
    --produce-id 8f3c2a1e6b7d4c90a1f23d5e6b7c8a90 \
--out cover.labeled.jpg再查一次,verdict 变成 pass。文件只大了 622 字节;PNG 是 550 字节,MP4 是 404 字节。一条标识的成本,比一张缩略图还小。
四种格式的落点:
| 格式 | 写在哪里 |
|---|---|
| JPEG | APP1 的 XMP;或 EXIF UserComment |
| PNG | iTXt 的 XMP 字段;或 eXIf 块 |
| WebP | XMP 块;或 EXIF 块 |
| MP4 | -metadata AIGC='...' -movflags use_metadata_tags |
MP4 这条命令有个必须带的参数。我用 ffmpeg 写进去之后,做了一次普通的流拷贝:
# 会丢标:只做流拷贝,没有声明使用自定义 metadata
ffmpeg -i labeled.mp4 -c copy out.mp4

# 保住:显式要求把自定义 key 写进 udta
ffmpeg -i labeled.mp4 -c copy -movflags use_metadata_tags out.mp4
实测结果:不带 -movflags 的拷贝,check 报 NO_AIGC;带上之后,五个字段都在。转码链路里少一个参数,标就没了,而且画质、时长、文件名都看不出异常。
把几个常见动作跑一遍,结果是这样:
| 动作 | 检查结果 |
|---|---|
| 原图直接查 | fail,没有 AIGC 字段 |
| 用脚本写入后查 | pass,五项齐全 |
| 用 Pillow 重存一次 | fail,XMP 和 EXIF 都没了 |
| 改一个像素再高质量重存 | fail,同样丢 |
-c copy 不带 -movflags | fail,AIGC 标签丢失 |
带 -movflags 拷贝 | pass |
这张表说明一件事:标识不是写一次就一劳永逸,它会在每个"再保存一次"的环节被剥掉。截图、另存、聊天工具转发压缩、视频转码、平台二次上传,都可能成为剥标点。Adobe 的研究人员在内容真实性倡议的博客里也提过,社交媒体和内容平台移除元数据仍然很常见。
所以工程上要分两层:
- 显式标识烧进像素。它会被压缩、被截图、被转码,但只要人眼能看到,就还在。
- 隐式标识当作可丢失的元数据。每次导出、转码、上传后都重新写一遍,不要假设它会跟着文件走。
数字水印可以作为补充,但《标识办法》只是鼓励采用,GB 45438-2025 也把内容隐式标识列为非强制项;它不能替代显式标识。真正兜底的,还是画面里那行字。电商图从生成到上架的那条链路,在一张产品照出三视图里有更细的步骤。
发布前,按这六条过一遍:
- 图片、视频的边或角有"AI生成"(或含"人工智能/生成"的等价表述),字号不低于最短边的 5%,视频首帧停不少于 2 秒。
- 文件里有 AIGC 字段,Label、ContentProducer、ProduceID、ContentPropagator、PropagateID 五项齐全,Label 选对。
- 走过一遍真实的导出、转码链路,再查一次,不要只查工程文件。
- 在平台发布时勾选"AI生成"声明;用户侧不声明,平台也会按检测结果加"疑似"提示。
- 保留工程文件、提示词、生成记录和时间戳。遇到误判,这些是申诉材料。
- 涉及真人肖像、声音、作品的,先拿授权。标识不能替代授权,授权也不能替代标识。
对做企业AI产品的团队来说,标识不是一次性的合规动作,而是导出链路的一部分。标识这件事,技术上只有几百字节,难的是把它放进每一条导出链路里。先查一遍现有文件,再决定是补写、改导出逻辑,还是两者都做。
登录后可点赞、收藏与反馈。