搜索按次计费只活了 18 天:DeepSeek 联网工具怎么接、边界在哪
DeepSeek 11 月 18 日起取消模型触发场景的搜索、抓取按次计费,5 元/千次的规则只执行了 18 天。本文讲清三条接入路径、新旧成本结构对比,以及独立 Search/Fetch API 仍收费、多轮要回传 server_tool_calls 等四个边界,帮中小团队决定联网能力怎么接。
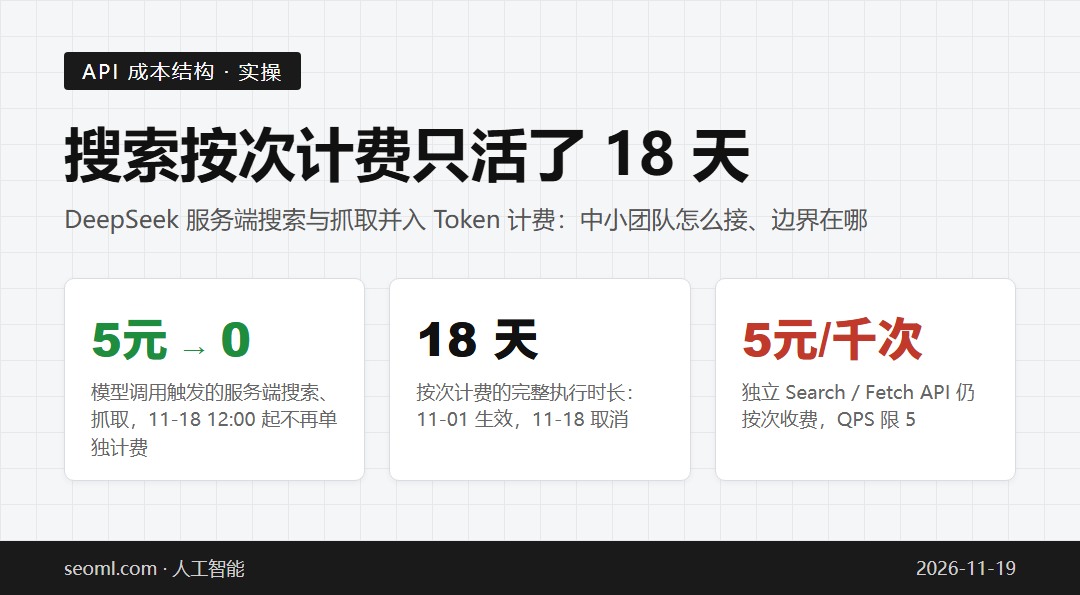
自北京时间 2026 年 11 月 18 日 12:00 起,DeepSeek API 调用模型时由服务端触发的联网搜索与网页抓取不再单独计费,账单只按模型 Token 用量结算。此前「每 1000 次成功请求 5 元」的按次计费,10 月 17 日随 V4.1-Flash-1017 上线、11 月 1 日正式执行,只运行了 18 天就被取消。边界要说清:独立的 Search / Fetch 接口不受影响,仍按 5 元 / 千次成功请求收费——免费的只是模型调用链路里自动触发的那部分。
对做 Chatbot、客服机器人和轻量 RAG 的中小团队来说,这次调整把「接联网能力」的固定开销直接清零:不用再按次买第三方搜索 API,也不用自己维护爬虫。下面按官方文档口径讲三条接入路径、成本怎么算,以及四个容易踩的坑。
18 天里的三次变化
这次取消的不是「搜索能力」,而是它的一个计费口径。时间线如下:
| 时间 | 变化 | 说明 |
|---|---|---|
| 2026-10-17 | Search / Fetch API 随 V4.1-Flash-1017 上线 | 基于 DeepSeek 自研搜索引擎,定价 5 元 / 千次成功请求 |
| 2026-11-01 00:00 | 服务端工具调用正式按次收费 | DeepSeek Harness、Claude Code、Codex 内的过渡期结束 |
| 2026-11-18 12:00 | 模型触发场景取消按次计费 | 并入 Token 结算;独立 Search / Fetch API 定价不变 |
触发场景覆盖三条协议路径:联网工具、Anthropic API 的 web_search 工具、Responses API 的 web_search 工具。也就是说,只要搜索和抓取发生在模型调用的服务端链路里,账单上就不再单独列项。官方文档当前的计费口径与公告一致:服务端工具(文字搜索、图片搜索、网页抓取)不计费,只有模型 Token 用量计费。
三条接入路径:都在 tools 里声明
联网能力由两个服务端工具提供:deepseek_web_search(联网搜索与深度思考搜索)和 deepseek_read_url(阅读链接)。是否联网由模型判断,搜索和抓取都在服务端完成,客户端不需要执行任何工具。官方要求使用 deepseek-flash 模型,三种协议都能声明:
| 路径 | 声明方式 | 适合谁 |
|---|---|---|
| Anthropic 兼容 Messages API | tools 里声明两个工具,header 用 x-api-key | 已有 Anthropic SDK 代码、Claude Code 用户,改动最小 |
| Chat Completions API | tools 里声明,safety_check、title 放顶层 | OpenAI SDK 用户;注意不要传 web_search_options,会返回 400 |
| Responses API | tools 里声明,safety_check 放顶层 | 用 Responses 协议的 Agent 框架 |
以 Anthropic 兼容的 Messages API 为例,官方文档的请求格式如下:
curl https://api.deepseek.com/anthropic/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "tools": [
      {"type": "deepseek_web_search", "name": "deepseek_web_search"},
      {"type": "deepseek_read_url", "name": "deepseek_read_url"}
    ],
    "messages": [{"role": "user", "content": "今天 AI 行业有什么新发布?"}]
}'同一个工具,开不开思考是两种工作模式:关闭思考时是普通联网搜索,模型按需发起搜索并附引用作答,与网页端体验一致;开启思考(thinking 设为 enabled)时进入深度思考搜索,模型在多步推理里自主搜索、打开网页、页内查找(search / open_page / find_in_page),最多调用约 20 次工具后作答。研究类问题用后者,响应慢但求证更充分。
两个工具的声明不能通过 tool_choice 强制指定,写了会返回 400;tool_choice 设为 none 则关闭全部工具。
成本怎么算:省的是固定开销,Token 会涨
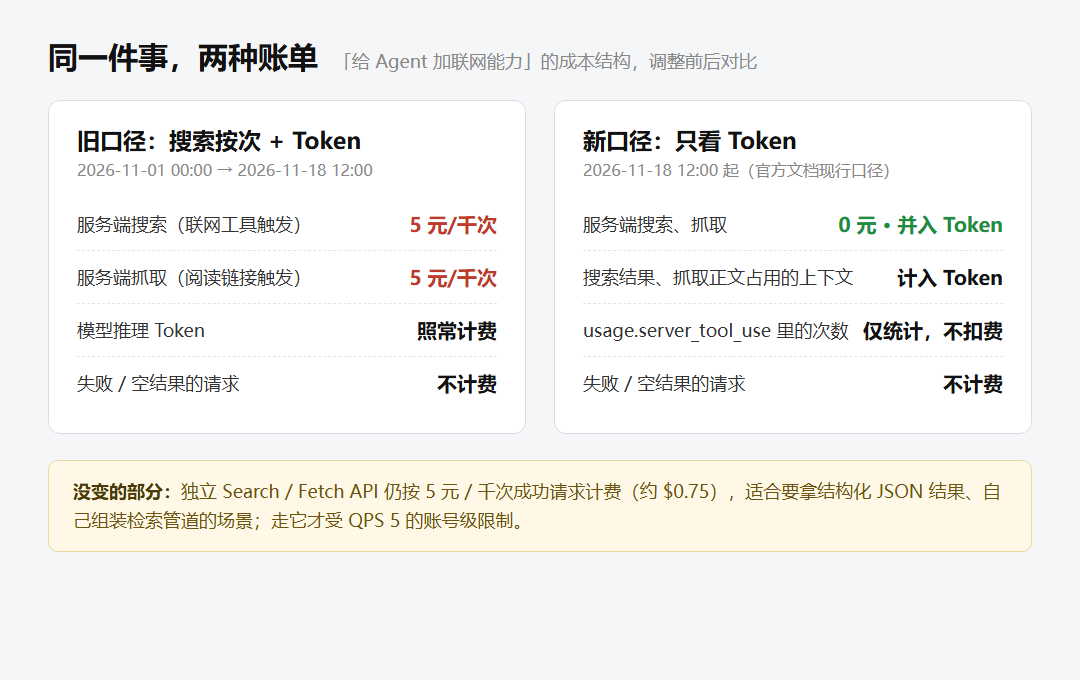
按官方单价推算:一次调用若触发 1 次搜索加 1 次抓取,旧口径的固定检索开销是 0.01 元 / 次,千次调用约 10 元;新口径这部分为 0。对每天跑上万次联网调用的应用,省的是真金白银的固定成本。
但账不是单边下降的。搜索结果和抓取的正文会拼进上下文,Token 用量会涨。深度思考搜索一轮最多约 20 次工具调用,每次打开网页的内容都参与推理,输出 Token 和思考 Token(output_tokens_details.thinking_tokens)都会明显增加。省掉的按次费用,有一部分会以 Token 的形式回来。计费验证看响应里的 usage.server_tool_use:现在 tool_search、tool_fetch、tool_image_search 三个字段只统计次数、不扣费,三者全为 0 时整个字段不返回。
另外,失败请求的口径没变:搜索无结果、抓取失败不计费(这条原本是按次计费的豁免规则,现在场景里天然没有按次费用可免)。
四个容易踩的坑
- 独立 Search / Fetch API 仍收费,别混着算:要拿结构化 JSON 结果、自己组装检索管道的,仍要走独立接口,5 元 / 千次成功请求,且受账号级 QPS 5 限制(Search 与 Fetch 各自独立限流,互不占用)。免费的是「模型触发」,不是「搜索本身」。
- 多轮对话必须原样回传
server_tool_calls:阅读链接拿到的网页正文不直接返回,而是加密放在signature里,下一轮要靠它拼回上下文。框架或网关把这个字段丢了,请求不会报错,但之前读过的网页会静默消失——这是官方文档明确点名的集成故障点。Chat Completions 和 Responses 协议同理,回传时保留kind和signature。 - 用过联网工具的回复不能续写:带
prefix的继续生成会返回 400,只能重发上一次请求。做流式补全或「接着刚才说」的功能时要把这个限制设计进去。 - 阅读链接只看最后一条用户消息:最多识别前 10 个不同 URL,重复算一个;同一轮读多个链接时单个网页可用长度变短,长页会被截断。对外提供服务的应用记得开
safety_check,未通过审核的网页返回url_not_allowed错误。
该不该接:结论与边界
适合接的场景:给 Chatbot、客服机器人、问答助手加联网能力,或者轻量 RAG 里需要实时网页补充——这些场景本来就不关心搜索结果的原始结构,只要模型答得对,现在固定开销为零,接的动机比调整前充分得多。
不该指望它的场景:要把检索结果当数据用的管道——自己的 rerank、域名白名单、按站点过滤、结构化字段抽取。这些控制粒度「模型触发」的隐式搜索给不了,官方文档也明确说这类需求用独立 Search / Fetch API 自己编排。两条路径的价格差(0 与 5 元 / 千次)正好把适用场景分开了:让模型搜,免费;让程序搜,照旧付钱。
定价最近变动频繁(18 天内两次调整),接入前建议先看官网价格页核对当前口径。站内相关的两篇可以对照着看:《DeepSeek 上线额度管理:C 端用户或将面临限额》讲的是同一时期的限流动作,《同一个 DeepSeek 模型 50 个 API 端点:34 倍价差怎么选》讲端点选择。接入后如果 Token 涨得超过预期,排查思路见《Token 消耗太快怎么查:两个放大器与四步止血》。
登录后可点赞、收藏与反馈。