跑模型时 GPU 占用 0%:三处回退路径的定位方法
显存不够导致层回退 CPU、后端没编进二进制、进程把活派给了核显——三类「跑了但没用上卡」的日志特征与判定顺序,含 llama.cpp 日志怎么读、-lv 4 怎么开、Ollama 与 ComfyUI 各自的设备开关。
显卡风扇没动静,任务管理器里那条曲线贴着 0,token 却一个接一个往外蹦——速度慢得像纯 CPU,但机器上确实插着 Arc。这种「跑了但没用上」的情况,比「完全找不到 GPU」更常见,也更难查,因为程序不会报错。
原因只有三类:模型的大部分层根本没上卡、程序编译时就没带 GPU 后端、进程把活派给了另一块适配器。三者的日志特征不同,判定方法也不同。下面按这个顺序拆,每一步都给可对照的输出。
先确认这个 0% 是不是真的
Windows 任务管理器把 GPU 拆成 3D、Copy、Video Decode、Video Encode、Compute 几个引擎,性能页默认展示的是 3D。推理走的是 Compute,3D 那条线本来就可以是 0。看之前先把图表切到对应引擎,或者直接在「进程」页加上「GPU 引擎」列,看是哪个进程、哪个引擎在动。
更可靠的判断不看百分比,看三件事:显存占用有没有上去、核心频率有没有从待机抬起来、功耗有没有变化。这三项都不动,才是真的没算;只有百分比是 0 而显存和功耗都在涨,那是显示问题。
Linux 上 intel_gpu_top 能直接看到引擎占用和显存带宽。Intel 的 XPU Manager 提供的 xpu-smi stats 也能按设备采样,跨平台一点。
还有一种情况是 0% 本身没错。token 生成阶段每次只算一个 token,kernel 又短又碎,采样窗口里抓到的占用本来就不高;prompt 处理阶段才会把 GPU 打满。所以别只看生成时的数字,先发一个长 prompt 看 prefill 那几秒。prefill 也上不去,才是真问题。
Windows 上还有一层系统级的选择。设置里的「系统 → 显示 → 显卡」可以按 exe 指定「高性能」或「省电」,笔记本默认可能把 Python 进程判给核显。这一层在程序内部的所有选择器之前生效,程序里怎么设都没用。
路径一:层没上卡
llama.cpp 在加载阶段会把每类缓冲区的大小打出来,这几行是判断依据:
load_tensors: offloading output layer to GPU
load_tensors: offloading 32 repeating layers to GPU
load_tensors: offloaded 33/33 layers to GPU
load_tensors:        CPU model buffer size =   512.00 MiB
load_tensors:      SYCL0 model buffer size =  7412.50 MiB
offloaded 33/33 是分子分母都上了卡;如果是 offloaded 8/33,说明只有 8 层在 GPU 上,剩下 25 层在 CPU 上算,这时候 GPU 占用低是正常的,瓶颈是 PCIe 往返。再看下面几行缓冲区:CPU 或 CPU_Mapped 那行如果有几个 GiB,就是权重留在内存里的直接证据。
日志默认只打 INFO 级里的一部分,想看全就把等级调高。llama.cpp 的参数是 -lv 4。
SYCL 后端文档在讲 SYCL Graph 时明确提到了这个用法:打开 INFO 级日志,再去找 enabling SYCL graphs 这类行。层卸载相关的行本来就在 INFO 级里,但模型加载时有大量 DEBUG 信息被压掉了,排查内存问题时值得开一次。ComfyUI 侧对应的是 --verbose LEVEL,写 --verbose DEBUG 会把节点执行和显存回收都打出来。
-ngl 99 只是「尽量多」,能不能真上去由显存决定。常见触发条件有两个:模型本身超过显存,以及上下文开得太大——KV cache 跟着 -c 线性增长,-c 32768 在 12GB 卡上很容易把余量吃光。SYCL 后端文档给的处理办法是把上下文降到 8192 或更小,或者换更低的量化档。
如果非要用长上下文,可以把 KV cache 本身量化掉:-ctk q8_0 -ctv q8_0。llama.cpp 的 SYCL 文档在讲 MKL flash attention 时给的示例命令就是这个组合,配合 -fa 和 --batch-size 1024。代价是精度略降,收益是同样的显存能放下更长的上下文,从而让更多层留在卡上。
还有一个硬件侧的变量:Resizable BAR。Arc Pro 驱动的 release notes 在开头就写了「建议在系统里开启 Resizable BAR 以获得最佳性能」。不开它,CPU 一次能映射的显存窗口很小,权重上传和页表切换都会变慢,表现是 GPU 占用上不去、加载时间异常长。这一条在 BIOS 里改,不在驱动里改。
Arc B 系列还有一个隐蔽得多的情形。llama.cpp 的 SYCL 文档记录了一个默认开启的开关 GGML_SYCL_BMG_VRAM_CHECK=1,作用是拦截「模型放不下却仍然分配成功」的请求。
之所以要拦,是因为 B 系列上 Level Zero 驱动会接受超过显存的分配,把溢出的部分挪到系统内存(对应 compute-runtime 的 issue #1047)。
表现出来就是:进程不报错,系统内存一路涨到接近耗尽,GPU 占用极低,速度掉到内存带宽的水平。这种情况把开关设成 0 只会让它更糟,正确做法是减小模型或上下文。
ComfyUI 侧的对应现象是另一套日志。启动时它会打印 Set vram state to: NORMAL_VRAM 和 Device: xpu:0 Intel(R) Arc(TM) ...,显存不够时状态会变成低显存模式,UNet 分块执行。这时候 GPU 占用是脉冲式的,中间夹着大量等待,看起来像「没在用」。
| 现象 | 日志关键词 | 判定 | 处理 |
|---|---|---|---|
| 出 token 但极慢,GPU 曲线平 | offloaded 8/33 layers | 层回退 CPU | 降 -c、降量化、或换更小的模型 |
| 系统内存爆满,不报错 | B 系列 + 无 OOM 报错 | 显存溢出到内存 | 减小模型/上下文,别关 BMG_VRAM_CHECK |
| 直接报分配失败 | can't allocate ... Bytes of memory on device | 显存真不够 | 同上,或加卡分层 |
| 出图慢且显存没满 | Set vram state to: LOW_VRAM | ComfyUI 主动分块 | 降分辨率/批量,或换更省显存的精度 |
把三条拼起来看一个常见组合:日志写 offloaded 21/41 layers,显存接近占满,系统内存一路上涨,GPU 占用只有个位数。
四条信息分别对应:层只上了一半、显存快满、溢出到了内存、计算在等数据。结论不是「显卡不行」,是模型对这个显存档位偏大,降一档量化或者把上下文压小就能多上几层。
路径二:后端没编进去
第二类是「程序从头到尾就不知道有 GPU」。判断只需一条命令:
llama-server --list-devices正常输出会像这样,每块卡一行,带可用显存:
Available devices:
  SYCL0: Intel(R) Arc(TM) A770 Graphics (15473 MiB, 15473 MiB free)
  SYCL1: Intel(R) UHD Graphics 770 (59675 MiB, 44986 MiB free)
看到设备列表时别被显存数字骗了。列表里核显那行经常显示几十 GB「可用」,那是和系统内存共享的额度,不是独享显存;真正能稳定留给推理的远小于这个数。同一台机器上独显显示 12GB、核显显示 59GB,选大的那块反而更慢,原因就在这里。
如果这里只有 CPU,说明这个二进制没编 SYCL 或 Vulkan。预编译包的名字里带 sycl 或 vulkan,不带后缀的就是 CPU 版。llama.cpp 每个日常构建都会出 llama-b####-bin-win-sycl-x64.zip 和对应的 Vulkan 包,2026 年 11 月 18 日的构建号是 b12498,选错包的代价就是全程 CPU。
自己编译的话,-DGGML_SYCL=ON 和 Vulkan 的 -DGGML_VULKAN=ON 是必须显式打开的,默认不开。还有一个已经生效的限制:从 2026 年 2 月起,llama.cpp 的 SYCL 后端只支持 Intel 设备,NVIDIA 和 AMD 的 oneAPI 插件渠道已经不可用,相关构建被移除了。所以「用 SYCL 跑 A 卡或 N 卡」这条路现在是走不通的,不是配置问题。
PyTorch 生态里的对应症状更直白。ComfyUI 官方排障文档写的是:Intel GPU 上出现 Torch not compiled with CUDA enabled,意思是 XPU 后端不可用,ComfyUI 退而去试 CUDA。这条报错跟 CUDA 一点关系都没有,按 CUDA 的方案重装只会更乱。
确认方法是一行:
python -c "import torch; print(torch.__version__, torch.xpu.is_available())"版本号里带 +xpu 才是 XPU 构建。装成 +cpu 或 +cu### 都会让 is_available() 返回 False,而 ComfyUI 不会阻止你继续跑,它只是安静地用 CPU。
路径三:卡选错了
第三类最气人:程序确实在用 GPU,只是用了不该用的那块。核显和独显同在的机器上,枚举顺序决定了索引 0 指向谁。
SYCL 后端的选择逻辑是「同后端、最大计算单元数最高」的那批设备,所以独显通常排在前面。llama-ls-sycl-device 的表格里能看到 Max compute units 一列,A770 是 512、UHD 770 是 32。
但这只在默认枚举下成立。一旦环境里存在 ONEAPI_DEVICE_SELECTOR,顺序就按选择器来,而且父 shell 设过的值会被子进程继承下来,export 完忘了清是常见事故。
torch.xpu.device_count() 比 is_available() 更能说明问题:返回 0 表示一块都没枚举到,属于路径二;返回 2 而速度不对,说明枚举到了但选错了,属于路径三。
固定到具体设备的写法:
# llama.cpp:单卡,指定 0 号
llama-server -m model.gguf -ngl 99 -sm none -mg 0

# 通过选择器限定,效果等价且对同进程内的其它库也生效
ONEAPI_DEVICE_SELECTOR="level_zero:0" llama-server -m model.gguf -ngl 99
# Windows
$env:ONEAPI_DEVICE_SELECTOR="level_zero:0"
.\llama-server.exe -m model.gguf -ngl 99 -sm none -mg 0Ollama 走的是 Vulkan,索引体系跟 SYCL 完全独立。Vulkan 从 Ollama 0.30 起默认开启,官方博客的说法是「把 GPU 加速扩展到包括 AMD 和 Intel 在内的更广硬件」,当前版本是 0.40.16(2026-11-09)。比 0.30 更早的版本根本没有这条 Intel 路径,装完发现只用 CPU 不是配置问题。
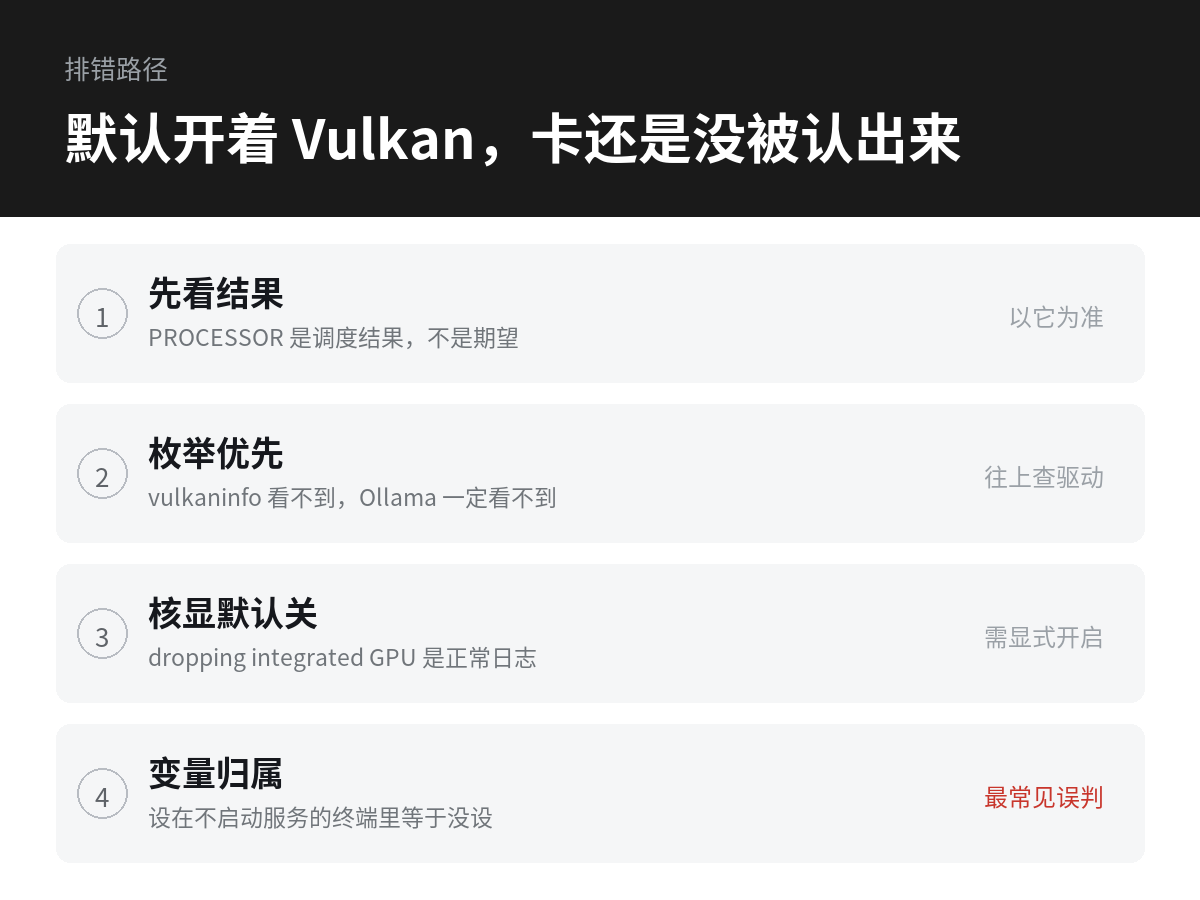
它的官方文档专门写了一句:在核显和独显混合的机器上,如果 Vulkan 核显不稳定,保留 Vulkan 但把 GGML_VK_VISIBLE_DEVICES 设成独显的索引;要整体关掉 Vulkan 就用 OLLAMA_VULKAN=0。这两个变量是 Ollama 这一层的主要开关,ONEAPI_DEVICE_SELECTOR 对它无效——它既不读 Level Zero,也不读 SYCL 的设备列表。
多卡时还有一个容易忽略的分配问题。--split-mode layer 是默认值,按层切分到各卡,切分比例默认按显存自动算。一旦某张卡被别的进程占了一部分,自动比例就会算歪,结果是一张卡吃满、另一张闲着,总体 GPU 占用看着只有一半。
--split-mode tensor 是另一种切法,它依赖 flash attention,把 --flash-attn 关掉会被直接拒绝;文档也写明张量并行目前只针对 2 卡优化过。
ComfyUI 有自己的入口。它的命令行里有一个 --oneapi-device-selector 参数,作用就是把 ONEAPI_DEVICE_SELECTOR 设进进程环境,省得你在启动脚本外面再包一层:
python main.py --oneapi-device-selector "level_zero:0"启动后看 Device: 那一行,出现 xpu:0 说明选中的就是 0 号。如果那行写着 xpu:1 而你以为只有一块卡,多半是核显被枚举成了 0 号。
三条路径的判定顺序
给一个不用猜的顺序,每一步都能落到具体结论:
- 看显存。显存占满、GPU 曲线低,走路径一;显存几乎不动,走路径二或三。
- 看设备列表。
llama-server --list-devices或 ComfyUI 启动日志里有没有 GPU;没有就是路径二。注意--device只能从选择器筛过之后的设备里挑,两个都设的时候以选择器为准。 - 看进程。任务管理器「进程」页按 GPU 排,或
xpu-smi stats,确认是哪个进程在哪块卡上有活动;活动在核显上就是路径三。 - 看选择器。
echo $ONEAPI_DEVICE_SELECTOR和echo $GGML_VK_VISIBLE_DEVICES,这两个变量是最常见的「昨天还好今天不对」的来源。
顺带说一个反直觉的点:SYCL 和 Vulkan 是两套独立的设备枚举与内存分配路径,失败模式也不同。SYCL 在 B 系列上会因为驱动接受超额分配而悄悄溢出到系统内存,Vulkan 这条路没有同样的记录。
所以「换后端试试」有时候不是玄学,是在换一套失败方式,代价是你要重新确认一遍日志。
还有一种情况是几个进程在抢同一张卡。Ollama 服务常驻会占住一部分显存,再起一个 llama-server,后者能上的层数就少了,表现为「同样的命令昨天能全上卡,今天只上了一半」。先 xpu-smi ps 看看有没有别的进程在跑,再判断是不是显存不够。
三处都排除之后还是 0%,换一个 0.6B 级别的小模型做对照。小模型能上卡说明是容量问题,小模型也上不去说明是环境问题,这时候再回头查驱动和运行时。
最后区分两个容易混的症状:占用 0% 且慢,是活没派给 GPU;占用 90% 且慢,是派过去了但算不动,后者通常跟量化格式、驱动版本或内存带宽有关。这两种情况的处理方向完全相反,先分类再动手。
显存到底够不够,可以先按本地跑大模型要多少显存那张表估一遍再动手,比反复试 -ngl 快。至于 Ollama 这边的服务和客户端关系,Ollama 是什么里讲得比较清楚,设备没选对时它的日志同样只会告诉你「用了 CPU」,不会告诉你为什么。
登录后可点赞、收藏与反馈。