Ollama 认不出 Intel 显卡:从驱动到 Vulkan 的七步排查
Ollama 0.30 起 Vulkan 默认启用,Intel 显卡仍可能被判成 100% CPU。按版本、驱动、vulkaninfo 枚举、日志、显存、环境变量作用域逐层排除,并给出 Windows 与 Linux 各自可复制的检查命令。
Ollama 从 0.30 起默认启用 Vulkan,但「默认启用」只说明二进制里有这个后端,不说明它认得出你那张卡。Arc 独显和 Core Ultra 核显只能走 Vulkan,没有 CUDA 或 ROCm 可以退,枚举失败时不会有任何弹窗,只有 ollama ps 里一行 100% CPU。
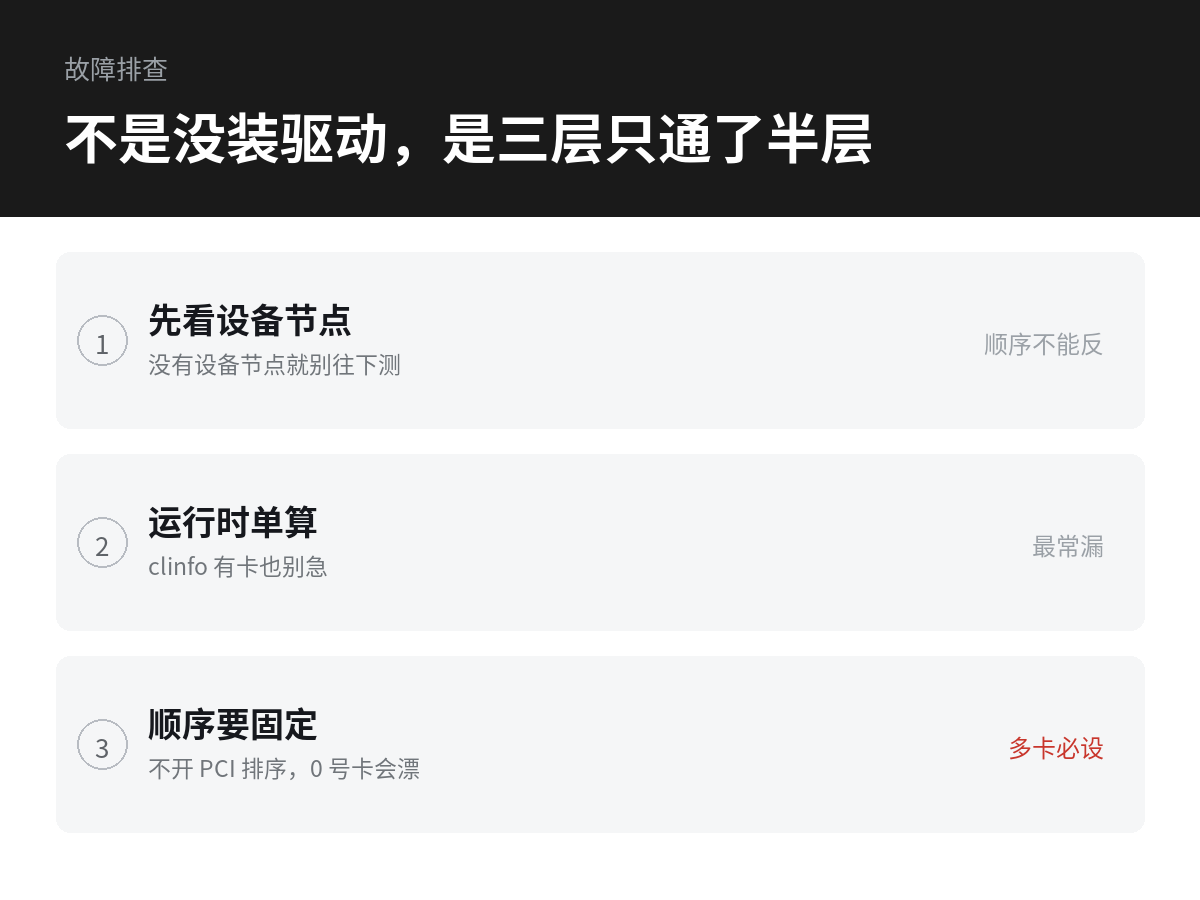
这篇按依赖顺序排七步:版本、驱动、Vulkan 枚举、Ollama 日志、显存、环境变量作用域。前一步没过,后一步的结论都不可信——驱动没装好就去调 OLLAMA_VULKAN,只会多花半小时。
判定入口只有一个:ollama ps 的 PROCESSOR 列。它显示的是调度结果,不是你的期望。
先看结果:PROCESSOR 三个取值的含义
模型加载后执行 ollama ps,PROCESSOR 只会出现三种形态。
100% GPU 表示整个模型连同 KV cache 都在显存里,这条路不用继续查。100% CPU 表示 Ollama 没有可用 GPU,或者显存放不下任何一层,问题在前六步里。中间形态如 48%/52% CPU/GPU 是部分卸载,说明设备认出来了,只是装不下,直接跳到第五步。
# 通用
ollama ps

# Windows 想看进程占用
Get-Process ollama* | Select-Object Name, WorkingSet64
注意 CONTEXT 列。Ollama 会按可用显存给一个默认上下文,日志里的 vram-based default context 就是这一行。如果 CONTEXT 只有 4096 而你要跑长文档,后面的溢出是上下文造成的,不是设备没认出来。
还有一个容易混淆的判据:模型能跑,但 ollama run --verbose 的 eval rate 只有个位数。这既可能是 CPU 推理,也可能是核显推理。核显的算力和内存带宽都接近 CPU,慢不代表没上 GPU,必须以 PROCESSOR 列为准。
为什么 Intel 在 Ollama 里只有 Vulkan 这一条路
Ollama 的后端是按厂商分库的:NVIDIA 走 CUDA,AMD 走 ROCm,Apple 走 Metal,剩下的统一走 Vulkan。Windows 安装目录下的 ggml-*.dll 就是这些后端,Vulkan 对应 ggml-vulkan.dll。Intel 没有单独的库。
这条设计带来一个直接后果:Intel 用户不需要装 oneAPI,也不需要 Level Zero。Vulkan 是图形驱动自带的运行时,Windows 显卡驱动装好就有。很多人按 llama.cpp SYCL 的教程装了整套 oneAPI,然后指望 Ollama 也能用上,方向就错了——Ollama 根本不加载 SYCL 后端。
反过来,SYCL 能跑不代表 Vulkan 能跑。两套栈查的是不同的东西:Vulkan 看 loader 枚举,SYCL 看 Level Zero 设备和 oneAPI 运行时。排查时不要拿 sycl-ls 的输出证明 Ollama 该认出显卡。
第一到第三步:版本、驱动、枚举
第一步,确认版本。 0.30 是分界线。0.12.6 时 Vulkan 还只是「本地源码编译才带」的实验特性,release note 写明需要在环境里装 Vulkan SDK、设置 VULKAN_SDK 再自行编译。0.30 的发布说明改成「Vulkan is now enabled by default」,同时覆盖 AMD 和 Intel。
ollama --version低于 0.30 时,日志里会出现 experimental Vulkan support disabled. To enable, set OLLAMA_VULKAN=1。看到这句先升级,不要在原地调参:那个版本的后端可能压根没编进去,设变量也不生效。
升级本身也有坑。Windows 的更新由托盘应用下载,点「Restart to update」之后如果没退出旧进程,ollama --version 会显示新版本,实际监听 11434 的仍是旧二进制。判断方法是看日志开头的 server config 行里的版本字段,不要只看命令行输出。
第二步,看驱动版本。 Ollama 官方只要求驱动带可用的 Vulkan 运行时,没有给最低版本号。可以借 Intel 给 PyTorch 2.15 的基线做参照:Windows 侧是 32.0.101.9033 WHQL 或更高。低于这个数字的 Arc 驱动,在 2026 年已经算旧。
:: Windows,cmd
wmic path win32_VideoController get name,driverversion
# Windows,PowerShell 更可靠
Get-CimInstance Win32_VideoController | Select-Object Name, DriverVersion# Linux
lspci -nn | grep -Ei 'vga|display'
dmesg | grep -Ei 'i915|xe ' | tail -20笔记本用户还有一个坑:OEM 厂商推送的显卡驱动往往滞后半年以上,Intel 官方安装包又会拒绝在部分 OEM 机型上安装。这种情况要先去笔记本厂商的支持页拿最新版,而不是死等 Intel 的通用包。装不上通用包不是故障,是白名单限制。
Linux 上要区分内核驱动:Arc A 系列和 12 代以后的核显走 i915,Xe2 及更新的卡走 xe。dmesg 里如果出现 GuC firmware 加载失败,Vulkan 这一层基本没戏。发行版内核太旧时,新卡会退化成无加速的 framebuffer,vulkaninfo 里连设备名都不会有。
第三步,确认 Vulkan 是否枚举到设备。 这是最容易被跳过的一步,也是最能定性的一步:Ollama 用的是系统 Vulkan loader,loader 看不到的卡,Ollama 一定看不到。
# Linux,先装工具
sudo apt install vulkan-tools mesa-vulkan-drivers
vulkaninfo --summary | grep -E 'deviceName|driverVersion|apiVersion'
Windows 没有内置 vulkaninfo,它随 Vulkan SDK 一起安装。装完在 PowerShell 里执行 vulkaninfo --summary,或在 SDK 目录下用 vulkaninfoSDK.exe。输出里必须出现 Intel(R) Arc(TM) 或 Intel(R) Graphics 字样。
枚举不到时,问题在驱动或 Mesa,与 Ollama 无关。Linux 上多数情况是 Mesa 版本太旧不认识新卡,只能退到 llvmpipe 软件渲染。Intel 在 dgpu-docs 上维护了按发行版分的客户端驱动安装步骤,比发行版仓库里的包新。
注意别把 VA-API 的包当成 Vulkan 的包。intel-media-va-driver 管的是视频硬解,装不装都不影响 vulkaninfo 是否列出设备。
枚举到了但排在不该排的位置,是另一个问题。双显卡机器上 vulkaninfo 会把核显和独显都列出来,索引顺序不一定和任务管理器一致。
Ollama 用 GGML_VK_VISIBLE_DEVICES 按这个索引选卡。官方文档特别提醒过:混合显卡系统里如果 Vulkan 核显出问题,保留 Vulkan 打开,把这个变量设成独显的索引,例如 GGML_VK_VISIBLE_DEVICES=1。
第四步:日志里其实写清了三件事
Ollama 启动时会把发现的每个设备写进日志,格式是 msg="inference compute" 加一串键值。这一行决定后面所有行为。
Windows 的日志在 %LOCALAPPDATA%\Ollama\server.log,旧文件是 server-1.log、server-2.log。Linux 用 systemd 时走 journalctl,手动 ollama serve 时直接打在终端上。
# Windows
notepad "$env:LOCALAPPDATA\Ollama\server.log"
Select-String -Path "$env:LOCALAPPDATA\Ollama\server.log" -Pattern 'inference compute|vulkan|dropping'
# Linux
journalctl -u ollama --no-pager | grep -Ei 'inference compute|vulkan|dropping' | tail -20要读的是三个位置。
library=Vulkan 代表后端选对了。如果这里是 library=cpu,说明候选列表里根本没有 GPU,后面的显存讨论没有意义。
name="Intel(R) ..." 和 type=iGPU / type=dGPU 代表设备身份。核显被识别成 iGPU 时,后面的显存数字是共享内存,不是独占显存。
total="..." available="..." 是 Ollama 认为可用的显存。Linux 上这行经常显示 0 B,原因是 Vulkan 读取显存信息需要额外的 capability,官方给的解法是 sudo setcap cap_perfmon+ep /usr/local/bin/ollama。没有它,Ollama 会退化成按模型文件大小估算,调度偏保守,长上下文更容易被判成装不下。
还有一行只在核显机器上出现:dropping integrated GPU。Ollama 默认不把核显纳入调度,服务端配置里对应 OLLAMA_IGPU_ENABLE,设为 1 才会把它当候选。笔记本上「独显认不出、核显也不动」的组合,多半是这一条。
日志信息不够时,按官方 troubleshooting 的方法加详细日志:先退出托盘里的 Ollama,再在 PowerShell 里设 $env:OLLAMA_DEBUG="1" 并直接启动 ollama app.exe。这样启动过程的每一步设备筛选都会打出来,包括被拒绝的原因。
日志只记录启动那一刻的设备状态。外接显卡、扩展坞、休眠唤醒之后再插拔,Ollama 不会重新枚举,必须重启服务。这类「昨天好好的今天不行」的问题,九成是枚举时机,不是配置漂移。
第五步:显存够不够,看的是可用量不是总量
Arc B580 是 12GB,B60 是 24GB,但 Ollama 能用到的不是标称值。Windows 桌面合成、浏览器硬件加速、驱动自身都要占,实际可用通常少 0.8–1.5GB。核显更极端:它和系统内存共用同一池,total 可能显示几十 GB,但带宽只有内存的水平。
判断方法很直接:日志里 available 减去模型 SIZE,剩下的够不够 KV cache。8B 模型 Q4 量化约 4.7GB,32K 上下文的 f16 KV cache 还要 4.5GB 左右,这个量级在 8GB 卡上必然溢出。
这里有一个 Intel 特有的变量:Resizable BAR。Arc 独显的显存访问效率依赖 ReBAR。主板没开这项时,同样大小的分配会更吃力,表现是同一个模型在别的机器上能全量装载、在你这台被判成装不下。BIOS 里开启 Above 4G Decoding 与 ReBAR 之后重测,是排查顺序里值得加的一步。
显存不够不会让 Ollama 报错,它会把装不下的层放到 CPU,PROCESSOR 变成百分比形式。这种部分卸载在 Intel 卡上代价比 NVIDIA 更大:每生成一个 token 都要跨 PCIe 回传中间结果,速度掉得比层数比例更狠。
核显要单独算。Core Ultra 的核显没有独立显存,Arc 140T 这类型号的 total 会把系统内存算进去,看起来有十几 GB,实际可用带宽只有双通道内存的水平,而且和 CPU 抢同一池。
核显上跑 8B Q4 能不能成,取决于内存频率和是否双通道,不取决于 total 那个数字。真要长期用,独显是唯一稳的路线。
第六步:环境变量进了哪个进程
这一条排第六,是因为它最容易被误判。变量必须被 Ollama 的服务进程继承,在另一个终端设完再点托盘图标,等于没设。
Linux 用 systemd 时写 drop-in,不要改主 unit:
sudo systemctl edit ollama
# 在 [Service] 段写入
# Environment="OLLAMA_VULKAN=1"
# Environment="OLLAMA_IGPU_ENABLE=1"
sudo systemctl daemon-reload
sudo systemctl restart ollama
Windows 上先彻底退出托盘里的 Ollama,再设用户级变量,最后从开始菜单重新启动。只在一个 PowerShell 窗口里 $env:OLLAMA_VULKAN="1" 对已经运行的服务无效。
[Environment]::SetEnvironmentVariable("OLLAMA_VULKAN", "1", "User")
[Environment]::SetEnvironmentVariable("OLLAMA_IGPU_ENABLE", "1", "User")
容器里的判断更简单:设备没透传,变量设了也白设。Vulkan 路径需要容器能看到 /dev/dri,启动参数里加 --device /dev/dri,必要时再补组 ID。
反过来,如果日志里 Vulkan 抢了本该走 CUDA 的卡,用 OLLAMA_VULKAN=0 或 GGML_VK_VISIBLE_DEVICES=-1 关掉整个 Vulkan 路径。这是 0.40.6 之后的已知现象:官方 issue #19165 记录了纯 NVIDIA 机器被 Vulkan 接管、decode 从 70–72 tok/s 掉到 66 tok/s 的情况,显式设 OLLAMA_VULKAN=false 后恢复。
第七步:把结论固定成一条可重复的命令
排查完要留下可复现的证据,否则下次更新又会回到原点。
# Linux 一条命令拿到全部判定依据
ollama --version; vulkaninfo --summary 2>/dev/null | grep -E 'deviceName|driverVersion' && journalctl -u ollama --no-pager | grep -E 'inference compute|dropping' | tail -5 && ollama ps
# Windows
ollama --version
vulkaninfo --summary
Select-String -Path "$env:LOCALAPPDATA\Ollama\server.log" -Pattern 'inference compute' | Select-Object -Last 3
ollama ps| 现象 | 日志特征 | 判定 | 动作 |
|---|---|---|---|
| 始终 100% CPU | 只有 library=cpu | Vulkan 后端未加载或版本过旧 | 升到 0.30 以上,确认 OLLAMA_VULKAN 未被设为 0 |
| 有 Intel 设备但被跳过 | dropping integrated GPU | 核显默认不参与调度 | 设 OLLAMA_IGPU_ENABLE=1 |
| 设备列表为空 | 无 inference compute 行 | 驱动或 Vulkan loader 缺失 | 装 vulkan-tools 与厂商驱动,先过 vulkaninfo |
| 百分比形式 | available 远小于 total | 显存不足,发生部分卸载 | 降上下文、换 q8_0 KV cache、降量化档 |
| 偶发回 CPU | 唤醒后 total 变 0 | 驱动休眠恢复异常 | 重启 Ollama 服务,Linux 上重载 GPU 驱动 |
两个系统的检查点差在哪
同一张 Arc 卡在两个系统上的失败方式不一样,排查顺序也要换。
Windows 的 Vulkan 运行时随显卡驱动一起装,驱动装好就意味着 loader 可用,不需要额外包。代价是驱动版本被 OEM 和 Windows Update 两层夹住,经常出现「Intel 官网有新版、设备管理器说已是最新」的情况。以 Intel 官方安装包为准,装完重启。
Linux 的 Vulkan 是独立组件。Mesa 提供开源实现,Intel 另有客户端驱动包,两者可以并存也可以互相覆盖。
发行版仓库的 Mesa 通常滞后,新卡需要按 Intel dgpu-docs 的步骤加官方源。这一步没做,vulkaninfo 会报错或只列出 llvmpipe 软件渲染设备——后者最容易被误判成「已识别」,因为它的名字里也有 Intel。
第二处差异在显存口径。Windows 走 WDDM,任务管理器把「专用 GPU 内存」和「共享 GPU 内存」分开列,Ollama 拿到的是可用专用显存减去系统占用。Linux 没有这层抽象,available 直接来自驱动查询,权限不足时干脆给 0。
第三处差异在进程模型。Windows 是托盘应用拉起服务,退出应用才释放端口;Linux 是 systemd 单元,systemctl restart 才算真正重启。两边都会出现「新配置没生效」的假象,原因都是旧进程还在。
第四处差异在日志。Windows 写文件并轮转,适合事后翻;Linux 走 journald,默认只保留有限天数,排查跨天问题时先确认日志还在。
怎么确认自己不是白忙
改完任何一项,只看一个指标:ollama ps 的 PROCESSOR 是否稳定在 100% GPU,并且 CONTEXT 是你实际需要的长度。两个条件同时满足,才算修好。
只满足前一个不够。上下文被压到 4096 时,模型确实全在显存里,但长文档一样跑不动,失败方式从「慢」换成了「截断」。
七步走完 Vulkan 仍然枚举不到卡,问题已经不在 Ollama 这一层。
这时候用 llama.cpp 的 Vulkan 后端跑同一个 GGUF 做交叉验证,能直接区分是 Ollama 的调度问题还是驱动问题;预编译包和自编译的取舍可以参考llama.cpp 部署 Windows 的选型。
想先搞清楚 Ollama 的服务端与客户端分工,看这篇基础说明比在日志里猜要快。显存与上下文的换算关系,另有一张按参数量分档的对照表。
登录后可点赞、收藏与反馈。