AI 并行改代码:先算文件交集,再决定开几个 agent
让多个 AI 同时改一个仓库,冲突不是运气问题。我造了个 34 文件的仓库,用 6 个真实任务试了四种切法:按目录切零冲突但三个 agent 都在自欺,按功能切自测全绿却只合进三分之一。并行度由文件交集图决定,不是排期。
今天 Claude Code 的 Projects 把「多线程并行」做成了一个按钮:一个协调者,若干智能体线程,每个线程是一条独立分支加一份独立仓库副本,重叠的改动「按普通 PR 的 merge conflict 处理」。官方文档里紧跟一句代价:多个线程并行,会更快撞到用量上限。
但比额度更早撞墙的通常是 git。我造了一个 34 个文件的仓库,用 6 个真实迭代任务试了四种切法,想回答一个很具体的问题:同一个仓库里,到底能同时开几个 agent。
先说结论:这 6 个任务,最多只能开 2 个。不是模型不够强,是文件交集不允许。
六个任务,十一条共享边
仓库是一个小型订单系统,34 个文件、32 个 Python 模块,分五层:api 接参数、service 写业务、repo 管持久化、model 定结构、common 放金额、错误、缓存、日志这些全域工具。外加 11 个单元测试。
任务都是 AI编程 里的常见迭代,不是为实验编的假需求:
| 任务 | 碰的文件数 |
|---|---|
| T1 订单加优惠券 | 6 |
| T2 退款按比例 | 5 |
| T3 金额统一改用 Decimal | 7 |
| T4 统一对外错误码 | 5 |
| T5 列表分页统一 | 5 |
| T6 库存预占 | 5 |
把每个任务碰到哪些文件列出来,两两求交集,得到 11 条共享边。其中三条边共享 3 个文件:
T1 × T3
  money.py、model/order.py、service/order_service.py
T2 × T3
  money.py、model/refund.py、service/refund_service.py
T5 × T6
  api/catalog.py、product_repo.py、catalog_service.py
最烫的是 common/money.py,被 T1、T2、T3 三个任务同时碰。api/orders.py 和 api/catalog.py 也各被三个任务碰。
这就是问题所在。任务之间不是靠"功能名字"耦合的,是靠文件耦合的。 你说「订单」和「退款」是两个功能,但它们都改金额工具;你说「分页」和「库存」八竿子打不着,但它们都改同一个 catalog 接口。
按目录切:零冲突,三个 agent 都在自欺
最直觉的切法是按目录:一个 agent 管 api/,一个管 service/ 和 model/,一个管 common/、repo/ 和测试。
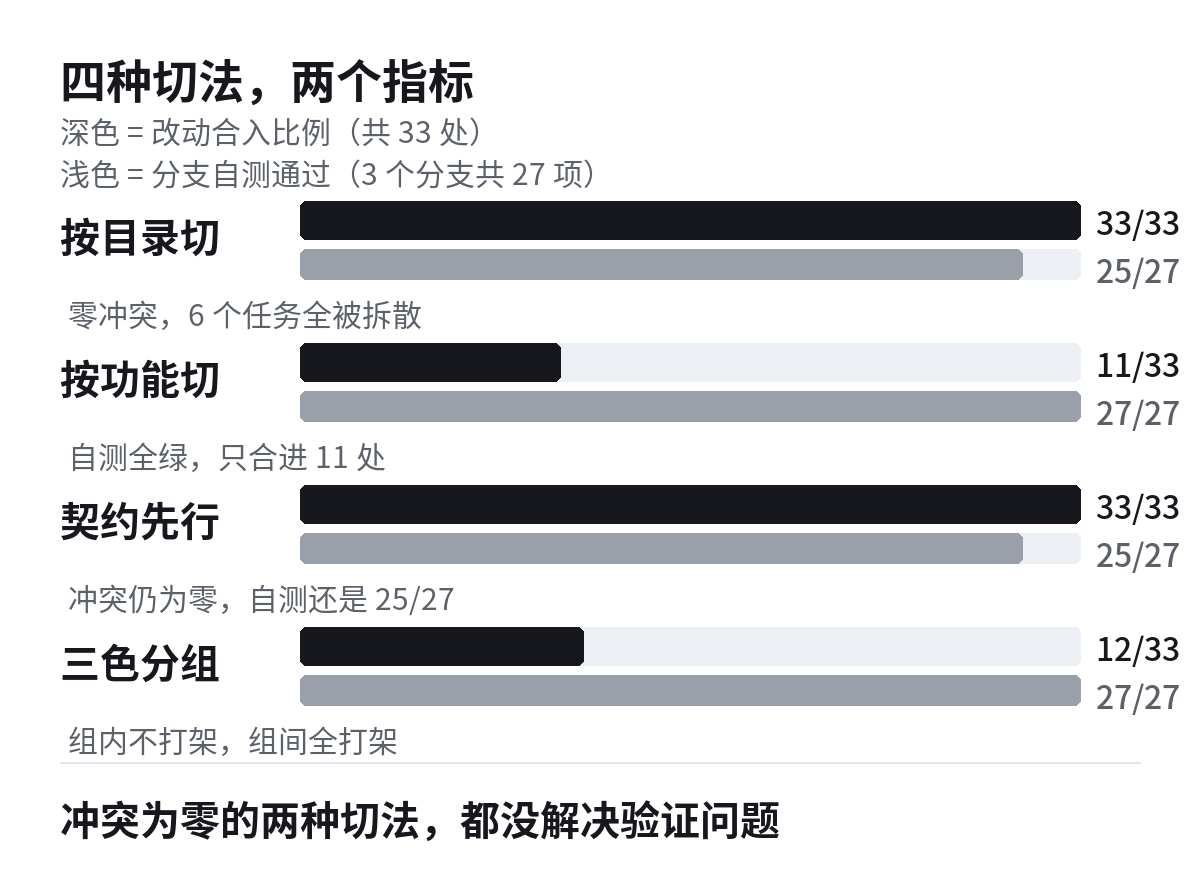
结果非常漂亮:三对合并,零冲突,三个分支全部合入,集成后 11 个测试全过。
代价藏在另一列:6 个任务,6 个全部被拆散了。一个任务从 api 到 tests 横跨三层,被切给三个人做。
更麻烦的是自测。第三个 agent(service + model + tests)在自己分支上跑测试,11 个里挂了 2 个:
tests.test_order::test_coupon_discount
  AttributeError: module 'app.common.money'
  has no attribute 'coupon_amount'

tests.test_refund::test_partial_refund
  AttributeError: module 'app.common.money'
  has no attribute 'prorate'
它自己写的测试,在自己分支上跑不通,因为 money.py 在另一个 agent 手里。它没法确认自己写对没写对,只能等三路合并之后才知道。
这就是按目录切的真相:git 层面干净,是因为每个文件只归一个人;但工作没法验证,是因为一个任务被劈成了三份。 冲突为零不等于质量可控,它只是把问题从「合并时爆」推迟到「集成后才发现」。
按功能切与契约先行:自测全绿,合并只剩三分之一
第二种切法按功能分三组:交易(T1+T2)、基础设施(T3+T4)、目录库存(T5+T6)。每组拿到的都是完整任务,跨层依赖都在自己手上。
自测结果符合预期:10/10、8/8、9/9,三个分支全绿。
合并结果完全相反:三对组合,三对全冲突,最终只合进去一个分支。被挡在外面的是 F2(13 处改动)和 F3(10 处改动),33 处改动里只进了 11 处,约三分之一。
冲突文件很集中:api/orders.py、api/refunds.py、common/money.py、api/catalog.py。都是前面矩阵里被两个以上任务碰过的文件。
那有没有办法两头都要?我试了工程上常见的答案:契约先行。先把所有跨组会被调用的函数签名合进主干,做成空实现,再按目录并行。
结果是:冲突仍然是零(按目录切本来就没冲突),但自测通过数没有变化,还是 9/11。报错从 AttributeError 变成了 NotImplementedError。
tests.test_order::test_coupon_discount  NotImplementedError
tests.test_refund::test_partial_refund  NotImplementedError
签名可达,不等于行为可达。空实现只是把「找不到函数」换成了「调用就抛错」,agent 依然无法验证自己写的东西。契约先行能防接口对不上,防不了并行里最贵的那件事:验证闭环断了。
并行度由文件交集图决定,不由排期决定
我又把并行度从 1 拉到 6,用同一套自动分组跑了一遍:
| 并行度 | 冲突对数 / 总对数 |
|---|---|
| 1 | 0 / 0 |
| 2 | 1 / 1 |
| 3 | 3 / 3 |
| 4 | 6 / 6 |
| 6 | 10 / 15 |
2 路就开始冲突,3 路全部冲突。这不是分组技巧的问题,是那 11 条共享边的必然结果:只要两个 agent 改到同一个文件,合并时就有冲突风险。
我最后试了一种更"数学"的分法:把任务当节点、共享文件当边,做图着色,要求组内任意两个任务不共享文件。6 个任务刚好能分成 3 组:{T3,T4}、{T1,T6}、{T2,T5},每组内部确实互不相交,每个任务也保持完整。
但组间仍然两两有边——因为 {T1,T6} 里的 T1 和 {T3,T4} 里的 T3 都改 money.py。所以 3 组同时开工,还是 3 对全冲突,最终合入 1/3。
换成最大独立集来算,答案直接掉到 2:这 6 个任务里,只有 T1(订单优惠券)和 T6(库存预占)的文件集合完全不相交,可以真正同时干。剩下 4 个必须排队。
回头再看 Projects 官方给的例子,就很有意思了:它举的是「把 API、web、mobile 三个仓库接进来,一个 repo 一个线程,改完告诉你先合哪个」。官方 demo 用多仓库,不是因为跨仓库更高级,是因为同一个仓库里根本凑不出那么多互不相交的活。
所以开工前的动作应该倒过来,不是先想"我要开几个 agent",而是先算:
- 列出每个任务会碰哪些文件。不确定就粗略估,
git log --name-only看历史改动分布也行。 - 两两求交集,画出共享矩阵。有共享就有边。
- 求最大独立集,那个大小才是并行度上限。3 个任务能开 2 个,6 个任务也可能只能开 2 个。
- 横切改动单独排。改金额类型、统一错误码、换分页参数这类,天生碰所有层,必须串行。
- 剩下必须并行又共享文件的,把冲突当预算:预留解冲突的时间,并安排合并顺序——先合改动面小的,后合改动面大的。
这套判定我留成开发工具链里的一个小脚本 plan.py,输入任务和文件清单,输出共享矩阵、最大独立集和建议分组,跑一遍不到一秒。
最后说清楚这个实验的边界:仓库是照真实分层结构造的,任务是常见迭代需求,但改动多集中在文件末尾追加函数,属于冲突率的上界——真实改动分散在不同函数里时,git 能自动合并掉一部分。所以这些数字不能拿来预测你的项目会冲突几次,只能用来比较:在同一个仓库里,按目录切、按功能切、按契约先行切,谁先崩、崩在哪里。
量完再开,比开完再吵便宜。
如果你更关心并行跑起来之后的钱花在哪,可以看 AI 编码六成预算花在失败上;合并进来的东西怎么把关,看 AI 代码审查怎么做;Claude Code 本地的命令拦截,看 关掉确认前先装一道命令闸。
登录后可点赞、收藏与反馈。