开源大模型私有化部署:1.6T 要多少卡、能不能商用
以 LongCat-2.5 的公开数据为例,把私有化部署算成可核对的三笔账:权重要多少张卡、194 张卡为什么拆成 2/64/128、88.4 与 38.5 两张卷子怎么读,以及 MIT 协议管不到的三项成本。
美团把 LongCat-2.5 的权重放出来了:1.6 万亿参数,MIT 协议,官方示例用 194 张昇腾卡跑通。消息传开之后,问得最多的不是它有多强,而是两句话——我这套机器要多少张卡,这个协议能不能直接商用。
这篇不评价强弱,只把这两句话算成能核对的数字。
第一笔:权重先压到 1.34 TB,再谈卡
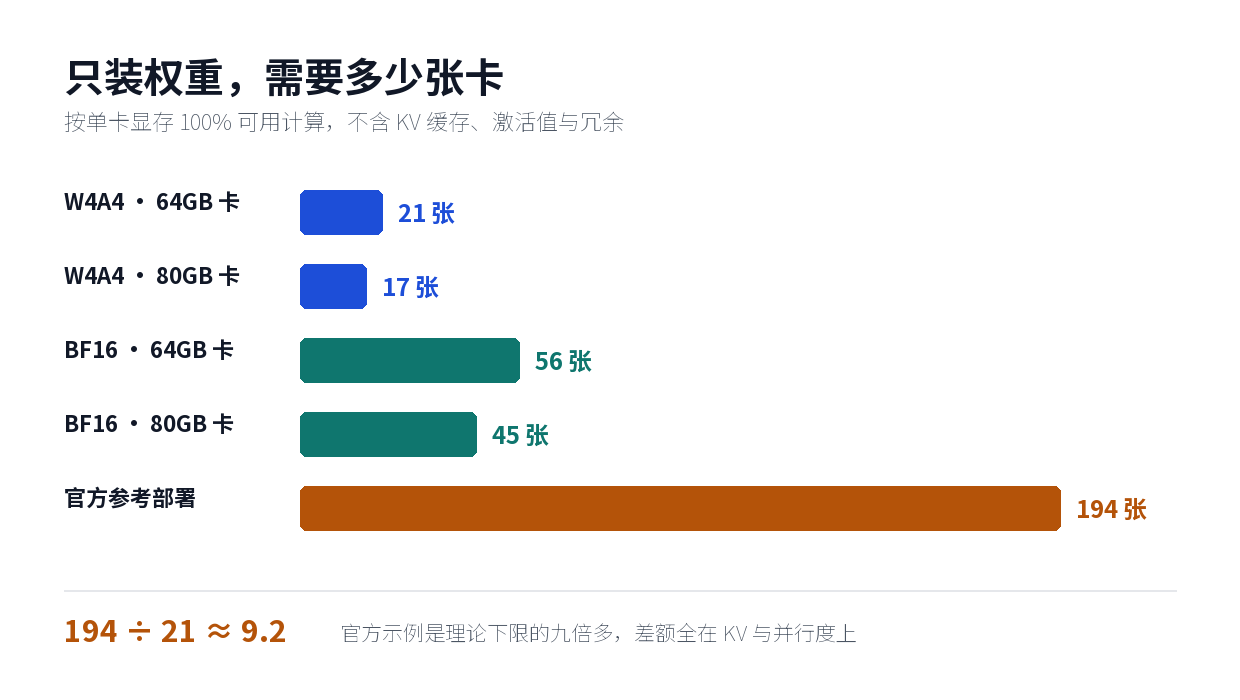
下载页有两个仓库,体积差 2.66 倍。BF16 全精度约 3.56 TB,W4A4 量化版约 1.34 TB。这个差别直接决定你第一批要买多少卡。
| 权重版本 | 仓库体积 | 64GB 卡下限 | 80GB 卡下限 |
|---|---|---|---|
| W4A4 | 1.34 TB | 21 张 | 17 张 |
| BF16 | 3.56 TB | 56 张 | 45 张 |
「下限」的口径要说清楚:单卡显存按 100% 可用于权重来算,不留 KV 缓存、不留激活值、不留通信 buffer,也不做任何冗余。真实部署一定比这个数大,所以它只用来做否决——先看自己手里的机器过不过这一关。
按这个算法,8 张 80GB 卡一共 640GB,连 W4A4 的一半都不到。这一关过不去,后面所有讨论都没有意义。
量化版不只是为了省显存。官方压测里,W4A4 相对 W8A8 基线的 prefill 吞吐高 43.3%,decode 吞吐高 42.77%,首字延迟低 15.91%。同一个模型,用对版本等于白拿四成吞吐。
但 21 张不是答案。官方示例是 194 张,正好是 21 的 9.2 倍。中间那 173 张卡不是浪费,是 KV 缓存、并行度和 P/D 分离三件事的代价。
第二笔:194 张卡是并行度的乘积,不是显存除法
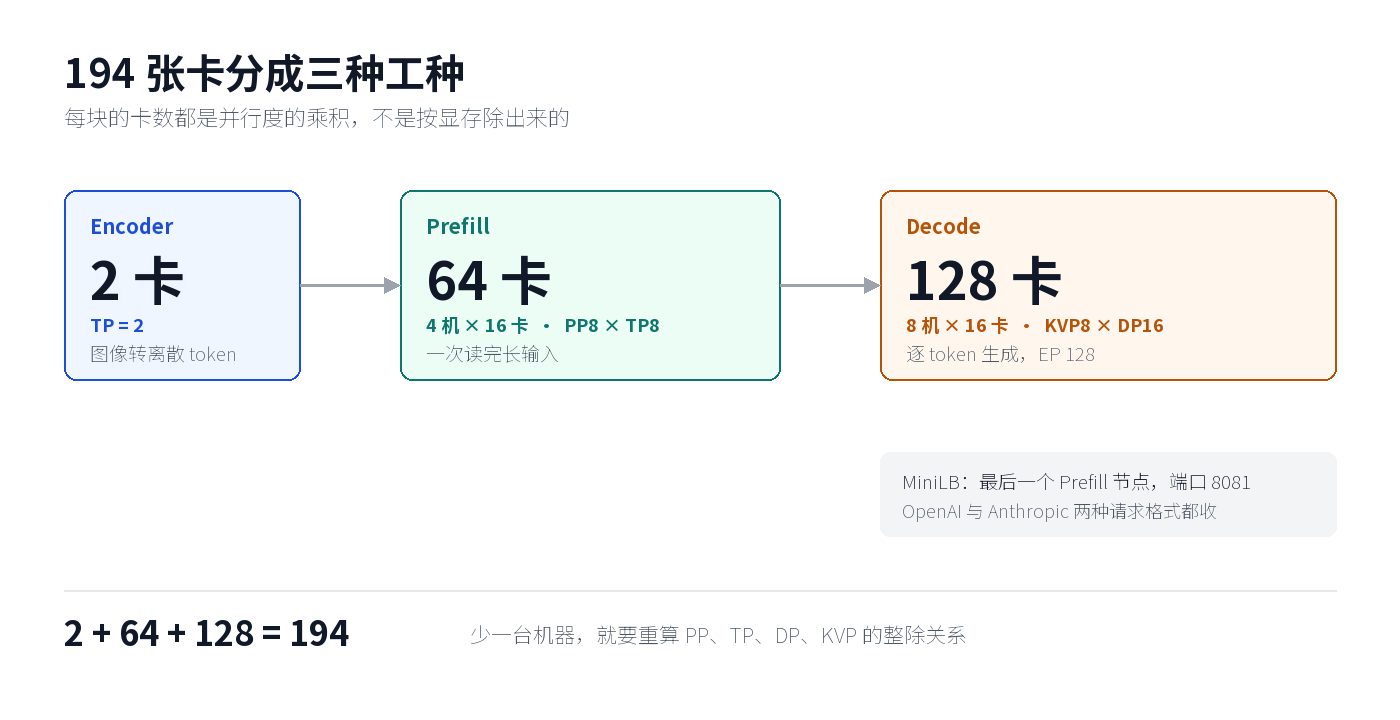
官方给的是 EPD 分离部署:Encoder 2 卡、Prefill 64 卡、Decode 128 卡,P/D 单机 16 卡。
| 角色 | 卡数 | 并行配置 | 干什么 |
|---|---|---|---|
| Encoder | 2 | TP = 2 | 把图像转成离散 token,结果缓存 |
| Prefill | 64 | 4 机 × 16 卡,PP8 × TP8 | 一次读完长输入 |
| Decode | 128 | 8 机 × 16 卡,KVP8 × DP16,EP128 | 逐 token 生成 |
三个数字都不是买出来的,是算出来的。
Prefill 的 64 = PP8 × TP8。先把流水线切成 8 段、张量切 8 份,卡数就被定成 64。少买一台机器只剩 48 卡,PP 或 TP 就得改,改完要么切不整齐,要么跨机通信量上去。
Decode 的 128 = KVP8 × DP16。16 组数据并行,每组 8 卡做 KV 并行,128 张卡刚好铺满 8 台机器。专家并行放在整个解码池上,EP = 128。
Encoder 是 2 卡 TP2 的独立 HTTP 服务,端口 9101,输出格式 rvq_indices。
为什么不混跑:prefill 是把几万到上百万 token 一口气读完,吃算力峰值;decode 是一个 token 一个 token 往外吐,吃显存带宽和 KV 容量。
混在一批卡上,长输入会把短输出堵在队列里。官方把 66% 的卡全给 decode,因为生成阶段才是用户真正等待的地方。
真正花时间的不是买卡,是下面这几件事:
- 12 台机器(4 台 Prefill、8 台 Decode),单机 16 卡
- 版本必须成套:Ascend HDK 25.0.RC1.1(或配套 CANN 9.0.0)、Python 3.11、PyTorch 2.9,torch_npu 与 torchair 要对得上号
- flash-npu-kernel 得自己编:先出 CANN 自定义算子
.run包,再装flash_ops和flash_npu_kernel两个 wheel,它们是两个包,只装一个不算完 - 节点顺序写死在脚本里:
iplist前 8 个是 Decode,后 4 个是 Prefill,顺序错了服务起不来 - 网络要通三条路:Encoder 的 HTTP、编码结果回传、P/D 之间的 KV 传输
先把变量写对,再用 DRY_RUN 预演一遍,确认每台机器会收到什么命令:
export MODEL_PATH=/data/meituan-longcat/LongCat-2.5-W4A4
export ENCODER_URLS=http://encoder-node0:9101
export iplist="decode-node0 decode-node1 decode-node2 decode-node3 \
decode-node4 decode-node5 decode-node6 decode-node7 \
prefill-node0 prefill-node1 prefill-node2 prefill-node3"
export testpath=/data/longcat25

DRY_RUN=1 bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh code
bash npu_test/flash26b/run_pro_w4a4kv8_mm_epd.sh start
起来之后先看三个健康检查,再用一条最小的对话请求打通链路。MiniLB 在最后一个 Prefill 节点上,端口 8081:
curl --fail http://encoder-node0:9101/health
curl --fail http://prefill-node0:6080/health
curl --fail http://decode-node0:6080/health

curl -X POST http://prefill-node3:8081/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"LongCat-2.5","messages":[{"role":"user","content":"用一句话解释 EPD 分离"}],"max_tokens":256}'
服务端打印 The server is fired up and ready to roll! 只代表进程活着,三条 health 全 200 才代表链路通。这一步做完,你才有资格谈它好不好用。
第三笔:88.4 和 38.5 是两张卷子
| 基准 | LongCat-2.0 | LongCat-2.5 | Opus 5 |
|---|---|---|---|
| Terminal Bench v2.1 | 70.8 | 88.4 | 89.1 |
| Terminal Bench v4.0 | 3.0 | 38.5 | 53.9 |
| DeepSWE v1.1 | 9.7 | 64.6 | 未列 |
| Program Bench(Almost) | 2.5 | 25.5 | 37.0 |
同一代模型,两张卷子的涨幅差十倍:v2.1 从 70.8 涨到 88.4,是 1.25 倍;v4.0 从 3.0 涨到 38.5,是 12.8 倍。这说明 v2.1 已经饱和——旧题被训进去了,分数贴着天花板,看不出真实差距。
对 Opus 5 的差距也是两套数:v2.1 只差 0.7 分,v4.0 差 15.4 分。通稿用的是前者,选型要看后者。
Program Bench 的 Almost Resolved 是 25.5,高于 GPT-5.6 Sol 的 23.0,低于 Opus 5 的 37.0。这条最能说明它的位置:不是第一梯队,是中上。
有两个限定必须说。截至 11 月 15 日,没有任何第三方实验室给出独立分数,Artificial Analysis 上没有它的页面,OpenRouter 上还只有 2.0。表里所有数字都是美团自测。模型卡自己给未加星的成绩标了 indicative only——厂商愿意写这句话,比多考两分更有价值。
落到选型上,按任务分比按总分分更靠谱:
| 任务 | 依据 | 建议 |
|---|---|---|
| 界面还原、截图改前端 | Vision2Web 78.6,Opus 5 为 80.2 | 可以用,这是它最接近第一梯队的地方 |
| 联网查资料、多步研究 | BrowseComp 91.9,MCP Atlas 83.1 | 强项,优先试 |
| 终端装环境、改配置 | TB v4.0 38.5,Opus 5 为 53.9 | 简单任务可用,复杂排障别指望 |
| 大型遗留仓库重构 | DeepSWE 64.6 | 先拿自己的仓库做小样本对比 |
第四笔:MIT 管许可,不管账单
MIT 给了什么:权重可商用、可修改、可再分发、可二次训练,不需要向美团申请授权。不给什么:商标权和专利权。这条边界对绝大多数团队够用,要和别的开源模型对比着看,可以参照智谱和 DeepSeek 的开源不是一种开里那套口径。
MIT 管不到的第一项,是价格没有到期日。API 现在 $0.30/百万输入、$1.20/百万输出,缓存输入 $0.006,1M 上下文、单次最多 256K 输出。定价页标的是限时优惠,没写结束时间,也没写正价。上一代 LongCat-2.0 的正价是 $0.75/$2.95。做预算按正价留余量,别按促销价签长约。
第二项是自建的打平量。按 194 卡、3:1 的输入输出比、$0.525/百万 token 的混合价折算:
| 单卡价 | 月成本 | 打平所需月用量 |
|---|---|---|
| 5 万元 | 31.5 万元 | 844 亿 token |
| 10 万元 | 58.4 万元 | 1567 亿 token |
| 20 万元 | 112.3 万元 | 3013 亿 token |
单卡 10 万元、3 年折旧、电费 0.8 元/度、单卡 400W 的假设下,每月要跑 1567 亿 token 才追平托管账单。这个量级只有平台方和云厂商够得着。
中小团队自建 194 卡,买的不是省钱,是数据不出域——和换 Kitesurf 前先过四道关里算无头浏览器那笔是同一个道理:开源自建不比托管便宜。
第三项是可移植性。官方只给昇腾路径:代码在 SGLang-FluentLLM 的 longcat-2.5-npu 分支,依赖 CANN 和 torch_npu,没有任何 NVIDIA 部署指引,也没有 GGUF 文件,llama.cpp 和 Ollama 现阶段跑不了。手里是 H100 的团队,要么自己移植,要么等社区。
如果只是想在业务里用,API 同时收 OpenAI 和 Anthropic 两种格式,改个 base_url 和 key 就能接进现有工具,试的成本几乎为零。对绝大多数团队,这一条比自建划算得多。
采购前先问五个问题。 权重是 BF16 还是 W4A4,两者差 2.66 倍显存;PP、TP、DP、KVP 能不能整除到你现有的卡数,除不尽就要重买;有没有第三方分数,厂商自测只能当参考;许可覆盖到哪一步,权重、商标、专利是三件事;促销价什么时候结束,没有正价的报价进不了年度预算。
这五个问题答完,你大概会得出一个不太好听但省钱的结论:1.6 万亿参数的模型开源了,能商用的是许可,不是你的机房。先用 API 把场景跑通,等用量真的到了千亿 token 一个月,再谈买卡。
登录后可点赞、收藏与反馈。