ocr 接国产模型:一条规则换掉 8KB 内置规则
open-code-review 装完第一跑常报 no valid LLM endpoint:Claude 订阅不是 API key。三条路线接法与国内 provider 选项,外加 catch-all 规则换掉 8KB 内置规则的实测。
阿里开源的 open-code-review(命令名 ocr)今天在 GitHub 涨到 5.4 万星。你在自己机器上装完,敲下 ocr review,等来的是一行报错:
Error: resolve LLM endpoint: no valid LLM endpoint configured;
one of OCR_LLM_URL/OCR_LLM_TOKEN/OCR_LLM_MODEL, ~/.opencodereview/config.json,
or ANTHROPIC_BASE_URL/ANTHROPIC_AUTH_TOKEN/ANTHROPIC_MODEL must be set
不是装错了。ocr 只是个壳,模型得你自己接。全网教程都写这一句,却很少说清后半句:Claude Code 的订阅不能当它的 API key。只有订阅、没有 key 的人只能走委托模式;而委托模式在同一模型下的 20 个 PR 复测里,有 8 个一条评论都没报。
下面是我在 Windows 11、Git 2.55、ocr 1.14.0 上跑出来的结果:三条路线怎么接、哪些坑不会报错,命令与报错都照原样贴。
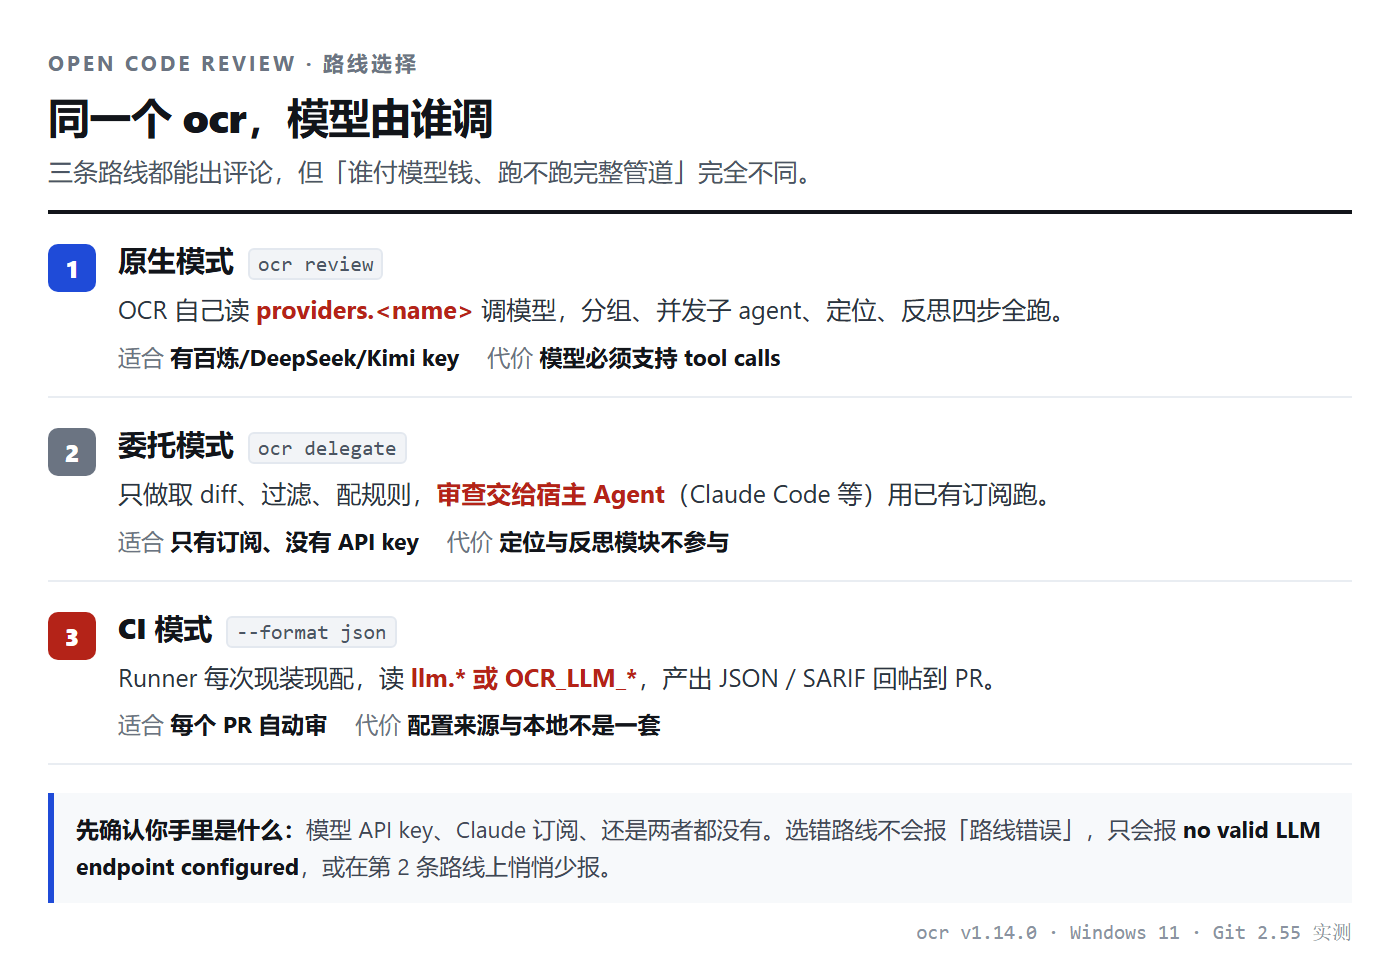
先分清:ocr 和 Claude Code 的 /code-review 差在哪
两者都读 git diff、都输出行级评论,但「谁调模型、跑哪几步」是两套东西。把这张表看一遍,后面的坑基本能自己对号。
| 对比项 | ocr 原生模式 | ocr 委托模式 | Claude Code /code-review |
|---|---|---|---|
| 谁调模型 | OCR 自己,读 providers.<name> | 宿主 Agent(Claude Code / Codex / Cursor) | Claude Code 自己 |
| 模型凭证 | 独立 API key 或环境变量 | 宿主已有的登录态 | 你的订阅 |
| 跑哪些步骤 | 分组、并发子 agent、定位、反思,四步全跑 | 只做取 diff、过滤文件、配规则 | 官方内置流程 |
| 适合谁 | 有国产模型 key、要按目录写规则 | 只有订阅、偶尔自查 | 本来就在用 Claude Code |
第三列不是「更差」,是另一条产品线。真正的坑在第二列:官方 README 写得很直白——“A host-agent subscription is not automatically an API credential for native mode.” 你订阅的那个 Claude,喂不进 ocr 的原生模式。
路线一:接百炼或 DeepSeek,四条命令跑通原生模式
前置只有两条:Git ≥ 2.41(它靠 git 取 diff、搜代码、找 merge-base),以及能跑 npm 的 Node。我这里是 Git 2.55、Node 22.22.2。
npm install -g @alibaba-group/open-code-review

ocr config set provider dashscope      # 换 deepseek / kimi / z-ai 同理
ocr config set model qwen3-coder-plus  # 模型名按你账号里可用的填
ocr config set providers.dashscope.api_key "$DASHSCOPE_API_KEY"

ocr llm test
配 key 那条必须走环境变量:密钥写进命令行,等于写进 shell 历史。ocr 最终会把 key 落到 ~/.opencodereview/config.json(权限 0600),那已经是明文存储,别再把这个文件提交进仓库。
ocr llm test 会真发一轮请求;失败直接抛 HTTP 错误。我用假 key 试过,返回 401 Unauthorized 与 invalid_api_key,退出码 1。所以它可以放在 pre-commit 或 CI 第一步做连通性检查,比等 ocr review 跑完再排查快得多。
内置 30 个 provider,国内这 8 个够用
| provider 名 | 端点 | 对应环境变量 |
|---|---|---|
dashscope | 阿里云百炼 | DASHSCOPE_API_KEY |
deepseek | DeepSeek | DEEPSEEK_API_KEY |
kimi | 月之暗面 | MOONSHOT_API_KEY |
z-ai | 智谱 | Z_AI_API_KEY |
volcengine | 火山方舟 | ARK_API_KEY |
siliconflow-cn | 硅基流动 | SILICONFLOW_API_KEY |
baidu-qianfan | 百度千帆 | QIANFAN_API_KEY |
tencent-tokenhub | 腾讯 TokenHub | TENCENT_TOKENHUB_API_KEY |
两个容易忽略的点。本地 Ollama 不在内置列表里——列表里只有 ollama-cloud,跑本机模型要自己建 custom provider;model 名本地不校验,写错了要等发请求时才报 404 或 401。
ocr config set provider ollama
ocr config set custom_providers.ollama.url http://127.0.0.1:11434/v1
ocr config set custom_providers.ollama.protocol openai
ocr config set custom_providers.ollama.model qwen3:32b
ocr config set custom_providers.ollama.api_key ollama
custom provider 的 url 填到 /v1 就够,ocr 会自己补 /chat/completions。注意这一点在 CI 里是反的,后面单独说。
路线二:只有 Claude 订阅,委托模式能干什么、不能干什么
没有独立 key 时,官方给的答案是委托模式:ocr 只负责取 diff、过滤文件、按路径配规则,审查交给宿主 Agent 用你已有的订阅跑。
npx skills add alibaba/open-code-review

# 装进 Claude Code 之后,两个命令的区别:
/open-code-review:review            # 原生,走 OCR 自己的 provider
/open-code-review:delegate-review   # 委托,走宿主模型
关键差别不在命令,在管道。官方文档写明:委托模式下,OCR 自己的审查 agent、定位模块和反思模块都不运行——而这套设计正是它宣称比通用 Agent 更准的原因。
掘金作者 ZzT 用 aacr-bench 原版脚本、同一个 Opus 5.5、抽 20 个 PR 做了对照(Claude Code 2.1.330 对 OCR 1.13.13 委托模式):
| 指标 | Claude Code 2.1.330 | ocr 委托模式 |
|---|---|---|
| 20 个 PR 总花费 | $6.37 | $6.03 |
| 召回率 | 37.1% | 15.5% |
| 准确率 | 28.1% | 44.4% |
| 报出的评论 | 108 条 | 27 条 |
| 平均耗时 | 1 分 21 秒 | 50 秒 |
两个数字最值得记住:20 个 PR 里有 8 个,OCR 一条都没报(回复原文是「没有发现高或中严重度的问题」,因为委托命令规定 Low 直接丢弃);召回率 15.5% 对 37.1%。
所以委托模式的正确用法是「拿待审文件清单和覆盖率,再让宿主 Agent 按清单审」,不是「代替 review」。还有一处要留意:Claude Code 插件的委托命令默认会自动修复 High 和 Medium 里安全、明确的问题,第一次跑建议先加一句「只评审、不改文件」。
为什么「1/9 token」你复现不出来
README 的榜单是 200 个 PR、5 个模型各跑两遍,Claude Code 那侧是 6 月 8 日的 2.1.169。按图里每个 PR 的平均 token 算,Claude Code 是 OCR 的 5.4 到 14.7 倍,均值 9.6 倍——这是「约 1/9」的出处。
拿这个数去算账单会差很远,原因有三个:
- 口径含缓存:aacr-bench 把缓存读取、缓存写入、正常输入加在一起算 token。两边九成 token 是缓存读取,按输入单价的 0.1 倍计费,token 数被放大,账单没有。
- 榜单里的 Claude Code 不是现在的:2.1.328(11 月 19 日)改了
/code-review,只报 bug 和 CLAUDE.md 违规,清理建议交给/simplify;同一版还给结果分了 Important、Pre-existing、Nit 三档。榜单里「每个 PR 报 30 条」的版本,现在报 5.4 条。 - 模式不同:1/9 测的是原生模式;同模型走委托模式,20 个 PR 总花费 $6.37 对 $6.03,只差 6%。
结论:省 token 是真的,但「省 token」不等于「省钱」,更不等于「够用」。按量付费的人看账单口径,订阅用户看召回率。
一条 catch-all 规则,把 8KB 内置规则换掉
这是我在本机最意外的一处。ocr 按路径匹配规则,四层优先级:--rule 高于仓库 .opencodereview/rule.json,高于 ~/.opencodereview/rule.json,高于内置规则。
问题在「第一个匹配的条目胜出」,而用户条目的默认行为是替换系统规则,不是叠加。我拿同一个文件 src/api/app.py 量了三次:
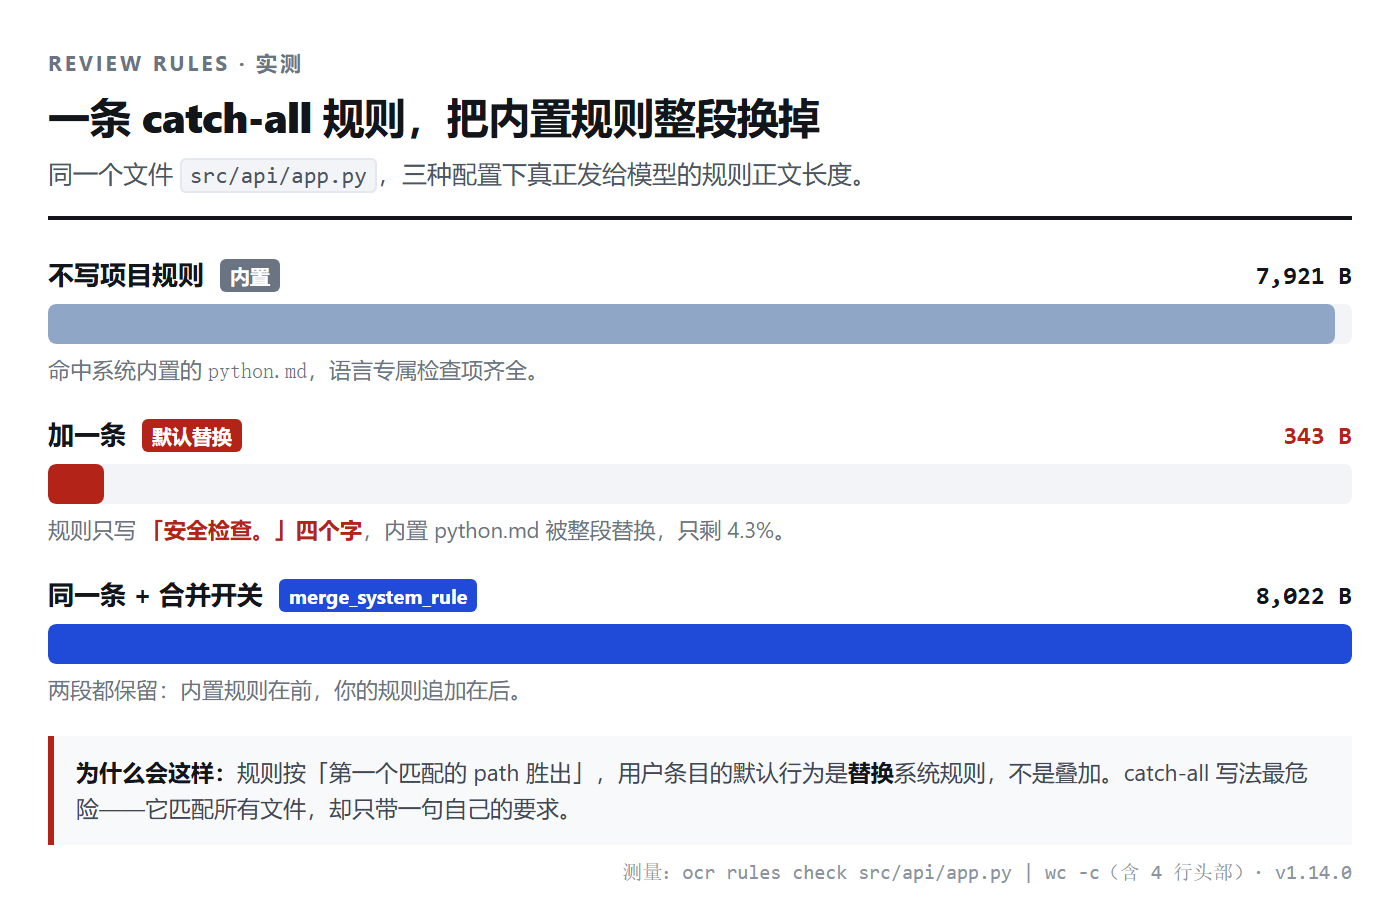
不写项目规则时,ocr rules check 输出 7,921 字节,命中的是内置 python.md;加一条 **/* 的规则、只写「安全检查。」四个字,输出掉到 343 字节;补上 merge_system_rule: true 才是 8,022 字节,两段都在。
正确写法是按目录写,不写 catch-all:
{
  "include": ["src/**/*.{ts,tsx,py}"],
  "exclude": ["**/generated/**", ".opencodereview/**"],
  "rules": [
    { "path": "src/api/**/*.py", "rule": "所有 handler 必须校验 path 参数,禁止把用户输入直接传给 open/exec。" },
    { "path": "**/pom.xml", "rule": "检查依赖版本是否与父 POM 冲突。" }
  ]
}两个附带细节:exclude 里记得加 .opencodereview/**,否则规则文件本身会被当成待审代码——我实测时它真的出现在「Will review」列表里;改完用 ocr rules check <file> 看哪一层胜出,别猜。
它到底审哪些文件:六道闸门与三个静默结果
装好模型后第一件反直觉的事:你改的文件,它不一定看。我在测试仓库里同时改了 4 个文件,ocr review --preview 的输出是:
Will review (2):
  [M]  src/api/app.py       +4    -0
  [M]  web/index.ts         +1    -1

Excluded from review (2):
  [M]  data.csv             (unsupported_ext)
  [M]  web/index.test.ts    (default_path)
CSV 不在扩展名白名单里,测试文件命中内置排除模式。想让它审 CSV,唯一办法是写进 include——我加了 {"include":["data.csv"]} 之后,待审文件从 2 个变成 4 个。
| 闸门 | 判据 | 你会看到什么 |
|---|---|---|
binary | 二进制文件 | 直接排除 |
secret_exclude | .ssh、.env、.npmrc 等敏感路径 | 排除,且 include 也改不了 |
user_exclude | 你写的 exclude | 优先于 include |
user_include | 你写的 include | 命中即保留,越过后两道 |
unsupported_ext | 扩展名白名单 | 报告 unsupported_ext |
default_path | 测试、fixtures、依赖目录 | 报告 default_path |
另外三个「静默」值得单独记:单文件 diff 超过 max_tokens(默认 200,000)的 80% 会被标 too_large 丢掉;--output result.json 写在仓库里,下次审查会把结果文件当代码审;--preview 不花 token 也不出评论,适合放进 pre-commit 先看范围。
放进 CI:绿灯也可能是假的
核心命令就一条,--audience agent 让 stdout 只留 JSON:
ocr review --from origin/main --to origin/feat \
  --format json --audience agent > result.json
配置是两套,别混着排查
本地 ocr config provider 写的是 providers.<name>;官方 GitHub Action 与 GitLab CI 模板写的是 llm.*(OCR_LLM_URL、OCR_LLM_AUTH_TOKEN、OCR_LLM_MODEL;直连时 token 叫 OCR_LLM_TOKEN,模板里叫 OCR_LLM_AUTH_TOKEN),而且 OCR_LLM_URL 要填完整端点,示例里带着 /chat/completions。
本机有 config.json 时,环境变量不生效
我实测:先写一份 ~/.opencodereview/config.json,再设三个 OCR_LLM_* 环境变量,请求仍然发到配置里的 dashscope;把 config.json 移走,环境变量才接管,失败时重试了 6 次、耗时 14 秒。自托管 runner 上最容易踩——上一份配置留在 home 目录,CI 里设什么都没用。
退出码 0 不等于审过
| 现象 | 退出码 | 该看哪儿 |
|---|---|---|
| 审完,0 条评论 | 0 | 可能真没问题,也可能文件全被过滤 |
| 没有可审文件 | 0 | JSON 里是 "status": "skipped" |
| 预算内部分审查 | 0 | manifest.coverage.failed 里的 failed(budget) |
| 配置错、超时、provider 报错 | 1 | 所有子任务都失败,先跑 ocr llm test |
还有两条硬要求:范围模式要找 merge-base,GitHub 的 checkout 必须 fetch-depth: 0,GitLab 要 GIT_DEPTH: 0,浅克隆会直接报 Cannot find merge-base;想进 GitHub 的 Security 面板就用 --format sarif 再交给 upload-sarif,但 --preview 不支持 SARIF。
常见翻车报错与急救清单
| 报错或现象 | 原因 | 处理 |
|---|---|---|
no valid LLM endpoint configured | 没配 provider;或只有订阅 | 走路线一配 key,或走路线二用 delegate |
401 invalid_api_key | key 错、没额度 | ocr llm test 单独验,别和 review 混着排查 |
404 / model not found | model 名写错 | 对照厂商文档里的模型 ID,本地不校验 |
all N file review(s) failed: network error | 端点不通、没走代理 | 换 base url;它默认重试 6 次,别以为是卡死 |
Cannot find merge-base | 浅克隆 | fetch-depth: 0 或 GIT_DEPTH: 0 |
| 「Will review」里没有你要的文件 | 命中 unsupported_ext、default_path 或 too_large | --preview 看原因,用 include 拉回 |
| 自己写的规则没生效 | 被更高优先级的层覆盖 | ocr rules check <file> 看 Source 与 Pattern |
| 内置规则好像变少了 | 用户条目默认替换系统规则 | 加 merge_system_rule: true |
| 委托模式几乎不报问题 | Low 直接丢弃,20 个 PR 里 8 个零评论 | 当清单用;要召回换原生 |
| CI 绿灯但没有评论 | skipped、全被过滤或预算 partial | 看 status 与 coverage.failed |
| 结果文件被自己审 | --output 落在仓库内 | 输出到仓库外,或加进 exclude |
什么情况下别用 ocr
- 只有订阅、又要求高召回:直接用 Claude Code 的
/code-review。同模型下它找到 36/97,ocr 委托模式 15/97。 - 指望它做架构级重构建议:它偏精确率,Low 直接丢弃,设计层面的问题基本不报。
- 代码不能出网:ocr 会把 diff 和工具读到的文件内容发给模型;本地模型要支持 native tool calls,小参数模型经常不按格式调工具,最后表现为「一条评论都没有」。
反过来,如果你的场景是「有国产模型 key、仓库里 Java/Go/MyBatis 混着、想把审查规则按目录固化下来」,ocr 原生模式是目前比较省事的一条:规则可调,CI 里能出 SARIF,本地也能只跑 --preview 不花钱。站内另有两篇可以配着看:《AI 写的代码不敢直接合并:照抄 Claude Code 团队验证三件套》讲的是「谁来判断能不能合并」,《1572 行函数交给 AI 拆成 150 行》讲的是「测试全绿为什么还不够」。
你接的是哪家国产模型?卡在哪一步、报的什么错?把 ocr llm test 的输出贴到评论区,我帮你对。
登录后可点赞、收藏与反馈。