AI证明黎曼猜想获Lean社区认证:175187个模块零错误
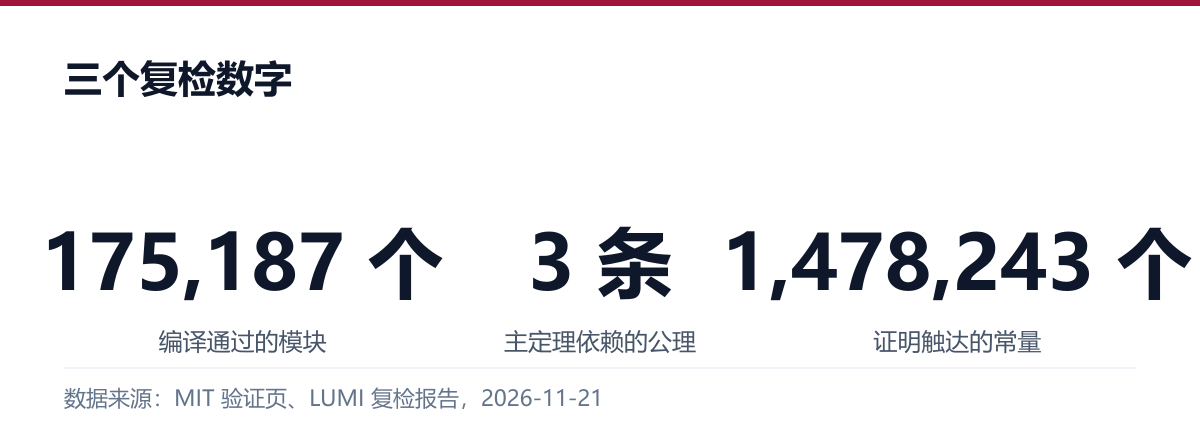
Lean 与 Mathlib 社区 11 月 21 日认证 Alpöge 的黎曼猜想证明:175,187 个模块零错误,五个主定理只用三条标准公理。本文拆解复检到底查了什么、哪些仍无法由机器保证,并给出自己复核的命令。
11 月 21 日,Lean 与 Mathlib 社区发布联合声明,认证 Levent Alpöge 的黎曼猜想证明「陈述与证明均正确」。复检数据很硬:175,187 个模块零错误,五个主定理只依赖 propext、Classical.choice、Quot.sound 三条标准公理。形式化这一关基本走完;剩下的问题不是代码,而是按 Alpöge 自己估计超过 25 万页的论证,还没有人类可读的版本。
这次认证,到底认证了哪几层?
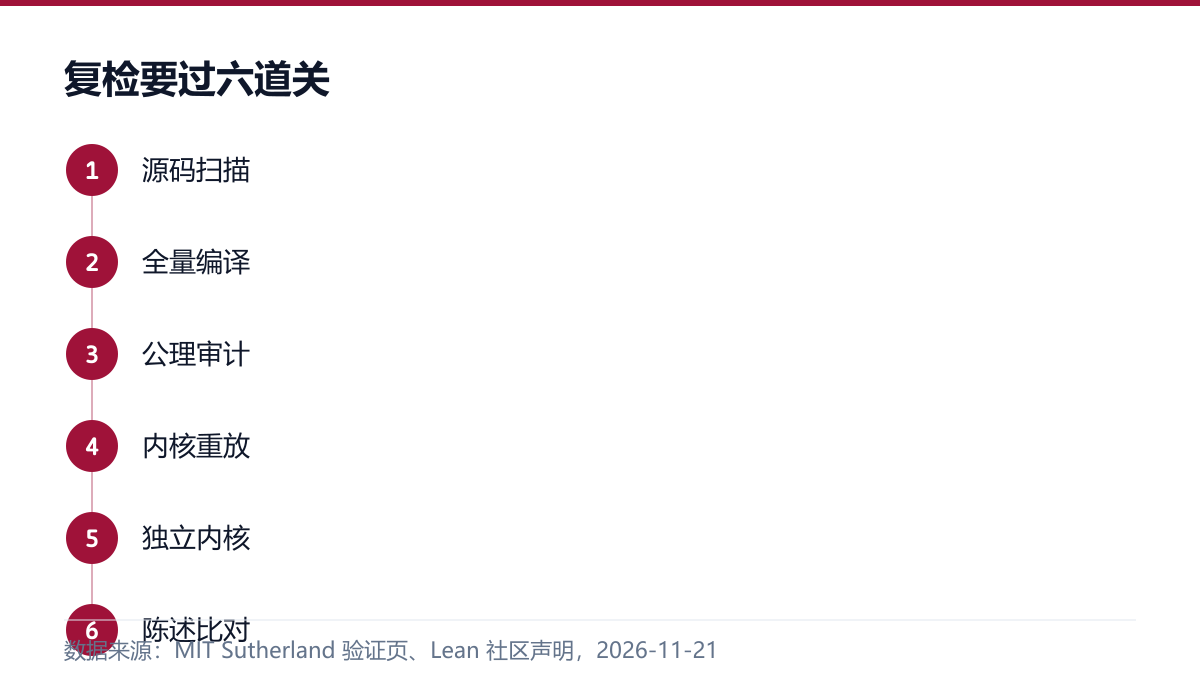
认证分四层:定理陈述用的是 Mathlib 原有的黎曼猜想定义,没有被替换成弱化版;175,187 个模块全部编译通过;两套独立工具比对后,确认代码证明的就是这条陈述;导出的证明又被多个独立内核接受。编译只检查推理步骤,不检查命题是不是原题;公理审计只查有没有偷用假设,不查定义是否符合数学惯例。四层都过,形式化意义上的「证明成立」才成立。
先看清单。MIT 的 Andrew Sutherland 把复检拆成编译、公理、内核重放、独立内核、陈述比对;芬兰 LUMI 超算上的另一组复检,独立跑了一遍构建和依赖审计。两边数字对得上。
| 检查项 | 结果 | 关键数据 | | --- | --- | --- | | 全量编译 | 通过 | 175,187 个模块,0 错误 | | 公理审计 | 通过 | 仅 propext、Classical.choice、Quot.sound | | 内核重放 | 通过 | 175,187 个模块,0 拒绝 | | 独立内核 | 接受 | nanoda 27 分 42 秒(80 线程);con-leche 3 分 15 秒(64 线程) | | 陈述比对 | 通过 | comparator 与 con-leche --compare,五个定理 | | Mathlib 一致性 | 通过 | 8,322 + 378 个 .olean 逐字节一致 |
公理审计还确认,环境里 15 条公理全部来自 Lean 的 Init,没有项目自建公理。lean4lean 也逐模块过了 175,187 个,其中 5 个要调高默认步数上限才通过。这类细节说明复检不是「跑通一次就完事」,而是把编译、公理、内核、陈述分别对了一遍。
最容易被忽略的是陈述比对。代码能编译,只能说明每一步在 Lean 里成立;还要确认它证明的命题就是黎曼猜想,而不是一个改过定义的近亲。社区新增了一个只导入 Mathlib 的文件,把陈述单独拎出来,再用 comparator 和 con-leche --compare 两套工具与提交的定理比对。Lean 社区声明说,这两套工具都确认「代码里的定理正是 Mathlib 的黎曼猜想陈述」。
LUMI 的依赖审计给了一个更细的旁证:riemannHypothesis 的陈述只触达 4,981 个常量,其中 4,183 个来自 Mathlib、792 个来自 Lean 核心、6 个来自 Batteries,项目自己写的常量是 0。另外四个定理各自多两个项目常量,也就是 Statements.lean 里的那几条定义。换句话说,要知道「证的是什么」,几乎只需要读 Mathlib 的定义和这四条声明。
形式化验证也不是第一次进入这类新闻:此前 Claude 就做过费马大定理的形式化(站内记录)。
为什么 175,187 个模块要跑一夜?
因为体量,也因为 Linux 的两个默认限制:内存映射数量,以及单模块导入依赖占用的内存。源码 175,187 个文件、983 MB;导出的证明压缩后 7.7 GB,解压 61.5 GB。LUMI 上第一次构建,前 94% 的 164,776 个模块在 8 个节点上花了 48 分钟,最后 6% 花了约 3 小时。
卡住的不是算力,是内存映射数量。Lean 会把每个导入文件映射一次,单是 import Mathlib 就要约 52,000 个映射;Linux 默认 vm.max_map_count 是 65,530,于是任何传递导入超过约 12,000 个项目的模块都会报 failed to read file '….olean',文件本身没坏。受影响的有 8,974 个模块,包括 Main。LUMI 没有 root,最后的办法是预加载一个小 shim,让 Lean 改读小文件,而不是映射。
内存也一样:靠近导入树顶端的模块,光导入依赖就要 5–6 GB 私有内存;按核数调度会把 256 GB 的节点跑到 OOM。LUMI 的复检一共用了约 3,500 核时,其中真正编译约 900 核时,其余花在重试和调参上;718 次尝试因基础设施原因失败,没有一次是 Lean 报错。
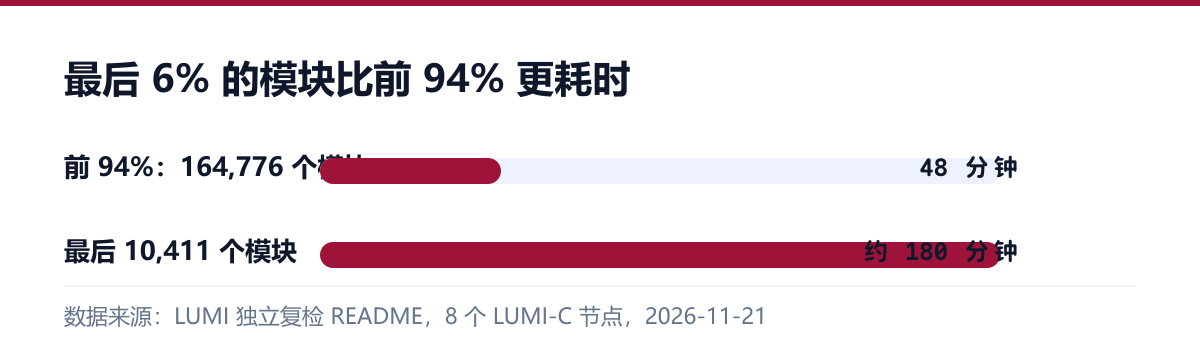
这也是「自己跑一遍」的第一道门槛:不是命令难,是环境参数和内存。
编译通过之后,还差什么?
至少还差三样:代码依赖的定义、被证明命题的范围,以及人类对论证的理解。这三样机器都替不了。
定义这一层,形式化证明的正确性建立在 Mathlib 对 riemannZeta、DirichletCharacter.LFunction 的定义上。社区说这些定义经过 Lean 与数论专家审过;复核者仍应自己读 Statements.lean 里的四条定义,因为它们决定了「黎曼猜想」在代码里到底指什么。
范围这一层更值得说清。这里的 GRH 指 Dirichlet L 函数:所有模数、所有特征;Dedekind zeta、Hecke L 函数、一般自守 L 函数都不在被检查的陈述里。媒体标题里的「广义黎曼猜想」很容易让人以为范围更大,实际不是。
理解这一层,Lean 社区的原话是「期待数学界解释这份证明里的新想法」;LUMI 的报告也写明,全套检查「不能证明有人理解了论证」。25 万页、1700 万行,没有任何人类可读的论文版本;按说明里的说法,冲刺阶段 Claude 把 Alpöge 甩在了后面。机器认证的是正确性,不是可读性。
一个可以对照的旁证是算术推论:把这份证明与另一份独立的 Robin 判据形式化(kimihiro64/Robin1984)合在一起,能得到两条不含 zeta 的定理——Robin 不等式与 Lagarias 不等式,且同样只依赖三条标准公理。这说明证明确实能推出可检验的算术结论,但它仍然不能替人解释「为什么」。
同一天公开的人类手稿,为什么被挑出问题?
另一条线在同一天出现:一份纯人类手稿被公开,约 8 小时后就被指出有问题。它的处境和 AI 版正好相反。
11 月 20 日,美国数学会主席 Ravi Vakil 在博客挂出 Alessandro Masullo 的广义黎曼猜想草稿,强调「全部由人完成,没有 AI」。Brian Conrad 已经看了几个月,反馈正在并入,Vakil 转述的判断是「目前看起来不错」。原计划是让 Conrad 与 Masullo 再打磨一年、给足够多人看过再宣布;现在等不及了。
大约 8 小时后,Vakil 更新:好几个人联系他,报告了草稿里的问题,其中一些是用不同 AI 模型辅助找出来的。他补了一句,所有问题都要解决到社区满意,这份证明才会被接受;他对证明策略的正确性不作判断。
这条线容易被读成「人类输了」,但现在下这个结论太早。草稿是仓促公开的,Conrad 对 Scientific American 说它「正在大改」;它还没有被任何人完整验证。倒是有个更实际的观察:AI 既能短时间内生成一份可机器验证的证明,也能在几个小时内帮人挑出一份人类手稿的毛病——两种能力都在改变数学研究的流程。
此前这份 AI 声明刚出时,本站记录过那份 4 页说明与 239 MB 的 Lean 归档:当时还没人编译,能核对的只有陈述和构建参数。一天之后,最关键的机器检查已经做完,争议从「代码能不能过」移到了「数学界能不能读懂」。
想自己复核,怎么跑?
最短路径是用 con-leche 做陈述比对;想跑完整检查,再用 Comparator。两条路都不需要重新编译 175,187 个模块。
以下是 Sutherland 页面给出的命令,需要 Lean v4.36.0;Comparator 约需 100 GB 内存、70 GB 磁盘,con-leche 约需 50 GB 内存。
# 1) 解压官方导出的证明与陈述
zstd -d --long=30 solution.ndjson.zst
zstd -d --long=27 challenge.ndjson.zst
sha256sum solution.ndjson challenge.ndjson

# 2) 完整比对(约 100 GB 内存、70 GB 磁盘)
lake comparator --config comparator.json \
  --challenge-from-export challenge.ndjson \
  --solution-from-export solution.ndjson

# 3) 更轻的独立检查:con-leche(约 50 GB 内存)
git clone https://github.com/leanprover/con-leche && cd con-leche
git checkout compare
lake build con-leche
.lake/build/bin/con-leche --compare challenge.ndjson solution.ndjson
如果只想做人工初筛,先打开 src/Statements.lean,确认写的是 Mathlib 的 riemannZeta 与 LFunction,而不是某个弱化版本;再对主定理跑 #print axioms riemannHypothesis,看是否只出现那三条公理。这一步不需要编译全部 175,187 个模块。
边界与不确定性
先说结论:这次认证有明确边界,超出边界的部分仍是未知。下面几条决定了这份证明能被引用到什么程度。
- 这次认证的是「形式化陈述在 Lean 与 Mathlib 的定义下成立」,不是「人类已经理解这套证明」。LUMI 的报告明确说,依赖计数「不能说明哪些部分是新的数学」。
- 范围仅限 Dirichlet L 函数;Dedekind、Hecke、自守 L 函数不在内。
- 结论依赖 Mathlib 对 zeta 与 L 函数的定义、四条 Statements.lean 声明,以及 Lean 内核与各独立检查器的实现。con-leche 与 con-ron 自带相对于集合论的正确性证明,降低了「内核有 bug」的风险,但没有消除「定义不符合数学惯例」的风险。
- 截至 Sutherland 页面最后一次更新,lake comparator 的端到端内核阶段与 Lean paranoid 内核仍在跑;社区声明已依据已完成的比对给出认证。后续如有变化,以验证页为准。
- 人类手稿那条线更不确定:草稿在大改,公开公告里没有列出具体问题,不能据此判断 Masullo 的证明成立或不成立。
- 构建数字来自 8 个 LUMI-C 节点与 MIT 的云机器,换机器、换路径会变;.olean 哈希还依赖绝对路径,98,219 个文件嵌了构建目录,跨路径只能比不嵌路径的那部分。MIT 那组构建没有沙箱、用 lean 直接调用而非 lake build;LUMI 那组把每个 lean 进程放进无网络沙箱,两组方法不同,但结论一致。
登录后可点赞、收藏与反馈。