torch.xpu 返回 False:八个原因逐条验证
同一个 False 可能来自驱动、运行时、wheel 来源、Python 标签、设备选择器、容器透传、WSL 节点或用户组。按从内核到 Python 包的顺序给八条验证命令,每条都能单独定性。
torch.xpu.is_available() 只回一个布尔值,它把所有失败原因压成了同一个 False。可能是 wheel 里没有 XPU 后端,可能是驱动没到基线,也可能是容器里没有设备节点——这三种情况的修法完全不同。
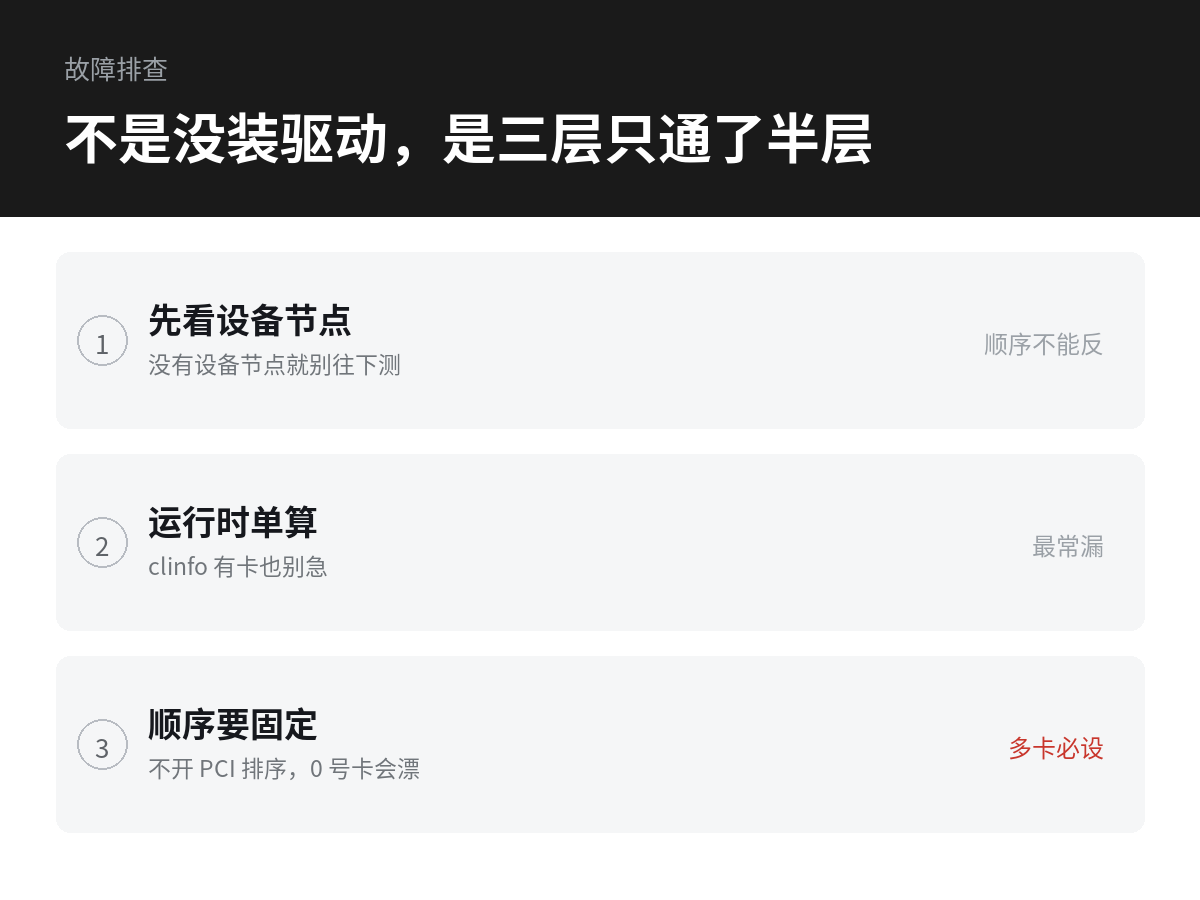
这篇给八个原因,每个配一条验证命令。顺序按「从下往上」排:先确认设备在系统里存不存在,再确认运行时能不能看见它,最后才怀疑 Python 包。反过来查会浪费很多时间,因为装错 wheel 的人往往也在同一台机器上装了错的驱动。
一个前提:按 PyTorch 2.15 的文档,Intel 客户端 GPU 的支持范围是 Windows 11、Ubuntu 24.04/26.04,以及 WSL2 里的 Ubuntu 24.04/26.04。WSL 不再是「不支持」,而是「少装一个用户态运行时就会 False」。
先分清三层,False 才有意义
第一层是内核态驱动。Windows 上是显卡驱动包,Linux 上是 i915 或 xe 加对应固件。这一层不通,任何用户态程序都看不到设备。
is_available() 之所以什么都不说,是因为它在实现上是一次设备枚举加一次上下文创建,任何一步返回错误码都会被吞掉,只留下布尔结果。真正的错误码要去运行时那一层拿:装了 oneAPI 的机器用 sycl-ls,只装了驱动的机器用 xpu-smi discovery。
sycl-ls 2>&1 | head -20
xpu-smi discovery
初始化失败时常见的行是 PI_ERROR_DEVICE_NOT_FOUND 和 UR_RESULT_ERROR_UNINITIALIZED,这两句比 False 有用得多:前者是设备没暴露,后者是驱动与运行时版本对不上。
第二层是用户态运行时。Intel 拆成了两个东西:Level Zero loader(libze_loader、ze_loader.dll)和计算运行时(libze-intel-gpu1 一类)。PyTorch 的 XPU 后端走 Level Zero,不走 OpenCL。
第三层才是 PyTorch 自己。官方 XPU wheel 把 SYCL 运行时和 oneAPI 的一部分库打在 torch/lib 里,所以 pip 装完不需要 source setvars.sh。Intel 的前置条件文档写得很直接:用 pip wheel 时不要 source 那些脚本,否则版本冲突。
这三层的验证命令不一样,混用会得出错误结论。比如 clinfo -l 能列出设备,只证明 OpenCL 栈通,不证明 Level Zero 通;sycl-ls 能列出设备,才说明 Level Zero 这条路是通的。
还有一个时序问题:torch.xpu 的设备池在第一次调用时初始化,结果缓存在进程里。这意味着你中途改了环境变量、装了运行时、加了组,在同一个 Python 进程里重试不会变。所有验证都要新开解释器,Jupyter 要重启内核。
八个原因,按出现频率排
原因一:驱动低于基线
症状是 torch.xpu.is_available() 为 False,同时系统里根本没有任何 Intel GPU 计算设备。
Windows 侧的基线是 32.0.101.9033 WHQL 或更高,这是 Intel 为 PyTorch 2.15 验证过的版本。这条要求还有附加条件:安装包必须包含 LevelZeroSDK 组件,否则 torch.compile 会失败。驱动装得再新,缺这个组件一样出问题。
# Windows
Get-CimInstance Win32_VideoController | Select-Object Name, DriverVersion
# Linux,有 xpu-smi 时最直接
xpu-smi discoveryxpu-smi discovery 能列出 Device Name、Driver Version、Memory 才算第一层通过。命令不存在说明驱动或工具包没装全。
Windows 上有两个来源在打架:Intel 官网的通用驱动和 OEM 厂商的定制驱动。通用包更新快,但会拒绝安装在不在白名单里的机型;OEM 包能装,版本常年落后。判断标准不是「哪个更新」,而是 DriverVersion 是否达到 32.0.101.9033。达不到就必须换来源,靠等 Windows Update 没有意义。
Linux 上看内核这一层是否正常:
dmesg | grep -Ei 'i915|xe ' | tail -20
ls /dev/dri/
/dev/dri 下必须有 renderD128。只有 card0 没有 renderD*,说明设备被识别成显示控制器但没挂上渲染节点,通常是固件缺失或内核太旧。
Linux 上还有一条分岔:Arc Pro B50/B60/B65/B70 这类卡可以走 Intel OMIX,一个包把驱动和运行时都带上,不需要单独装驱动;A 系列、B 系列消费卡和 Core Ultra 核显走传统路线,需要 Client GPU 驱动加 Intel Deep Learning Essentials。走错路线会得到一个「设备在、但 PyTorch 不认」的中间状态。
原因二:只有驱动,没有运行时
这一层最容易被跳过,因为设备管理器里显卡是正常的,游戏也能跑。
Windows 的显卡驱动自带 Level Zero,一般不会缺。Linux 不是:内核驱动只负责把设备暴露成 /dev/dri/renderD128,用户态还要有 Level Zero 的 loader 和 Intel 的 GPU 运行时。缺了它们,/dev/dri 在,PyTorch 依然 False。
clinfo -l                 # 看 OpenCL 这一层有没有设备
ls /usr/lib/x86_64-linux-gnu/libze_loader.so*   # 看 Level Zero loader 在不在
clinfo -l 有输出但 torch.xpu.is_available() 仍为 False,说明 OpenCL 装了、Level Zero 没装全。这两个是并列的栈,不要互相证明。
想直接看 wheel 里的 XPU 库缺哪个依赖,用 ldd:
python -c "import torch, os; print(os.path.dirname(torch.__file__))"
ldd $(python -c "import torch,os;print(os.path.dirname(torch.__file__))")/lib/libtorch_xpu.so | grep 'not found'
有 not found 就是运行时缺库。wheel 自带 SYCL 运行时和 loader,但 Intel GPU 的用户态驱动(libze_intel_gpu 一类)来自系统,不随 pip 包分发。所以「pip 装完就万事大吉」在 Linux 上不成立。
WSL2 里这条是主要原因。官方给的安装组合是:
sudo apt update
sudo apt install -y libze1 libze-intel-gpu1 intel-opencl-icd clinfo libze-dev intel-ocloc
装完再跑 clinfo -l,应该能看到 Intel 设备。宿主机不需要在 WSL 里装 Linux 内核驱动,Windows 驱动负责把 GPU 暴露给客机。
原因三:wheel 装错了来源
PyPI 上的 torch 默认是 CUDA 版或 CPU 版,pip install torch 在没有额外 index 的情况下不会给你 XPU 后端。这是最高频的一条。
python -c "import torch; print(torch.__version__, torch.version.xpu)"torch.version.xpu 是 None,就是装错了。正确来源只有一个:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/xpu装完版本号通常带 +xpu 后缀。如果之前装过 CUDA 版,先 pip uninstall torch torchvision torchaudio 再装,不要靠 --upgrade 覆盖:文件名相同,pip 有时会判定已满足。
conda 环境里还有一个隐蔽情况:pip 指向了 user site-packages,而 python 用的是环境内的解释器。表现是 pip show torch 显示 XPU 版,import torch 加载的却是另一份。用 python -m pip 可以消除这个歧义,前面加 python -c "import torch; print(torch.file)" 确认实际加载路径。
还有一个反向的坑:为了装 XPU 版去 source /opt/intel/oneapi/setvars.sh,然后在这个环境里跑 Python。环境变量会把 LD_LIBRARY_PATH 指到 oneAPI 自带的库,和 wheel 里打包的版本打架,表现是 import 成功但 is_available() 为 False,或者直接段错误。用 wheel 就不要 source。
原因四:Python 版本与 wheel 标签不匹配
pip 的 wheel 文件名里有 cp310、cp311 这样的 ABI 标签。解释器主次版本对不上,pip 要么装不上,要么回退去编译源码,最后得到一个没有 XPU 的包。
python -c "import sys; print(sys.version_info[:3])"
pip debug --verbose | grep -i 'cp3'
pip debug --verbose 会打印当前环境接受的标签列表。如果列表里没有你下载的 wheel 对应标签,说明这个 wheel 不是给你这个解释器编的。
判定方法比记版本号可靠:装的时候如果 pip 开始下载 .tar.gz 而不是 .whl,基本就已经走错了。XPU 版只在专用 index 上以 wheel 形式分发,PyPI 上没有;pip 回退到源码编译时,默认编出来的是 CPU 版。
pip install --only-binary=:all: torch --index-url https://download.pytorch.org/whl/xpu加 --only-binary=:all: 可以让它在没有匹配 wheel 时直接报错,而不是悄悄去编译。
用 uv 的项目要注意它默认读 pyproject.toml,index 配置写在 [[tool.uv.index]] 里,和 pip 的 --index-url 不是一回事。配置漏了,uv 会从 PyPI 拿默认 torch,装完同样是 False。uv pip list 只看包名不看来源,用 uv pip show torch 里的 Location 和版本后缀判断。
原因五:设备被环境变量过滤掉了
ONEAPI_DEVICE_SELECTOR 是 SYCL 的设备过滤器,PyTorch 的 XPU 后端也受它影响。它常被上一个项目的脚本 export 到 shell 里,之后一直生效。
# Linux
echo "$ONEAPI_DEVICE_SELECTOR"
:: Windows
echo %ONEAPI_DEVICE_SELECTOR%输出非空且不是 level_zero:* 时,先清掉再测:
unset ONEAPI_DEVICE_SELECTOR
python -c "import torch; print(torch.xpu.is_available(), torch.xpu.device_count())"
Remove-Item Env:ONEAPI_DEVICE_SELECTOR这个变量的语法是 level_zero:0、level_zero:1、level_zero:0;level_zero:1 这类形式。值写错或指向不存在的索引时,枚举结果会直接变空。它也解释了另一种现象:is_available() 是 True,但 device_count() 是 1 而不是 2。
双显卡机器上还能用它做隔离验证:只保留独显的索引跑一次,再只保留核显跑一次。两次都 True,说明两个设备都健康,问题在调度优先级;只有一次 True,坏的那张卡单独查驱动。
原因六:容器里没有设备节点
容器默认看不到宿主机的 /dev/dri。只映射端口不映射设备,容器里的 PyTorch 一定 False。
docker run --rm -it --device=/dev/dri ubuntu:24.04 ls -l /dev/dri没有 renderD128 输出,就是没透传。完整的启动参数需要设备、组权限和运行时三样:
docker run --rm -it \
  --device=/dev/dri \
  --group-add $(getent group render | cut -d: -f3) \
  your-image python -c "import torch; print(torch.xpu.is_available())"
镜像里还要有 Intel 的 GPU 用户态驱动。官方 PyTorch 镜像不一定带,用 intel/oneapi-base 或按 Intel 的容器说明自己装一层更稳。直接把宿主机的库挂进去是权宜做法,版本一升级就会断。
--group-add 的数字要现算,不能写死。不同发行版、不同安装顺序分配的组 ID 都不一样,换台机器就失效。compose 里没有命令替换,只能把数字写进 group_add,所以这份配置天然不可移植。
这一条和原因一的区别:容器里 xpu-smi discovery 也可能失败,但失败原因是看不到设备,不是驱动版本旧。先在宿主机上确认 xpu-smi 正常,再进容器查。
原因七:WSL2 少一个 /dev/dxg
WSL2 的 GPU 透传不走 /dev/dri,走 /dev/dxg。这个节点由 Windows 驱动创建,宿主机驱动不对就没有。
ls -l /dev/dxg
clinfo -l
/dev/dxg 不存在时,先更新 Windows 侧的 Intel 驱动,再 wsl --shutdown 重启发行版。节点存在但 clinfo -l 没有 Intel 设备,是客机里的用户态运行时没装,回到原因二的那条 apt 命令。
WSL2 里还有一个容易忽略的点:不要在客机里装 Linux 内核态 GPU 驱动。装了反而会和 /dev/dxg 打架。WSL 的模型是「宿主驱动 + 客机用户态」,和裸机是反的。
版本也要对。PyTorch 2.15 验证过的是 WSL2 里的 Ubuntu 24.04 和 26.04,更老的 20.04 不在列表里。uname -r 显示的是 WSL 内核版本,与宿主 Windows 的版本是两套东西,升级宿主不会自动换 WSL 内核,必要时用 wsl --update。
原因八:当前用户不在 render 组
裸机 Linux 上,/dev/dri/renderD128 的属组是 render,权限是 crw-rw----。不在组里的人能看见文件、打不开设备,表现出来就是 False 而不是报错。
id -nG
ls -l /dev/dri/renderD128
sudo usermod -aG render $USER
sudo usermod -aG video $USER改完必须重新登录。newgrp render 只对当前 shell 生效,图形会话、systemd 服务、IDE 里的终端各自独立,逐个处理比重启便宜。
/dev/dri/renderD128 的属组由 udev 规则分配,正常发行版都会给 render 组。如果 ls -l 显示属组是 root 而权限是 crw-------,那是 udev 规则被改过或容器运行时动过权限,usermod 解决不了,要修规则。
两个让修好的环境再坏掉的变更
第一种是驱动回退。Windows Update 会在某些机型上把 Arc 驱动换成一个更老的 WHQL 版本,DriverVersion 掉回 32.0.101.6xxx 之后,is_available() 直接变 False。表现为「上周好好的」。查 Get-WinEvent 里的驱动安装事件,或者直接比对版本号。
第二种是 pip install -U 把 torch 换成默认源。项目里只要有一次不带 --index-url 的升级,XPU 版就会被 CUDA 版覆盖,而且 pip 不会提示。可行的办法是在 requirements 里写死 torch==2.15.0+xpu 并配 --extra-index-url,或者干脆用 constraints 文件锁住。
版本对应关系不要凭记忆
Intel 的验证矩阵是按 PyTorch 版本钉死的,混搭会出各种「能 import 不能算」的问题。
| PyTorch | Linux 运行时(Deep Learning Essentials) | OMIX |
|---|---|---|
| 2.15 | 2026.1.3 | 0.4.0 |
| 2.14 | 2026.1.2 | 0.3.0 |
| 2.13 | 2026.0.0 | 未提供 |
Windows 侧的对应物是 Deep Learning Essentials for Windows 2026.1.3.20(离线安装包)。这张表只对 Intel 官方验证过的组合成立,自己升运行时不会得到更好的兼容性。
用 pip 安装官方 wheel 时,这张表里的运行时其实由 wheel 的依赖带入,不需要手动装。它真正约束的是「从源码构建」和「用 OMIX 整包」两条路,混用两种来源才会踩到版本错配。
一次跑完八项的自检脚本
排查到最后,用一段脚本把三层信息一次性打出来,比逐条试快。
import os, sys, subprocess
import torch

print("python:", sys.version.split()[0])
print("torch:", torch.__version__, "xpu build:", torch.version.xpu)
print("selector:", os.environ.get("ONEAPI_DEVICE_SELECTOR"))
print("available:", torch.xpu.is_available(), "count:", torch.xpu.device_count())
if torch.xpu.is_available():
    for i in range(torch.xpu.device_count()):
        p = torch.xpu.get_device_properties(i)
        print(f"xpu:{i}", p.name, round(p.total_memory / 1024**3, 1), "GiB")
for cmd in ("xpu-smi discovery", "clinfo -l"):
    try:
        print(subprocess.run(cmd.split(), capture_output=True, text=True, timeout=20).stdout[:800])
    except FileNotFoundError:
print(cmd, "-> not found")| 现象 | 指向 | 先查 |
|---|---|---|
torch.version.xpu 为 None | wheel 来源 | 原因三 |
| xpu 版本正常但 available False | 运行时或设备 | 原因一、二 |
| available True、count 为 0 | 设备过滤 | 原因五 |
| 容器内 False、宿主机 True | 透传或组权限 | 原因六、八 |
| WSL 内 False | /dev/dxg | 原因七 |
| 换 Python 版本后 False | ABI 标签 | 原因四 |
怎么确认已经修好
不要只看 is_available() 变 True。跑一次真实计算,确认结果落在 GPU 上:
import torch
a = torch.randn(1024, 1024, device="xpu")
b = a @ a
torch.xpu.synchronize()
print(b.device, b.dtype, b.sum().item())
能跑完且 b.device 是 xpu:0,才算通。跑之前先 torch.xpu.empty_cache() 清一次,能排除上一轮失败留下的残留分配。
只想验证推理链路的话,用同一套环境跑一个 HF 模型比跑矩阵乘更有说服力;ComfyUI 这类出图工具对显存的要求另算,可以先看配置与显存的对应关系。
如果只是想在 Intel 卡上跑 GGUF 模型而不写 Python,torch.xpu 这条路可以直接跳过,改用 Vulkan 或 SYCL 后端更省事,KoboldCpp 的版本选择里有一份按后端分的对照。显存够不够装模型,用这张按参数量分档的表先估一遍,能省掉一半「装完才发现跑不动」的返工。
登录后可点赞、收藏与反馈。