文心 5.5 Flash:同档全胜,旗舰只赢办公
文心 5.5 Flash Preview 把 8 项基准的对手拆成同档与旗舰两组:对同档 8 比 0,对旗舰只赢办公三项。输出价闲时折后每百万 Token 2 元,一小时 1.44 元。
百度 11 月 11 日发布文心 5.5 Flash Preview:2800 亿总参数、每个 Token 只激活 140 亿、100 万 Token 上下文,输出价每百万 Token 8 元并限时五折。
官方发布图一并给了 8 项基准、7 个对手。把对手按「同档」和「旗舰」分成两组重算之后,结论比看总分有意思得多。
一、2800 亿里只跑 140 亿
文心 5.5 Flash Preview 总参数量 2800 亿,每个 Token 激活 140 亿。折算下来激活比例 5%,即 20:1 的稀疏度。
这个比例在国产 MoE 里算激进。作为对照,站内记录的蚂蚁百灵 Ling-3.2-flash 是 560B 总参、激活 25B,比例约 4.5%,两者处在同一档稀疏水平。
官方给的三项底层技术是混合稀疏注意力架构、多路由器 MoE、ECHO 多 Token 预测。三者指向同一个目标:把百万级上下文带来的计算与显存开销压下来。
还有一处值得单独提。百度称首次引入自研 RSI 技术,由 ERNIE Evolve 参与模型推理优化,也就是让模型参与自己的研究与调优。发布稿没有给出这部分的量化收益。
二、八项基准的对位账
官方发布图列了 8 项基准,每项 7 个模型。直接看排名容易得出「中游」的印象,换成对位比较,结论立刻分层。
| 对位组 | 胜负 | 主要差距项 |
|---|---|---|
| GLM-5.3-Flash(同档) | 8 胜 0 负 | 八项全部领先,最小差 0.4 分 |
| DeepSeek V4.1 Flash(同档) | 5 胜 3 负 | 输在 DeepSWE、APEX-Agents、命令行 |
| Claude Opus 5.5(旗舰) | 3 胜 5 负 | 只赢表格、知识问答与自动化 |
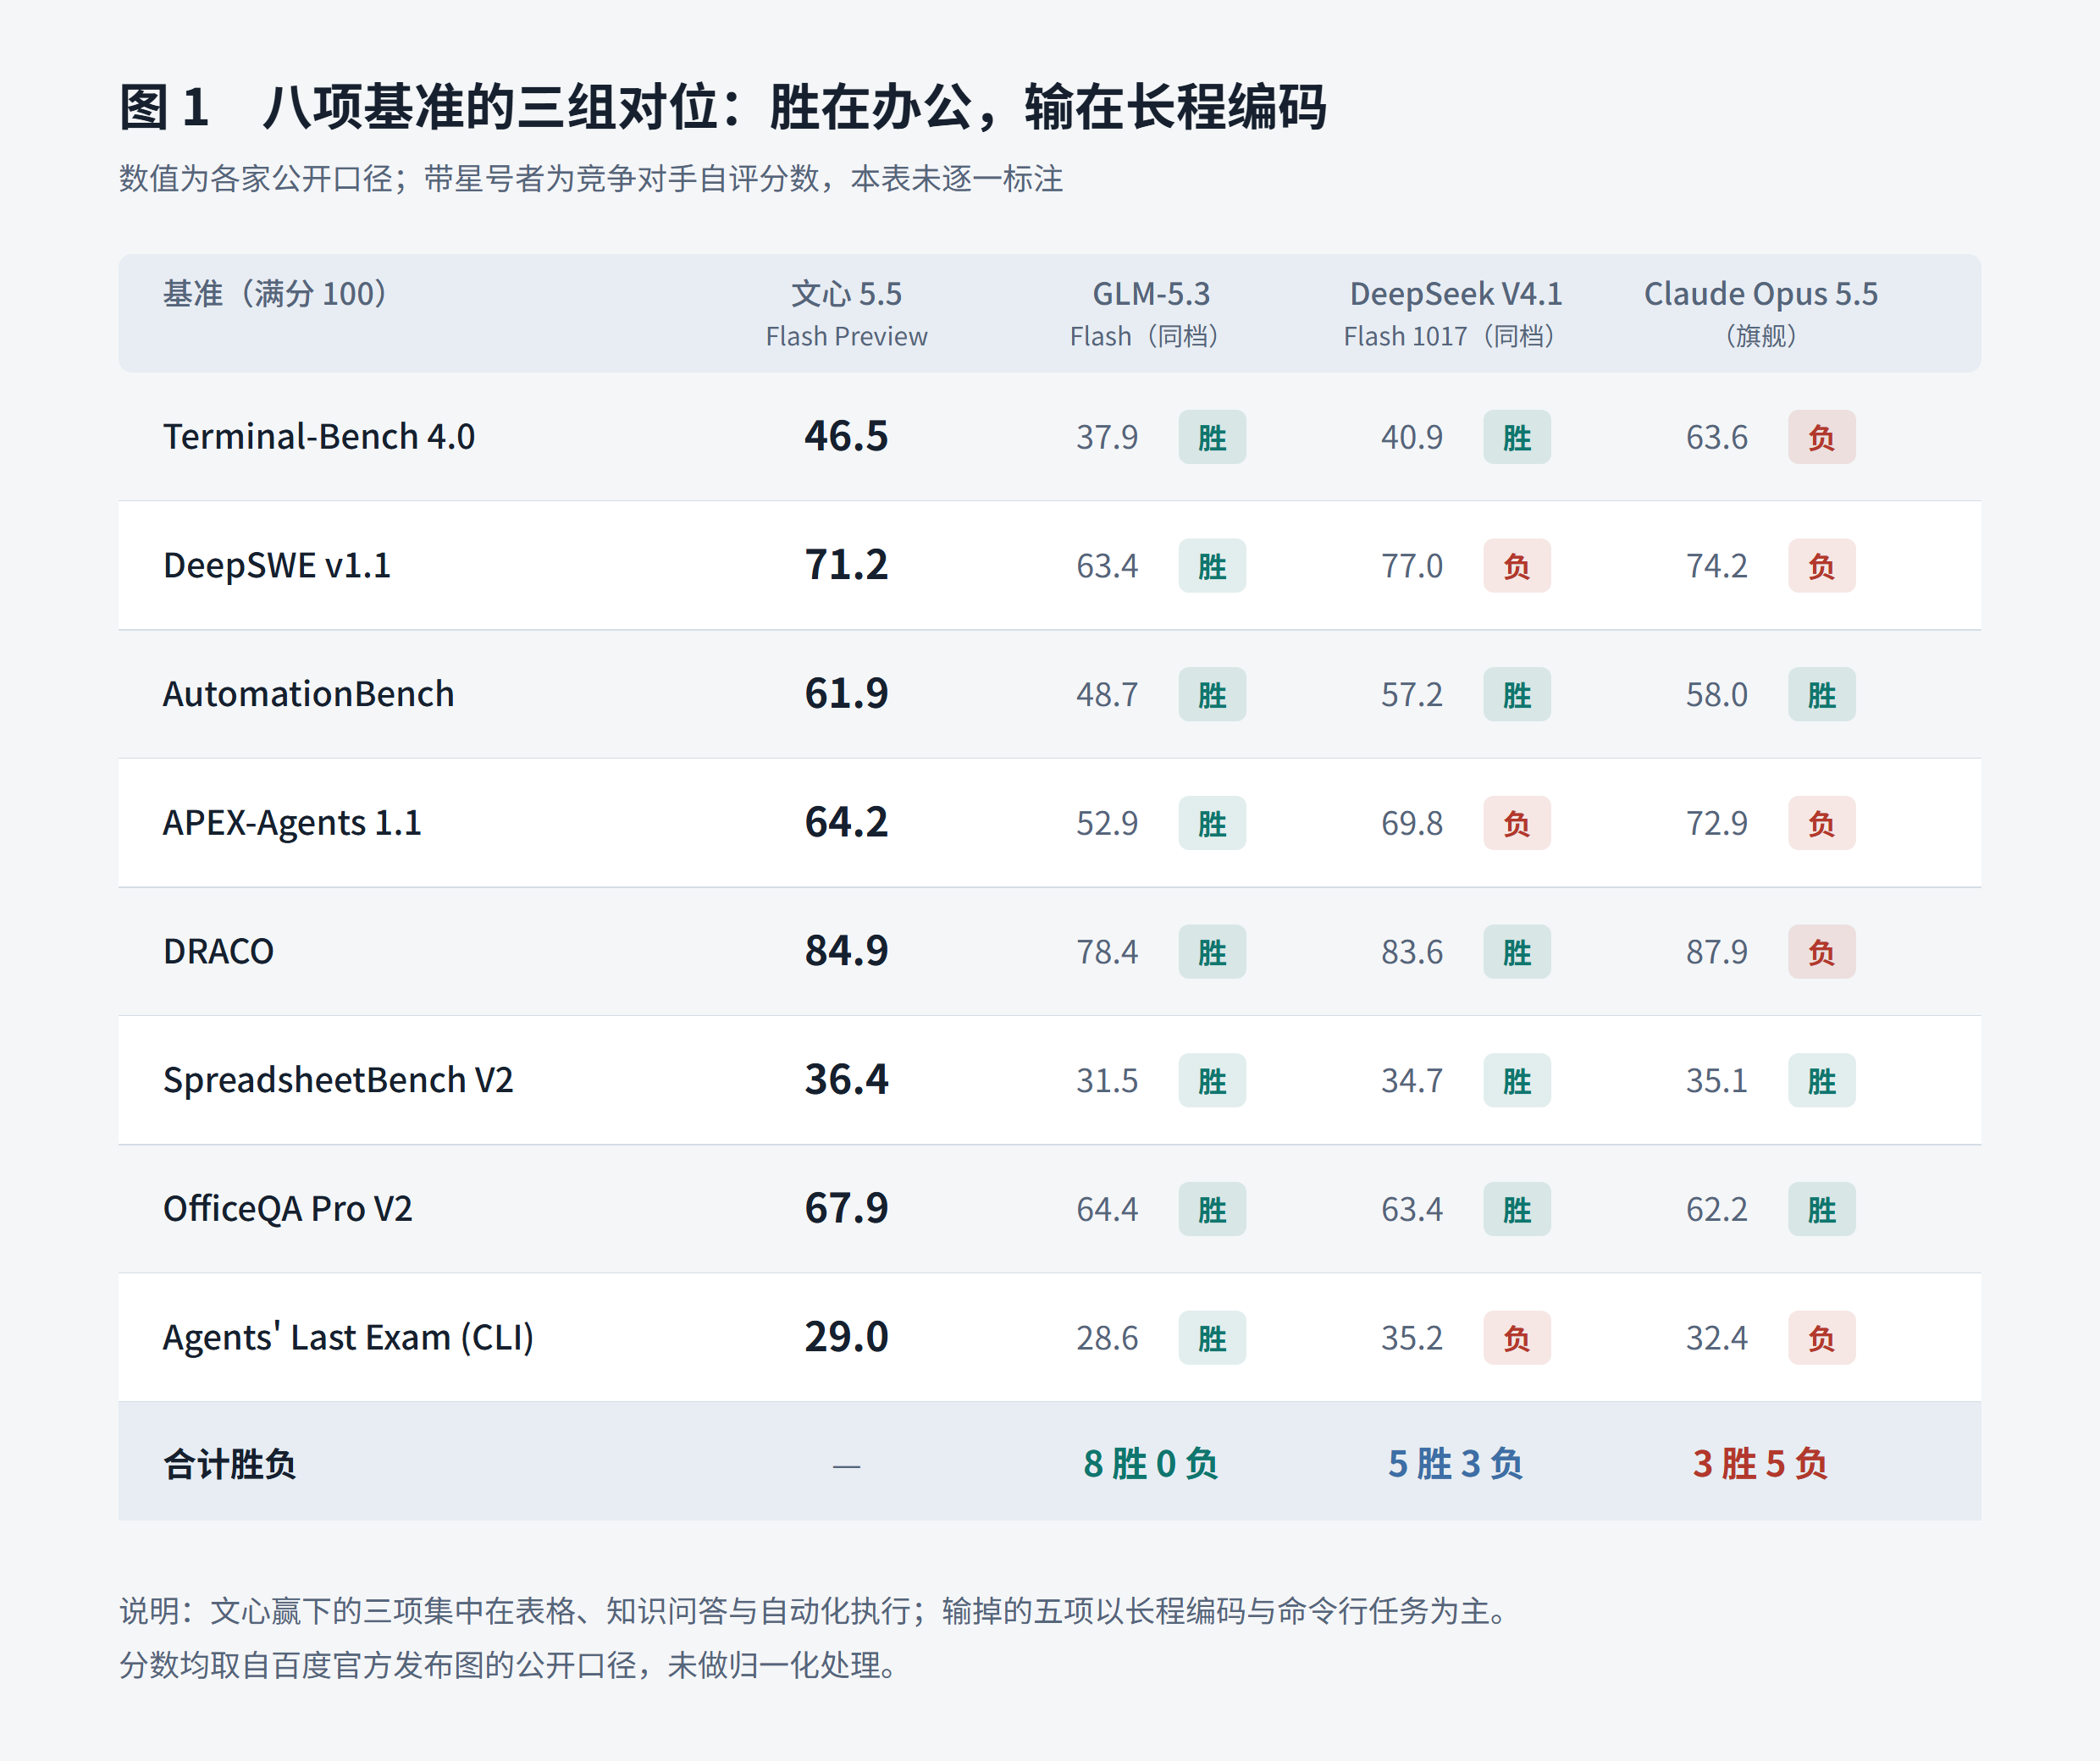
对 GLM-5.3-Flash 的 8 比 0 是最干净的一组:八项里没有一项落后,但最小领先幅度只有 0.4 分(Agents' Last Exam 的 29.0 对 28.6),说明同档模型的能力区间已经高度重叠。
赢的三项,都在文档与表格里
AutomationBench 61.9 对 58.0、SpreadsheetBench V2 36.4 对 35.1、OfficeQA Pro V2 67.9 对 62.2,分别领先 3.9 分、1.3 分、5.7 分。
其中 SpreadsheetBench 的 1.3 分不建议当成稳定优势,它落在同类评测多次采样的波动范围内。
输的五项,是长程编码与命令行
Terminal-Bench 4.0 是 46.5 对 63.6,差 17.1 分;Agents' Last Exam 的 CLI 子项是 29.0 对 32.4,差 3.4 分。前者是全部 8 项里最大的单点差距。
这与「Flash 档」的定位并不矛盾:它优化的是单位成本下的吞吐,而不是极限能力。但发布稿把这些分数与旗舰并列在同一张图里,容易被读成同代对标。
还有一处口径要说明。图注写明带星号的分数是「自评」,而文心自己那一列没有星号、对手列里多数带星。谁自评、谁第三方,这张图并没有对齐,横向比较时应先扣除这层差异。
三、价格:闲时折后输出 2 元
模型已上线百度智能云千帆,开发者可通过 API 调用。定价按忙闲时两档,均为每百万 Token,现阶段限时五折。
| 计费项 | 忙时原价 | 忙时五折 | 闲时原价 | 闲时折后 |
|---|---|---|---|---|
| 输入 | 2 元 | 1 元 | 1 元 | 0.5 元 |
| 输出 | 8 元 | 4 元 | 4 元 | 2 元 |
折后输出 2 元,是忙时原价的四分之一。这个差额不需要换模型、不需要改代码,只需要换调度时间。
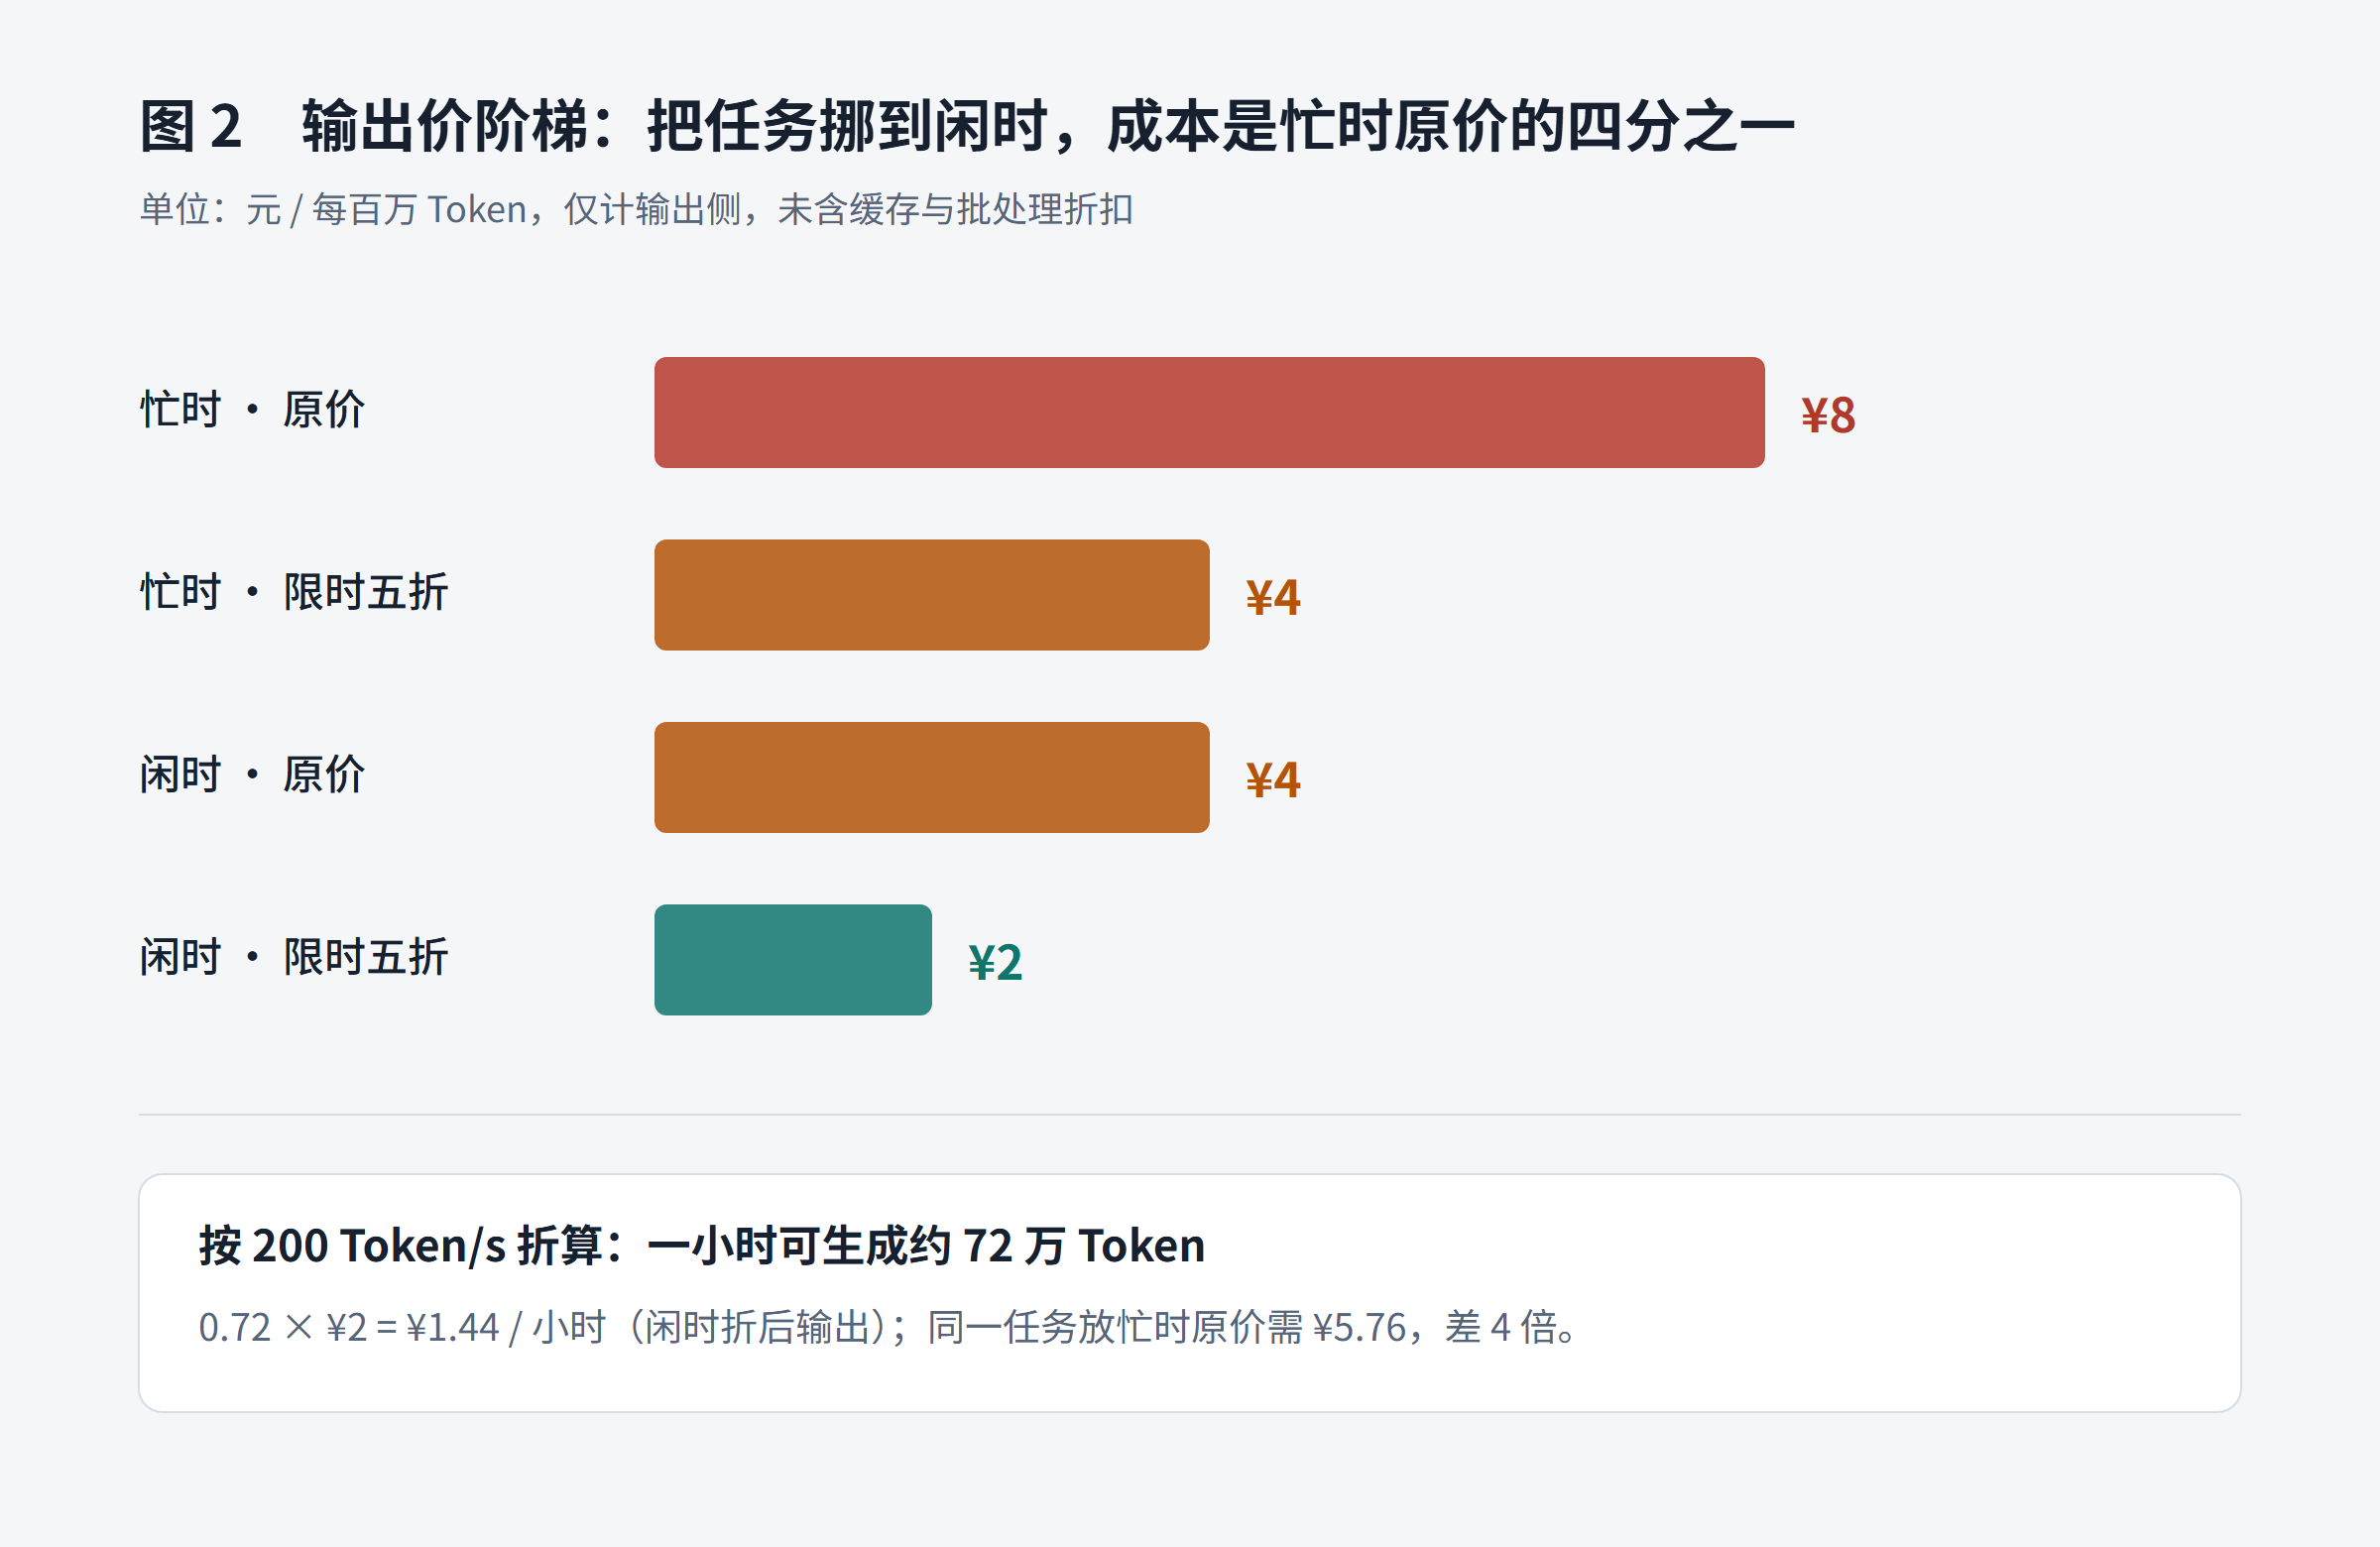
按官方给的 200 Token/s 折算,一小时可生成约 72 万 Token。乘以闲时折后的 2 元,单小时输出成本 1.44 元;同一份产出放在忙时原价,是 5.76 元。
对批量任务来说,这是一条零改造的降本路径:把离线评测、语料清洗、批量出稿挪到闲时,成本直接落到四分之一。作为横向参照,Gemini 4 Carbon 的 2 美元输入价打的是另一条路线——靠低单价抢常规调用,而非靠时段调度。
另一条变量是权重。官方称模型权重将于 11 月 25 日面向全球开源社区发布,届时的许可条款决定它能否进入自托管场景。若许可放开,本地部署的显存档位就会成为新的成本约束。
四、四项没有交代的口径
发布稿的信息密度不低,但有四项关键条件没有交代。它们不构成缺陷判定,只是目前既无法证伪、也无法证成。
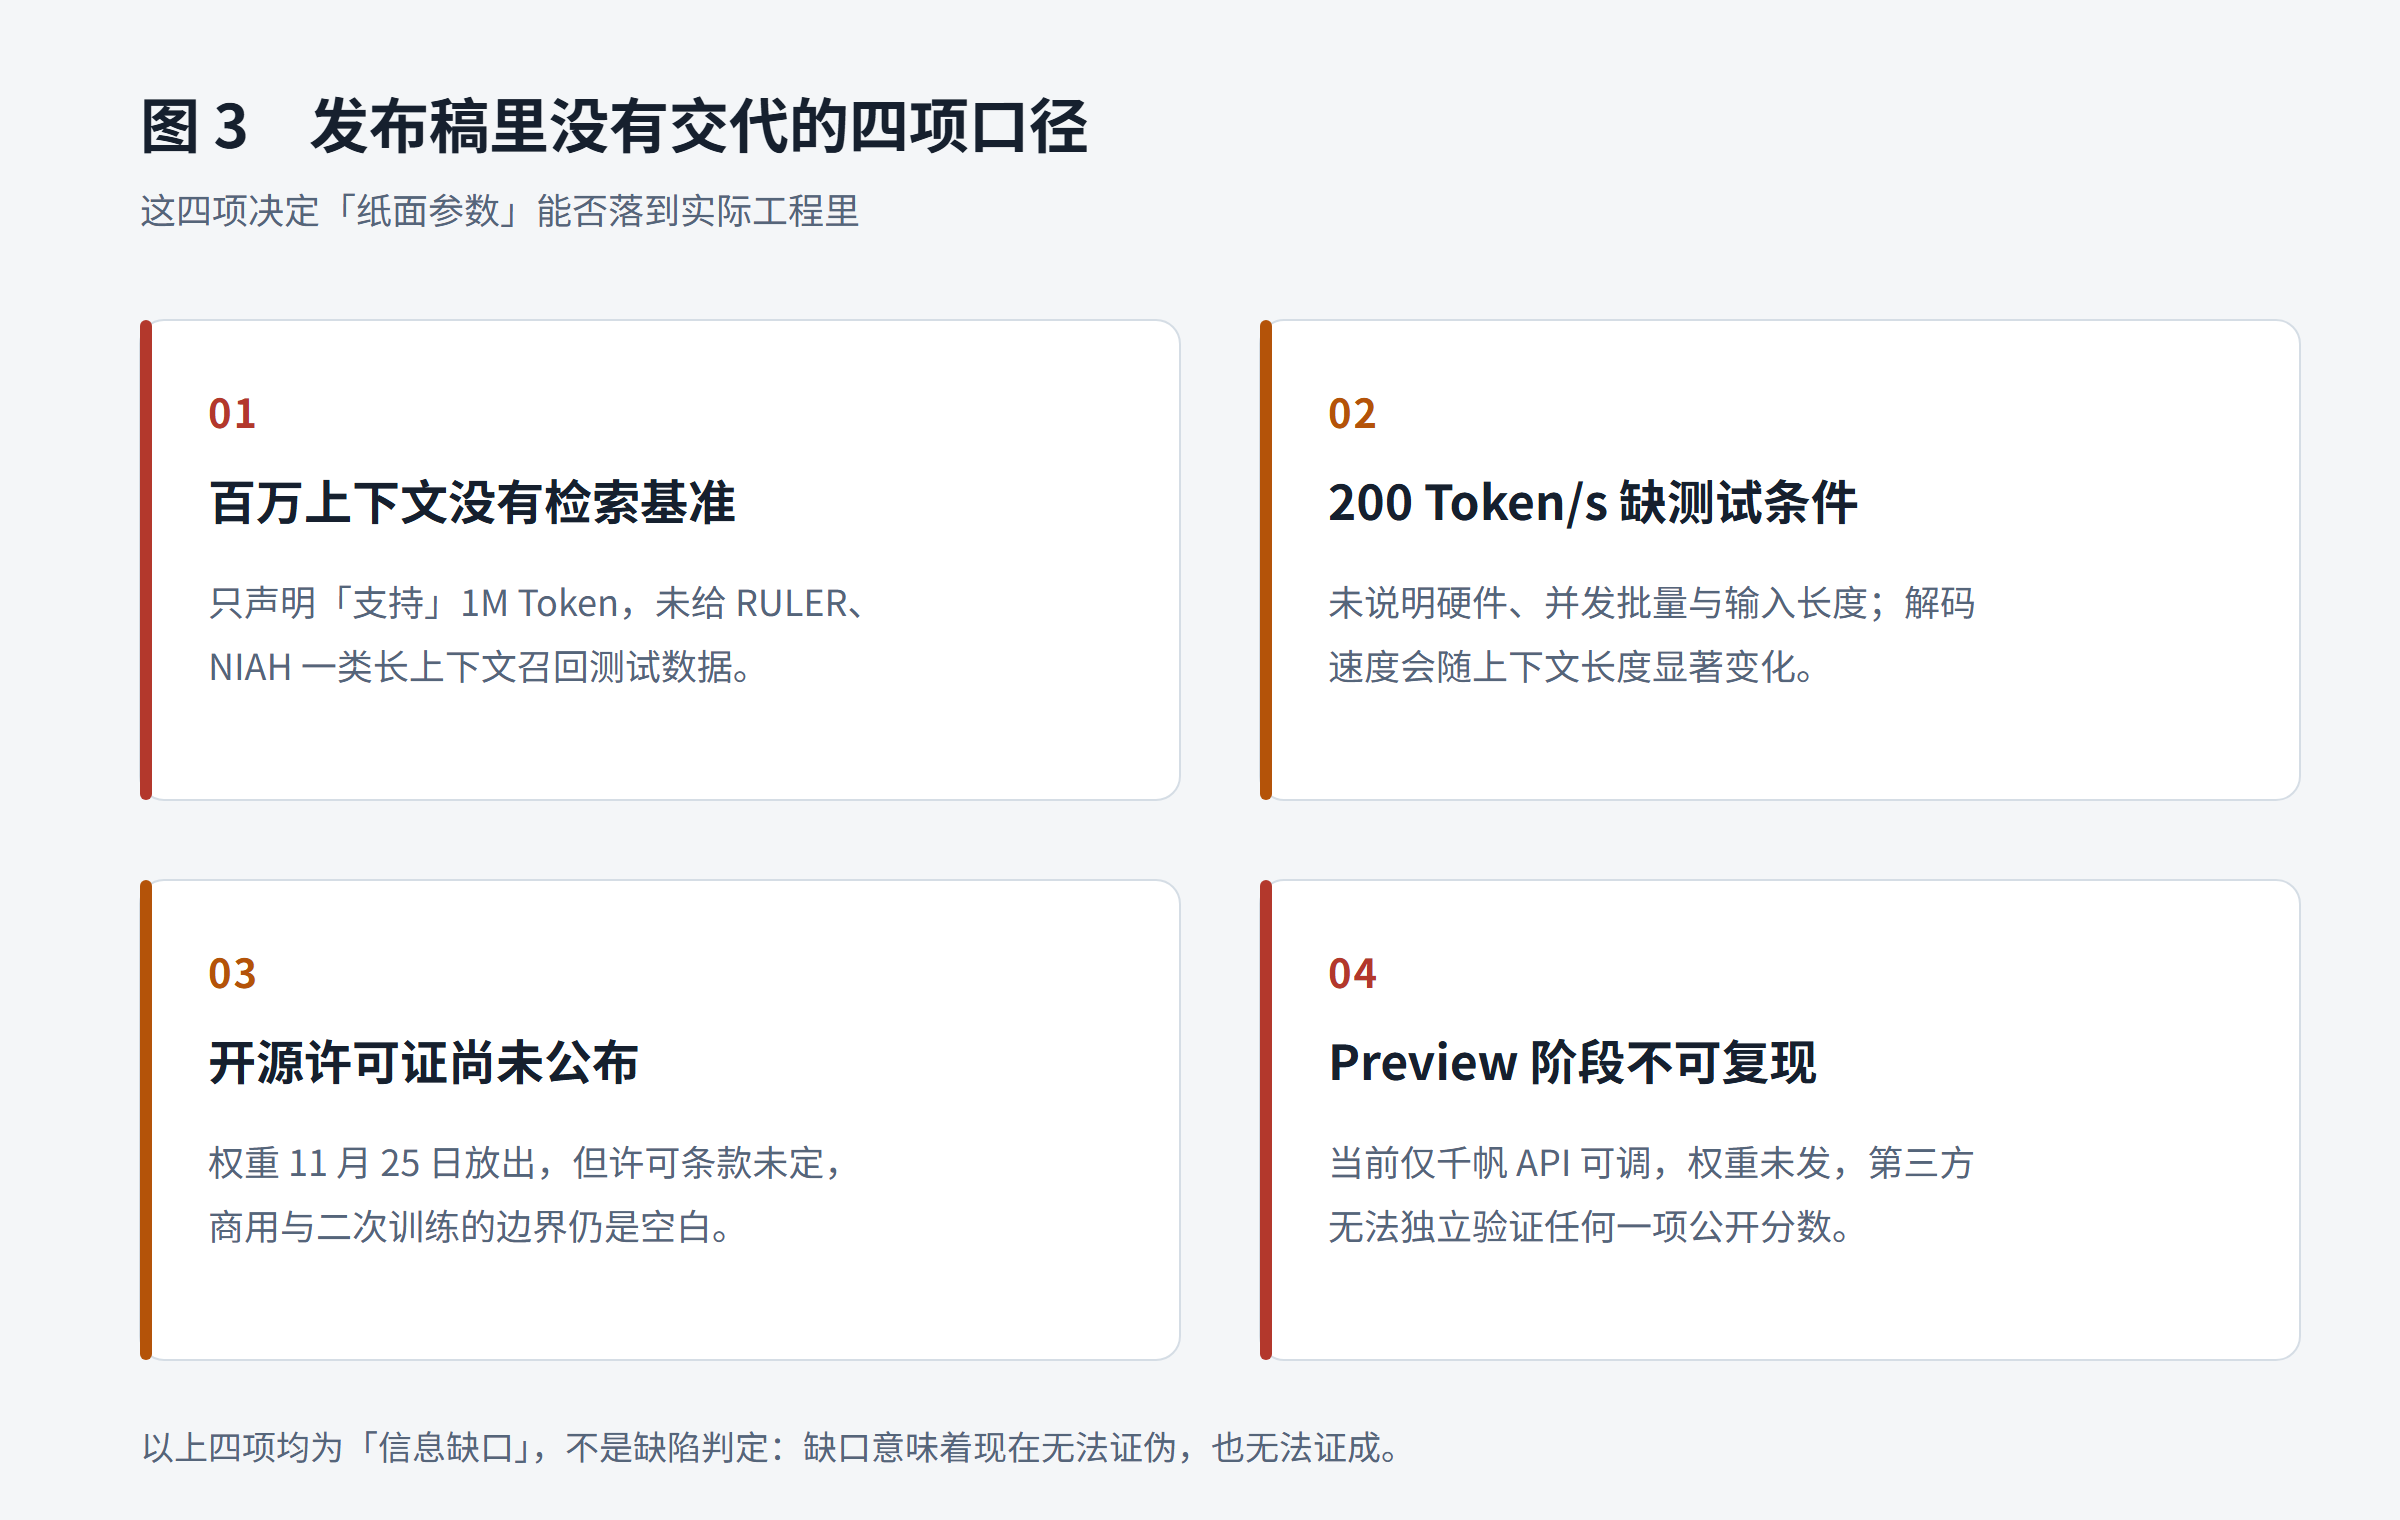
第一是长上下文的检索能力。官方只声明「支持」100 万 Token,没有给 RULER、NIAH 这类召回测试,标称上限与实际可用区间可能是两件事。
第二是 200 Token/s 的测试条件。硬件、并发批量、输入长度都没写,而解码速度对上下文长度极其敏感,脱离条件的单值很难复现。
第三是开源许可证。权重放出日期已经确定,条款未定,商用与二次训练的边界仍是空白,这直接影响企业选型。
第四是 Preview 阶段的不可复现性。当前只有千帆 API 可调,权重未发,第三方无法独立跑一遍那 8 项基准。
把三件事放在一起看:同档领先是真的,旗舰对标是错位的,价格是它的主要武器。需要在表格、报告、自动化流程里跑量的团队,这是一个划算的选项;需要长程编码与命令行任务闭环的场景,它暂时还不是。
登录后可点赞、收藏与反馈。