Qwen3.8-27B:24GB 能跑,262K 装不下
同一份开源权重,四种显卡算出四本账:权重 16.4 GB 装得下,262K 上下文的缓存却要 16 GiB。本文用 config.json 与实测日志,把权重、缓存、推理三笔成本拆开算。
Qwen3.8-27B 的 4-bit 量化文件只有 16.4 GB,一张 24GB 消费级显卡就能把它整个装进显存。但「装得下」和「用得上」是两笔不同的账。
原生 262,144 token 的上下文要另付 16 GiB 缓存。本文用官方 config.json、量化文件体积和三份实测日志,把权重、缓存、推理三笔成本分开算。
显存账本:权重 16.4 GB,上下文再要 16 GiB
Qwen3.8-27B 是 27.78B 参数的密集模型,不是 MoE,每个 token 都要跑完全部参数。权重以 Apache 2.0 发布,可商用、可微调。
量化后的体积分得很散。Unsloth 的 4-bit 文件从 14.3 GB 到 19.0 GB 不等;Ollama 默认的 27b tag 报 18 GB,由 17 GB 的 Q4_K_M 与 931 MB 的视觉投影器组成。
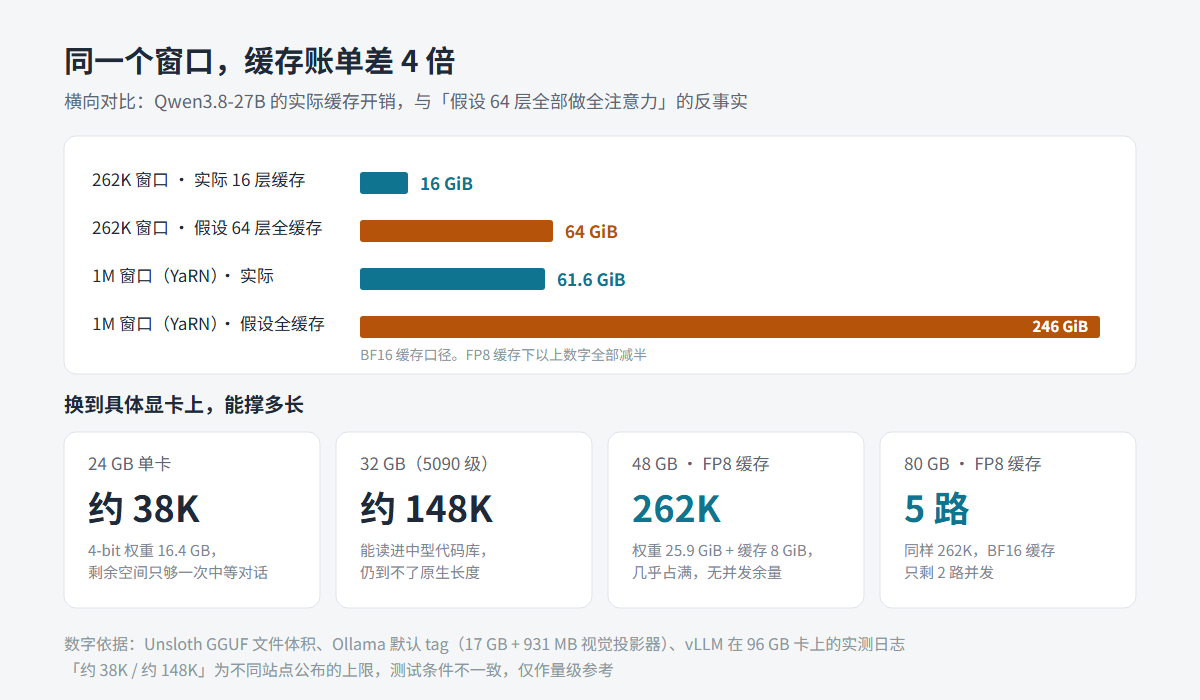
24GB 卡装完权重只剩约 7 GB。这点余量决定了实际能塞多长的上下文,实测约 38K token,大约是原生长度的七分之一。
显存不是唯一的门槛,但它是第一个。站内那份 Qwen3.8 27B 规格速查 列的是纸面参数,真正落地要先算清这一层。
| 显卡 | 权重格式与体积 | 留给缓存的余量 | 实测上限 |
|---|---|---|---|
| 24 GB | 4-bit,16.4 GB | 约 7 GB | 单路约 38K |
| 32 GB | 4-bit,16.4 GB | 约 15 GB | 单路约 148K |
| 48 GB | FP8,25.9 GiB | 约 11 GiB | 单路 262K,FP8 缓存占 8 GiB |
| 80 GB | FP8,25.9 GiB | 约 48 GiB | 262K 下 2 路或 5 路 |
以上是容量口径,不含吞吐。24GB 消费卡的经验生成速度在 15 到 30 tokens/s 之间。
缓存为什么只有四分之一
config.json 里有四个关键字段:64 层、full_attention_interval 为 4、4 个 KV 头、head_dim 为 256。
翻译过来:每 4 层一组,前 3 层是 Gated DeltaNet 线性注意力,只有 1 层是 Gated Attention 全注意力。全模型 48 层线性、16 层全注意力。
线性注意力的历史被压进固定状态,不随上下文增长;只有那 16 层会为每个 token 存一份 K 和 V。缓存被砍到四分之一,全部原因在这里。
算一遍:2(K 与 V)乘 4 个 KV 头乘 256 维乘 2 字节,单层每 token 是 4 KiB;乘 16 层得 64 KiB。填满 262,144 token,正好 16 GiB。
若换成 64 层全注意力,同一个窗口要 64 GiB。这就是「27B 模型必须上多卡」那句旧经验的来源,结构变了,经验就过期了。
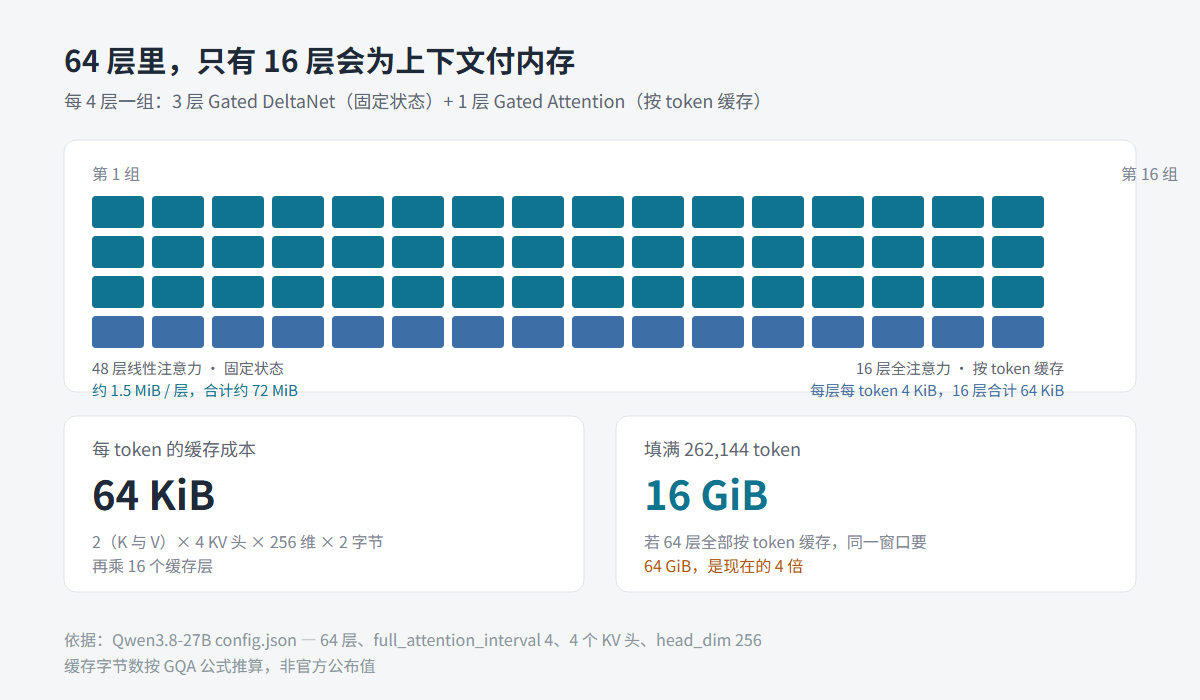
48 个线性层也不是零成本,只是成本固定:48 乘 128 乘 128 的状态约 1.5 MiB 一层,合计约 72 MiB,上下文再长也不再涨。
官方分数与独立排名,差在口径
官方发布的四项成绩:SWE-bench Pro 61.7、Terminal-Bench 2.1 73.0、GPQA Diamond 89.2、LiveCodeBench v6 90.3,均高于上代 Qwen3.6-27B。
提升最大的是智能体编码。DeepSWE 1.1 从 13.3 涨到 42.2,OSWorld-Verified 从 63.9 涨到 84.3,这两项对应的都是「能不能自己动手」的问题。
独立口径是另一幅画面。BenchLM 给 54.3 分(满分 100),在 216 个模型里排第 80;细分看,推理第 7(26 个)、智能体第 20(135 个)、通识第 88(179 个)。Vals AI 综合 48.5。
差异不奇怪,两组数字测的不是同一件事。官方挑长项公布,独立机构要的是跨模型可比。把它当两个刻度看,别拉到一个轴上。
| 指标 | 官方口径 | 独立口径 |
|---|---|---|
| SWE-bench Pro | 61.7 | 无同口径数据 |
| Terminal-Bench 2.1 | 73.0 | 无同口径数据 |
| GPQA Diamond | 89.2 | 无同口径数据 |
| 综合排名 | 未公布 | BenchLM 54.3 分,第 80 名(共 216) |
| 综合指数 | 未公布 | Vals AI 48.5 |
还有一处要说明:开源的是权重与推理代码,训练语料、训练配方、知识截止都没公开。这与 DeepSeek Harness 那类把运行层摊开的路线不同,可复现性只到推理这一层。
推理账本:21 分钟与 137 秒
模型默认开着思考,reasoning_effort 默认 xhigh。三个档位(low、medium、xhigh)之外,还能用 enable_thinking 直接关掉。
Simon Willison 在同一台 M5 Max(128 GB)上跑同一个 SVG 任务。xhigh 档耗时约 21 分钟,用掉 22,276 个推理 token 加 3,223 个输出 token。
关掉思考后,同一任务 137 秒完成,输出更简单,也没有可核查的中间步骤。差了 9 倍多,省下的是时间,付出的是过程可追溯性。
这就是本地部署真实的计价单位:云端按 token 收钱,本地按显存占用与等待时间收钱。权重的钱一次付清,推理的钱每轮都在付。
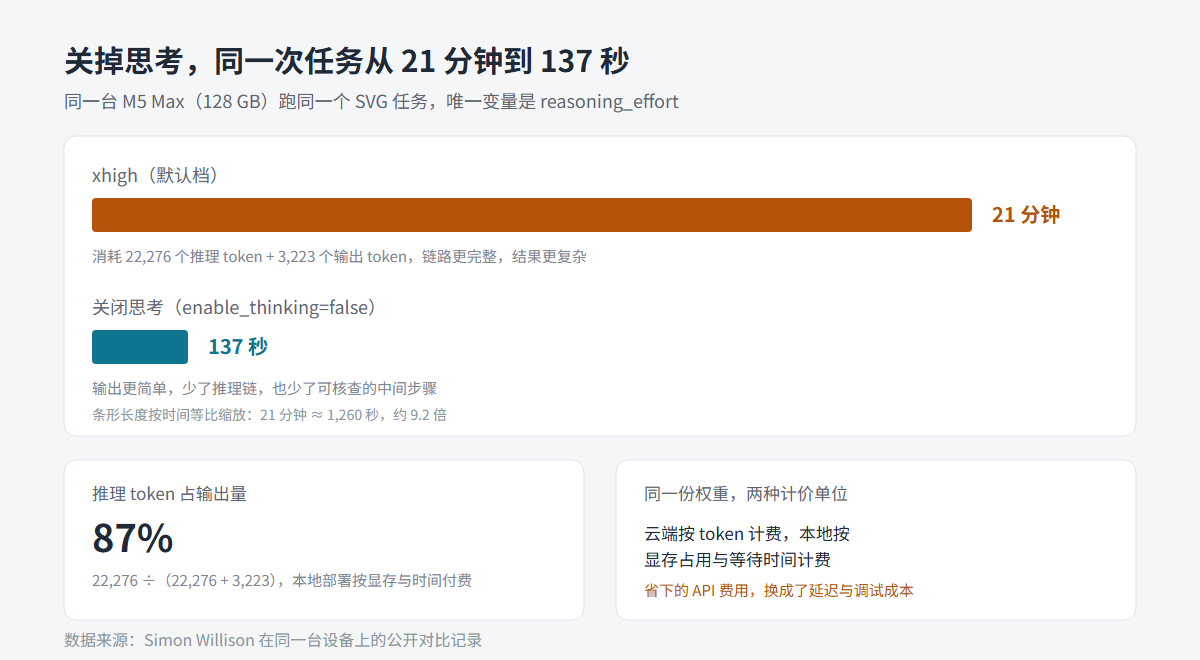
对消费级显卡的读者,这条曲线比跑分更能说明问题。更小的模型能在同样显存里留出更多上下文,面壁 MiniCPM-V 4.7 走的是另一条路:35B 总参、3B 激活,换手机端可用。
三条落地建议
一是先按上下文选卡,不要按权重选卡。24GB 够跑,但只够 38K;要 262K,48GB 是下限,且必须开 FP8 缓存。
二是服务端一定要设 max-model-len。vLLM 会预分配缓存,上限写 262,144 却只跑 32K 的请求,等于把大部分缓存预算锁死不用。
三是把思考档位当开关用。批量、结构化的任务关掉思考;需要中间步骤可核查的场景再开 xhigh,并预留十倍的时间预算。
登录后可点赞、收藏与反馈。