vLLM XPU 部署 OpenAI 兼容接口:完整命令与三个坑
从 wheel、源码、Docker 三条安装路径讲到起服务,逐项解释显存比例、最大长度、dtype 的真实含义,并拆解 Python 3.12 硬约束、模型架构与 dtype 不匹配、显存预留过高这三个高频失败点,附 curl 与压测口径。
vLLM 的 XPU 后端能起一个标准的 OpenAI 兼容服务,这一点没有疑问。有疑问的是它的口径有多窄:官方安装文档在 Intel XPU 一节里,把「支持基础模型推理与 serving」写在了开头,而不是写在脚注里。
这句话的份量在装的时候就能感觉到。Python 必须是 3.12,不是「建议」;模型能不能跑取决于它的架构和 dtype 有没有对应的 XPU 内核;显存参数的含义和 CUDA 版不完全一样,照抄教程会把服务卡在启动阶段。
下面按「装—起—坑—验证」走一遍,三个坑分别是 Python 版本、模型架构、显存预留。命令以 2026 年 vLLM 的 XPU 口径为准,涉及版本差异的地方会标出来。
装:三条路,各有一把锁
| 路径 | 适用 | 关键约束 |
|---|---|---|
| 预编译 wheel | 快速验证 | 需要两个 extra-index,且要 --index-strategy unsafe-best-match |
| 源码构建 | 改代码、定位性能回归 | VLLM_TARGET_DEVICE=xpu,triton 必须换成 triton-xpu |
| 官方镜像 | 生产部署 | vllm/vllm-openai-xpu,v0.26.0 起进入发布流水线 |
| Intel llm-scaler 镜像 | 多卡 Arc、要 INT4/FP8 | 官方标注「仅用于演示,非生产」 |
wheel 的装法要同时挂两个索引,少一个就会去 PyPI 拉 CUDA 版的 torch。
uv pip install vllm \
  --extra-index-url https://wheels.vllm.ai/nightly/xpu \
  --extra-index-url https://download.pytorch.org/whl/xpu \
  --index-strategy unsafe-best-match
源码构建多一步 triton 的替换。默认的 triton(无后缀)是给 NVIDIA 的,XPU 上误用它会导致正确性或运行时问题,官方原话是「must replace it with triton-xpu」。
git clone https://github.com/vllm-project/vllm.git && cd vllm
pip install -r requirements/xpu.txt
pip uninstall -y triton triton-xpu
pip install triton-xpu==3.7.2 --extra-index-url https://download.pytorch.org/whl/xpu
VLLM_TARGET_DEVICE=xpu pip install --no-build-isolation -e . -v
triton-xpu 的版本要跟 torch 对齐:requirements/xpu.txt 用 torch 2.13 时对应 3.7.2,换 torch 版本要去 docker/Dockerfile.xpu 里查对应关系。这条对应关系写错了,报错会出现在很后面的 kernel 加载阶段,很难倒推。
驱动也有版本线。从 vllm-xpu-kernels v0.1.10 起,官方建议把驱动升到 compute runtime 26.18(26.18.38308.1),避免兼容性问题。这个包是 XPU 后端所有自定义 kernel 的载体,版本不匹配时症状是「能 import,一跑就崩」。
镜像是最省事的路径,但要注意设备透传的写法。
docker run --rm --network=host --ipc=host --privileged \
  --device /dev/dri:/dev/dri \
  -v /dev/dri/by-path:/dev/dri/by-path \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai-xpu:latest \
  --model Qwen/Qwen3-0.6B
--device /dev/dri 和 /dev/dri/by-path 两个都要挂。只挂前者时,某些驱动版本下容器内拿不到稳定的设备索引,多卡场景会认错卡。镜像的工作目录也从旧版的 /workspace/vllm 改成了 /vllm-workspace,老脚本里 cd 过去会失败。
起服务:四个参数决定成败
| 参数 | 默认 | 在 XPU 上的实际含义 |
|---|---|---|
--gpu-memory-utilization | 未指定时 0.92(有 extensible KV cache 时为 1.0) | 本实例可用的显存上限,不是预留量 |
--max-model-len | 从模型 config 推导 | 直接决定 KV cache 池的大小,是最有效的一根杠杆 |
--dtype | auto | FP16 模型的 auto 就是 FP16;bfloat16 要看后端支持 |
--enforce-eager | False | XPU 上关掉图捕获,官方示例普遍带上 |
--block-size | 视平台而定 | XPU 侧常用 64,和 Intel 的 chunked prefill 对齐 |
--max-num-batched-tokens | 视版本而定 | prefill 的批大小,长 prompt 时是显存峰值来源 |
--gpu-memory-utilization 是误解最多的一项。它的官方定义是「用于模型执行器的显存比例」,是一个 per-instance 的上限,不是「给系统预留多少」。理解反了,就会把它设成 0.95 以为是在预留,结果 vLLM 认为自己能用 95%,KV cache 池按这个比例铺开,把桌面和驱动要用的那块吃掉。
--max-model-len 的影响比 util 更直接。KV cache 的总量正比于「最大长度 × 最大并发序列数」,这两个数一起决定了池子大小。想把 32K 上下文塞进 12GB 卡,光调 util 是没用的,必须降长度或者降并发。
想让长度超过模型 config 里的值,还要显式放开限制:export VLLM_ALLOW_LONG_MAX_MODEL_LEN=1。Intel 的示例命令里几乎每条都带这个变量,缺了它,--max-model-len 40000 会被直接拒绝,报的是「超出模型最大长度」,看起来像模型不支持,实际是开关没开。
--enforce-eager 在 XPU 上的作用不是性能优化,是稳定性。它会同时关掉 torch.compile 和 CUDA graph,等价于 -cc.mode=none -cc.cudagraph_mode=none。代价是每次前向都有 kernel launch 开销,小 batch 下能感觉到;收益是避开图捕获在部分驱动版本上的崩溃。
一个典型的生产起法,参数取自 Intel llm-scaler 的示例口径,去掉了它特有的量化开关:
export VLLM_WORKER_MULTIPROC_METHOD=spawn
vllm serve Qwen/Qwen3-8B \
  --served-model-name qwen3-8b \
  --dtype float16 --enforce-eager \
  --gpu-memory-utilization 0.85 \
  --max-model-len 8192 --max-num-batched-tokens 8192 \
  --block-size 64 --port 8000 --host 127.0.0.1
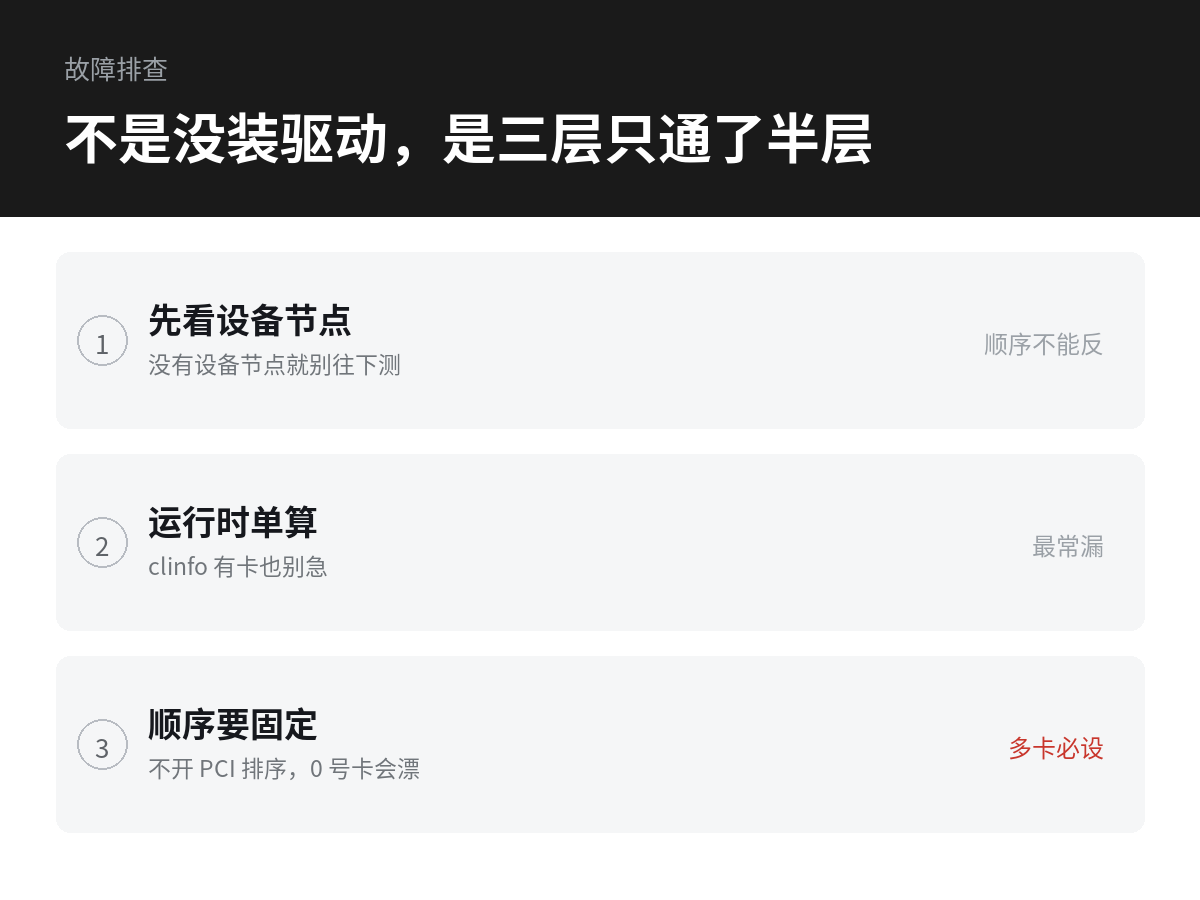
VLLM_WORKER_MULTIPROC_METHOD=spawn 这一条在 XPU 上几乎是必配。Intel 的运行时不支持 fork 之后继承 Level Zero 上下文,用默认的 fork 方式起子进程,症状是子进程里 torch.xpu.device_count() 返回 0——看起来像驱动没装好,实际是进程模型的问题。
多卡时用 --tensor-parallel-size,官方的 pipeline parallel 还标着 beta,且只支持在线 serving 加单节点 mp 后端。消费级卡上做张量并行要有心理准备:每一层都要跨卡同步一次激活,走的是 PCIe 而不是显存总线,收益会明显低于线性。
三个高频坑
坑一:Python 版本是硬约束
官方文档里这句话是全大写标出来的:
The provided vllm-xpu-kernels whl is Python3.12 specific so this version is a MUST.
原因很直白:XPU 的自定义 kernel 是编译好的扩展模块,wheel 的 ABI 绑定在具体的 CPython 版本和构建配置上。3.13 或 3.11 的环境里,pip 根本找不到可用的 vllm-xpu-kernels 轮子,报的是「找不到匹配版本」,而不是「Python 版本不支持」——这个错误信息会把人引向「网络问题」或「索引配错了」。
CUDA 版 vLLM 支持 3.11 到 3.14,XPU 版收窄到 3.12 一个版本。如果你的机器上已经有 3.11 的虚拟环境在跑别的项目,不要试图复用。新建一个 3.12 的环境,是这里唯一省时间的做法。
uv venv --python 3.12 vllm-xpu
source vllm-xpu/bin/activate
坑二:模型架构和 dtype 不匹配
这一坑的表现形式比第一个多,但根因是同一个:XPU 后端的内核覆盖范围比 CUDA 窄,模型架构、dtype、量化格式三者任何一个落在覆盖范围外,就起不来。
最典型的是 dtype。Puget Systems 在 2026 年 6 月用 Intel 的 llm-scaler-vllm:0.14.0-b8.2.1 镜像测 Arc Pro B70 时,Gemma 2 9B 在 FP16 下直接被拒:
The model type 'gemma2' does not support float16. Reason: Numerical instability. Please use bfloat16 or float32 instead.
注意这条报错来自模型自身的实现,不是 vLLM。Gemma 2 在 FP16 下数值不稳,模型代码主动拒绝;而那个版本的 XPU 容器只提供 FP16 服务路径,于是这个模型在 B70 上没有任何可行解。同一份测试里,Llama、Qwen、DeepSeek、Mistral 这些支持 FP16 的家族都正常。
第二类是量化格式。上游 vLLM 的 AWQ / GPTQ Marlin 反量化内核是 CUDA-only,没有等价的 XPU 实现。Intel 的 llm-scaler 镜像自己补了 INT4 和 FP8 在线量化以及 GPTQ 支持,但那是容器内的额外层,不是上游 vLLM 的能力。另一份针对 Gemma 4 的测试里,AWQ INT8 的 compressed-tensors uint8b128/W8A16 路径直接报「无对应 XPU kernel」。
第三类容易被忽略:核显。vLLM 的 XPU 后端在初始化时要查询设备的空闲显存,核显和 CPU 共享内存,没有独立的显存池,这个查询会失败:
RuntimeError: The device (Intel(R) Graphics [0x7d51]) doesn't support querying the available free memory.
这个报错出现在权重加载完成之后、KV cache 初始化之前。表面看像显存不足,实际是查询能力缺失。绕法是显式指定 block 数量(--num-gpu-blocks-override),或者干脆用独显。
判断自己的模型在不在范围内,最省事的办法是查 Intel llm-scaler 仓库的支持矩阵。它按模型列了 FP16、在线 FP8、在线 INT4、MXFP4 四档支持情况,覆盖了 Qwen3 系列、Llama 3.1、DeepSeek-R1-Distill、gpt-oss、GLM、InternVL 等几十个模型。矩阵里没有的,不代表不能跑,但意味着没有验证记录。
支持面窄的根子在 kernel 层。CUDA 版 vLLM 的性能来自一批手写内核——PagedAttention、Marlin 反量化、FlashInfer 的注意力、Fused MoE——这些在 XPU 上要么有 Intel 的等价实现,要么就没有。没有的时候不报「不支持」,而是回退到通用路径或直接走到一个未实现的算子。
所以「同样的模型,CUDA 能跑,XPU 不能」这件事本身不奇怪。判断标准不是模型有多流行,而是它的架构里有没有那个缺内核的算子。
坑三:显存预留过高导致启动失败
这个坑的症状很一致:权重加载成功,日志打到「KV cache 初始化」,然后一条 RuntimeError: XPU out of memory 结束进程。
机制是这样的。vLLM 启动分两步:先按 dtype 把权重搬进显存,再按 gpu-memory-utilization 算出「还能用多少」,然后按这个额度分配 KV cache 的 block 池。util 设得越高,第二步算出来的额度越大,池子铺得越满。
问题在于这个额度是按「整卡显存 × util」算的,不是按「当前空闲显存 × util」。桌面上开着浏览器、IDE、播放器时,实际空闲比整卡少 0.7GiB 左右,而 vLLM 仍然按整卡比例去要,差额就从驱动那里拿不到,分配失败。
12GB 卡上这个差额足以致命。整卡实际 11.18GiB,util 0.95 时 vLLM 按 10.6GiB 规划;权重 5GiB 之后,KV 池要铺 5.6GiB。但桌面已经拿走 0.7GiB,真正能给的只有 10.5 − 5 = 5.5GiB。差 0.1GiB,启动就挂——这就是它看起来「参数都没写错却起不来」的原因。这类账可以先按显存估算表把权重和 KV 两笔分开算,再决定 util 该给多少。
三个调整方向,按性价比排序。先降 --max-model-len,它直接线性缩小 KV 需求,副作用是上下文变短,对多数应用是可接受的。再降 util 到 0.8–0.85,给桌面留出余量。最后才是加 --num-gpu-blocks-override 手工钉死 block 数,这是调试手段,不是生产配置。
反过来也有坑:util 设太低(比如 0.5),池子小到装不下一个长请求,表现是「服务起来了,但长 prompt 一律 400」。这个报错比 OOM 更难查,因为日志里没有任何显存相关的字样。
这两个方向的边界要用一次压测钉死。从 0.85 开始,每次加 0.05,记录「启动成功且长 prompt 不报 400」的最大值,再退回去 0.05 作为生产值。这个值在同一张卡上稳定,换驱动版本要重测。
验证:curl 与压测
服务起来之后,先确认它认的是哪张卡。启动日志里会有设备名和 XPU 相关的后端信息,看不到 Arc 或 Data Center GPU 的字样,就是退到 CPU 了。
curl -s http://127.0.0.1:8000/v1/models | python -m json.tool

curl -s http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3-8b","max_tokens":64,"stream":true,
       "messages":[{"role":"user","content":"用一句话说明 KV cache 是什么"}]}'
stream:true 这一项不能省。非流式请求只测到端到端延迟,看不出首字延迟(TTFT),而对交互式应用来说首字延迟才是体验的决定项。这也顺带解释了为什么本地服务和云端 API 的对比不能只看总耗时,端点之间的差异在同一模型的 API 价格对比里有更细的拆法。
接口层的这点兼容性,也让下游客户端可以照常接。vLLM 起的是标准的 /v1 端点,任何按 OpenAI 协议写的客户端都能连,区分服务和客户端这件事在Ollama 那篇里讲得更透,结论一样:后端换掉不影响前端。
压测用 vLLM 自带的 bench。关键是固定输入输出长度,否则不同轮次之间不可比。
vllm bench serve --backend openai-chat \
  --model qwen3-8b --base-url http://127.0.0.1:8000 \
  --endpoint /v1/chat/completions \
  --dataset-name random \
  --random-input-len 1024 --random-output-len 256 \
  --num-prompts 200 --max-concurrency 32 --request-rate inf
它输出六个数:请求吞吐(req/s)、输出 token 吞吐(tok/s)、总 token 吞吐、TTFT、TPOT、ITL。口径要说清楚——--request-rate inf 是全部请求立刻发出,测的是饱和吞吐;设成有限值(比如 8)时按泊松过程到达,测的是特定负载下的延迟。两种结果不能混着比。
TPOT 和 ITL 的区别在投机解码时才明显。标准解码下每个流式块含一个 token,两者近似相等;一旦开了投机解码,一个块可能含多个被接受的草稿 token,ITL 只算块间隔,TPOT 把时间摊到所有 token 上。报数字时必须写明是哪一个。
还有一个会虚增结果的因素:前缀缓存。同一台服务连跑两轮 bench,第二轮会命中第一轮留下的前缀,吞吐凭空变高。要么每轮重启服务,要么换 --seed,要么把输入改成完全随机。
怎么确认自己没踩到这三个坑
Python 版本:python -V 输出必须是 3.12.x,且 pip show vllm-xpu-kernels 能查到版本号。查不到就是装错了索引。
启动日志里还有一行值得记下来:KV cache 的 block 数和每块 token 数。这两个数相乘就是池子的总容量,和你按 --max-model-len 估出来的值对不上,说明有别的进程在占显存,或者 util 被内部逻辑下调了。
模型架构:启动日志里搜 dtype 和 quantization 两行,确认实际生效的 dtype 是你要的那个。日志说 FP16 而你以为在跑 BF16,说明 --dtype 没生效,后面所有性能数字都不可比。
显存:服务稳定后跑一次 xpu-smi stats -d 0,看显存占用是否接近 util × 整卡。如果明显低于这个值,说明 KV 池没铺满,可能是 block 数被限制住了。
再压一轮并发,观察显存是否随时间上涨。vLLM 的 PagedAttention 会复用 block,正常情况下稳态占用是一条平线;如果 10 分钟内缓慢爬升,通常是有请求没被正确回收,或者 prefix cache 在无界增长,可以先用 --no-enable-prefix-caching 排除后者。
最后一条经验:先把 --max-model-len 设成一个明显偏小的值(比如 4096)把服务跑通,确认 curl 能出结果,再往回调。一步到位地配 32K 上下文加 0.95 的 util,失败的现场只会给你一行 OOM,不会告诉你哪个参数越界。
登录后可点赞、收藏与反馈。