#Intel显卡
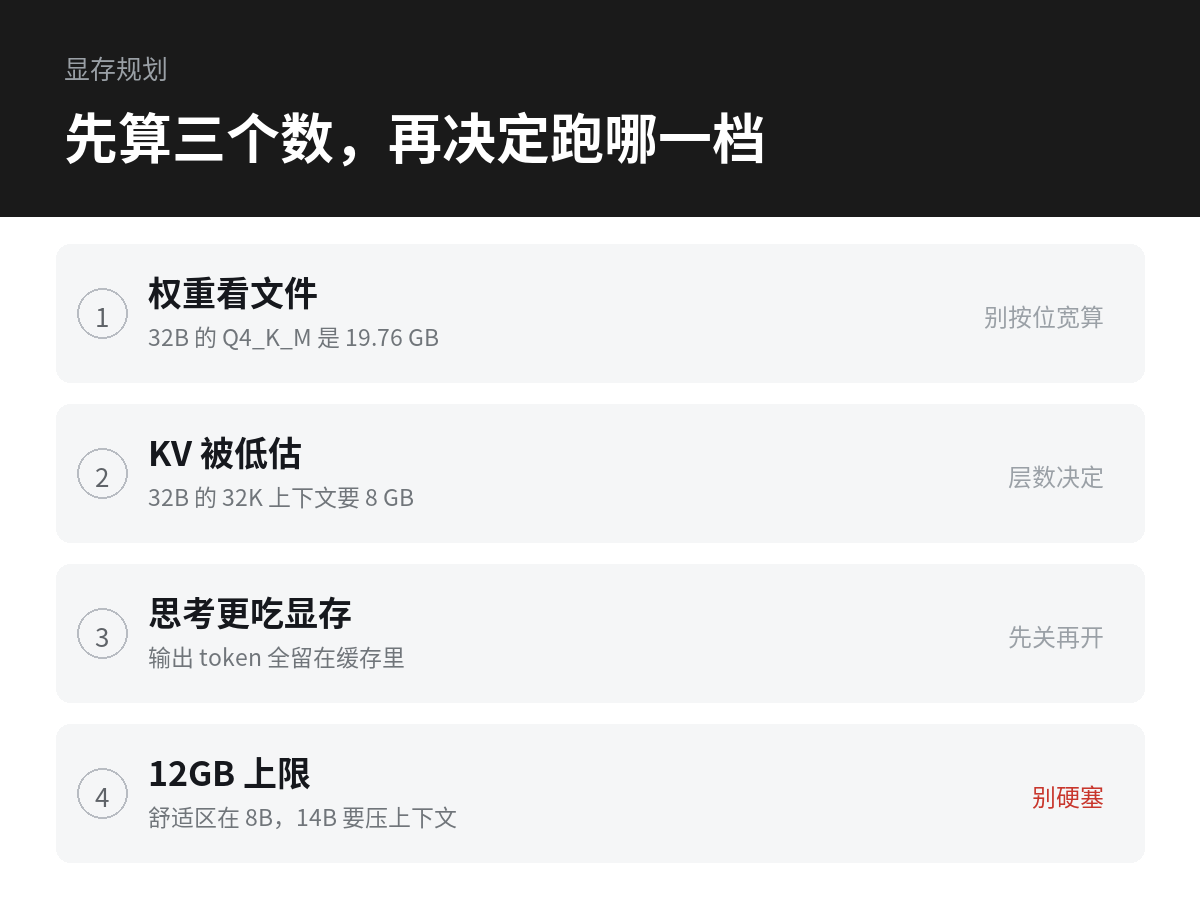
在 Arc 上跑 Qwen3:量化档位、显存占用与速度预期
按 Qwen 官方 GGUF 仓库的真实文件体积,算清 Qwen3 8B/14B/32B 各量化档的权重与 KV 开销,给出 12GB、16GB、24GB 三档 Arc 显卡的可行组合,并说明思考模式如何把输出长度变成显存压力。
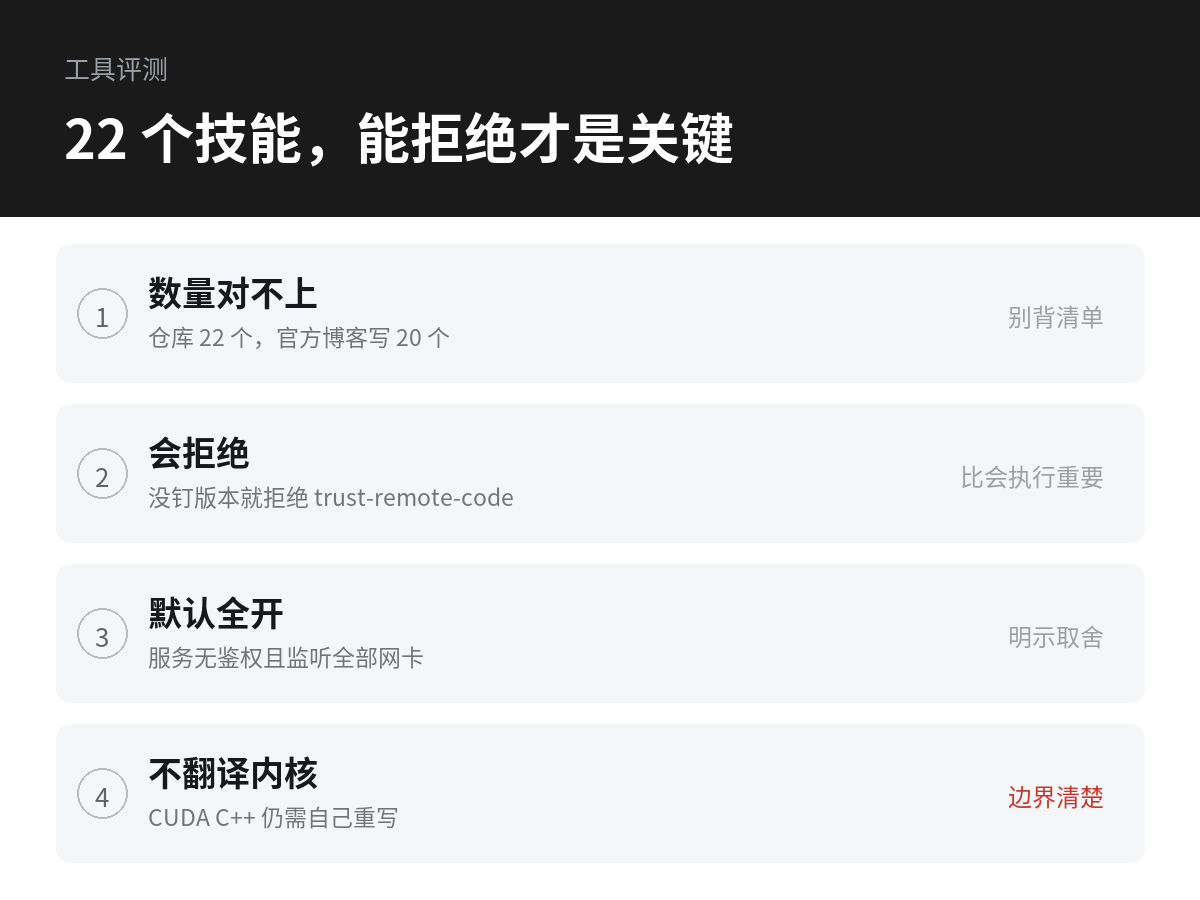
Intel 的 GPU Agent Skills:22 个技能能替你做哪些事
仓库里其实是 22 个技能目录,不是 20 个。它把主机检查、显存估算、服务拉起、benchmark 和 CUDA 迁移写成可执行的检查,条件不满足时拒绝;默认绑 0.0.0.0 且服务无鉴权的取舍写在 SECURITY.md。
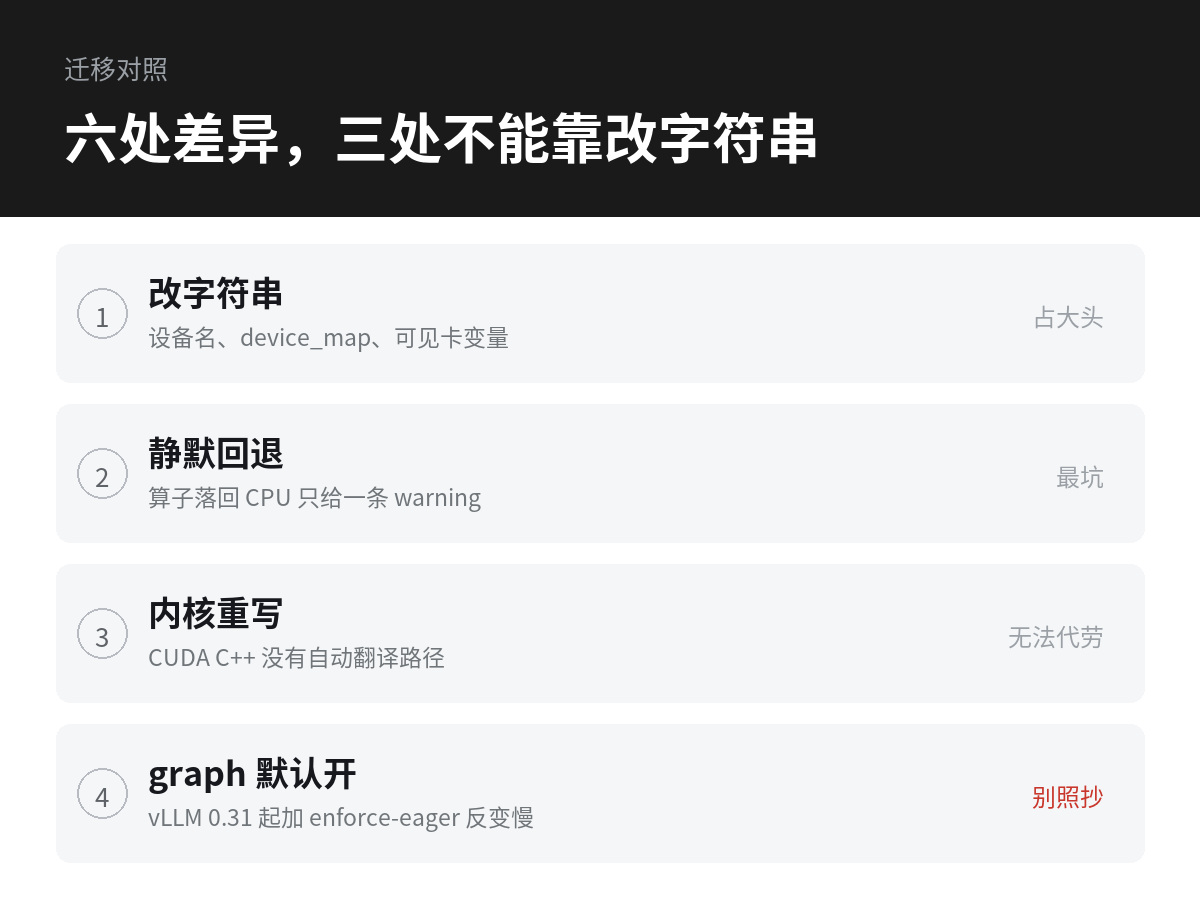
把 CUDA 代码迁到 Intel XPU:需要改的六处
六处差异按改动量排序:设备字符串能机械替换,stream 与 event 接口齐全但个别参数不生效,显存 API 对齐而账面含义变了,算子回退是静默的,CUDA C++ 扩展必须重写,调优入口换工具不换思路。每处附最小代码对照与验证方法。
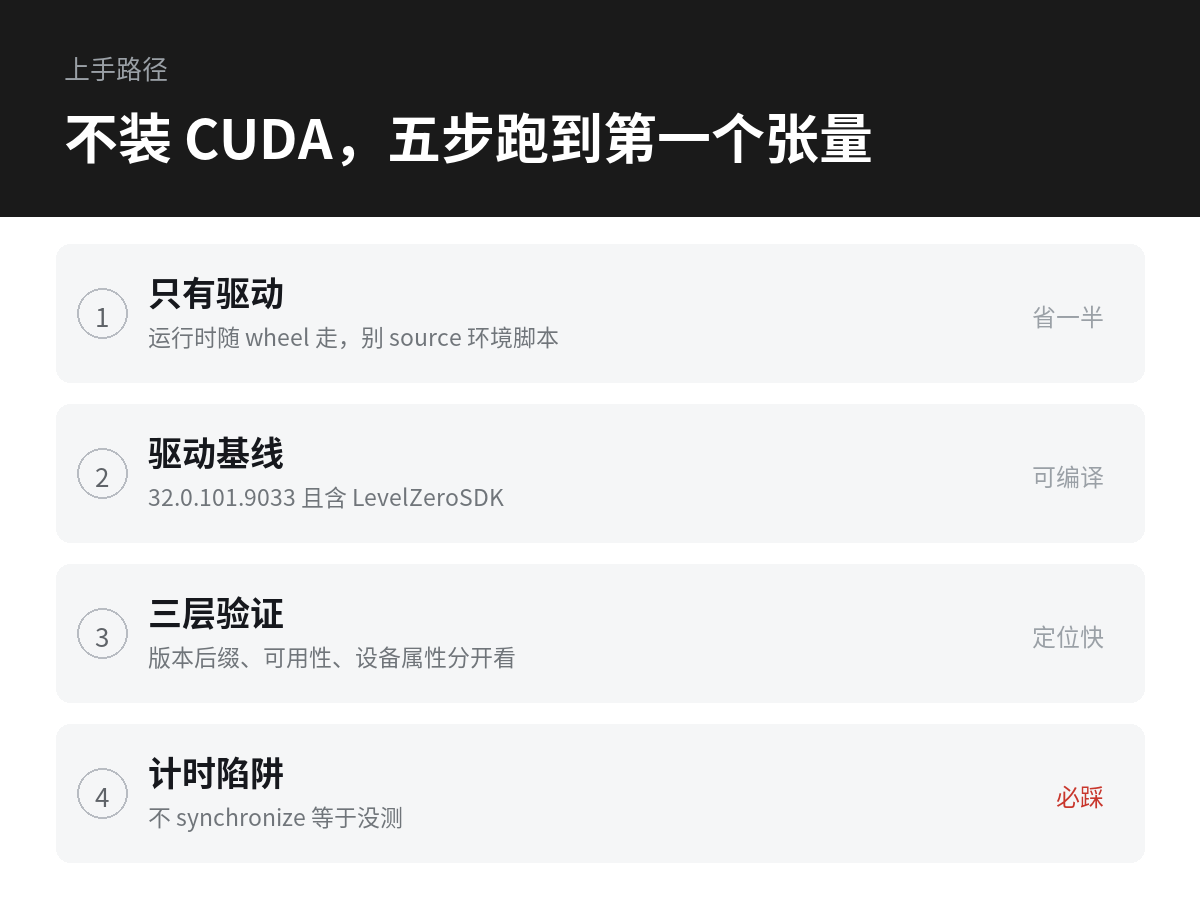
不装 CUDA 也能跑:PyTorch XPU 从装环境到第一个张量
XPU wheel 把 SYCL 运行时打进了包里,所以官方路线不需要 source 任何 oneAPI 脚本。按驱动基线、wheel 安装、设备查询、第一个张量、CPU 脚本改造的顺序给一条能跑通的最短路径,附预期输出与症状对照表。
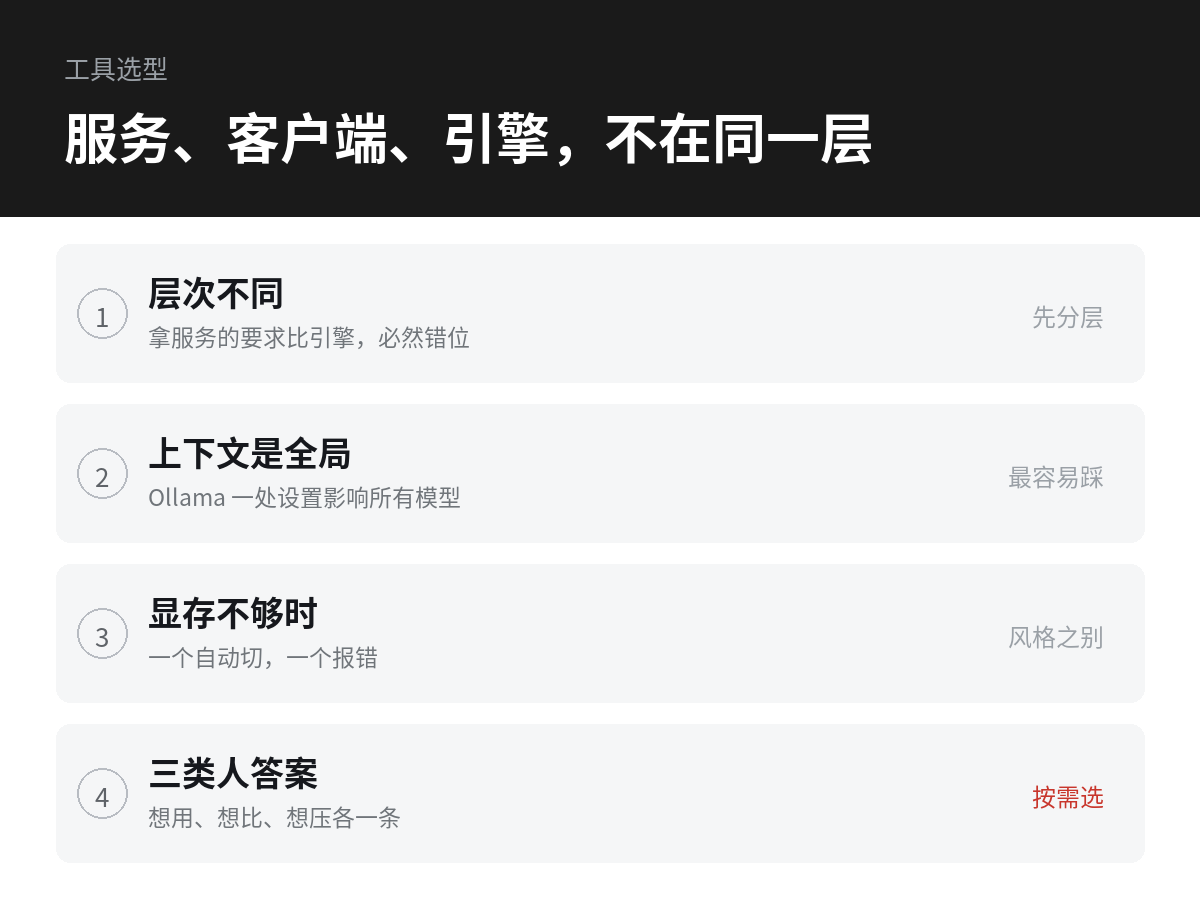
Ollama、LM Studio、llama.cpp:Intel 显卡上谁最省事
三者是服务、桌面客户端与推理引擎三种不同层次的抽象,省事的方式和代价各不相同。本文比较易用性、显存与上下文可控性、模型来源、日志可观测性,说明显存不足时三者各自的行为差异,并给只想用、想比较、想压性能三类人的默认选择。
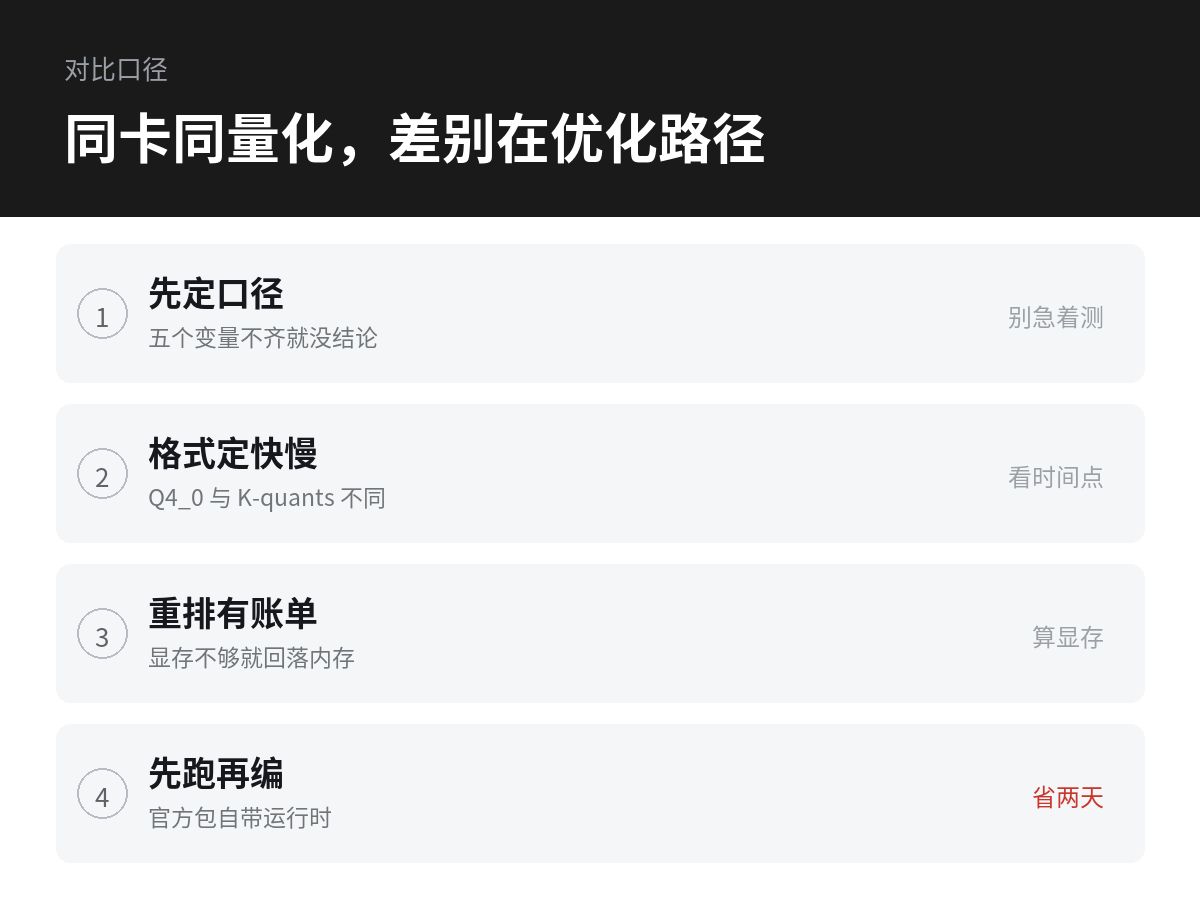
llama.cpp 的 Vulkan 与 SYCL 在 Arc 上差多少
官方没有同条件对照数据,差距取决于量化格式与硬件代际。本文先固定五个变量,再拆解 SYCL 的 reorder 与 XMX 路径相对 Vulkan 的位置,给出先用现成包验证收益的方法和可复现的 llama-bench 命令。
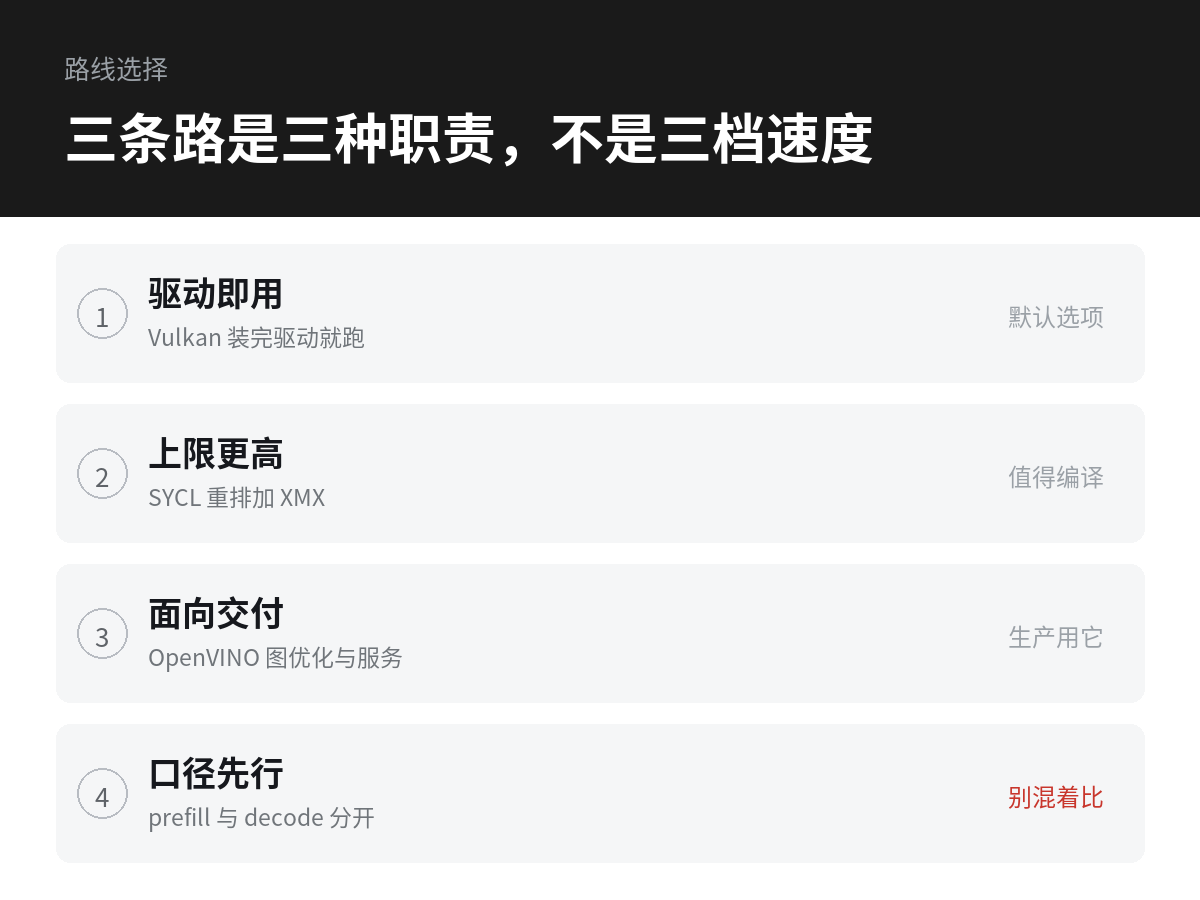
Vulkan、SYCL、OpenVINO:Intel GPU 三条路线怎么选
三条路线分别是通用图形接口、oneAPI 编程模型和推理部署框架,职责不同而非性能档位。本文比较上手成本、优化层次、模型覆盖与可调试性,说明 prefill 与 decode 要分开算,并给出四类场景的选择结论。
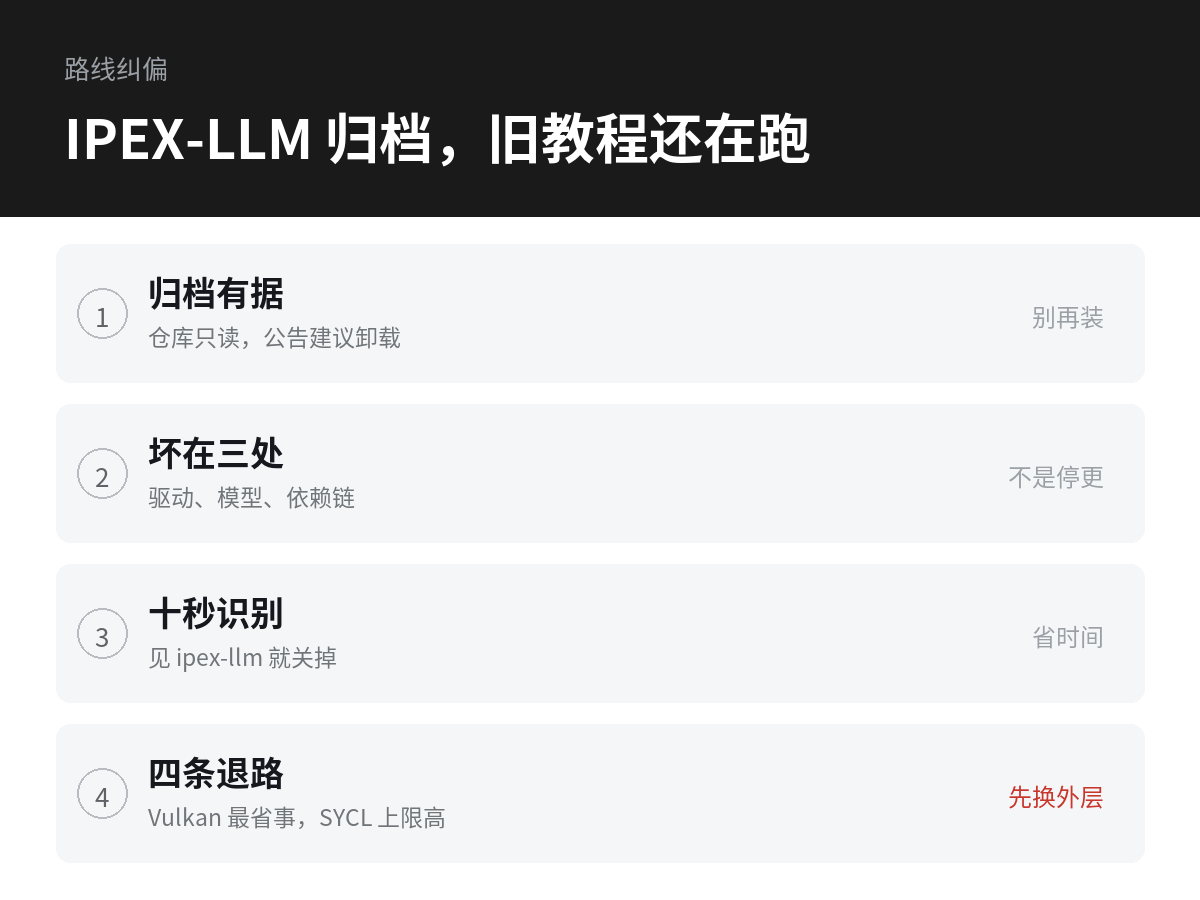
IPEX-LLM 已归档:中文 Intel 显卡教程为什么集体过期
intel/ipex-llm 已转为只读,Intel 安全公告建议卸载。本文用仓库字段与公告时间线核实归档事实,拆解旧教程会遇到的六类故障,给出十秒识别过期教程的三个特征,并梳理四条迁移路线。
Intel 显卡驱动与 AI 框架的版本对应:一张兼容矩阵
把驱动分支、oneAPI、PyTorch XPU、llama.cpp、vLLM、Ollama 的版本关系整理成表,区分官方验证过的组合与仅有社区记录的组合,并给出容器镜像与固定 wheel 两种锁版本做法。
Windows 下 Arc 跑 ComfyUI:报错清单与配置对照
从驱动、Python、XPU wheel 三者的版本对齐讲起,把 Windows 上用 Arc 跑 ComfyUI 的高频报错整理成「报错—原因—改法」表,并说明 xformers 为何装不上、显存不够时该动哪几个参数。
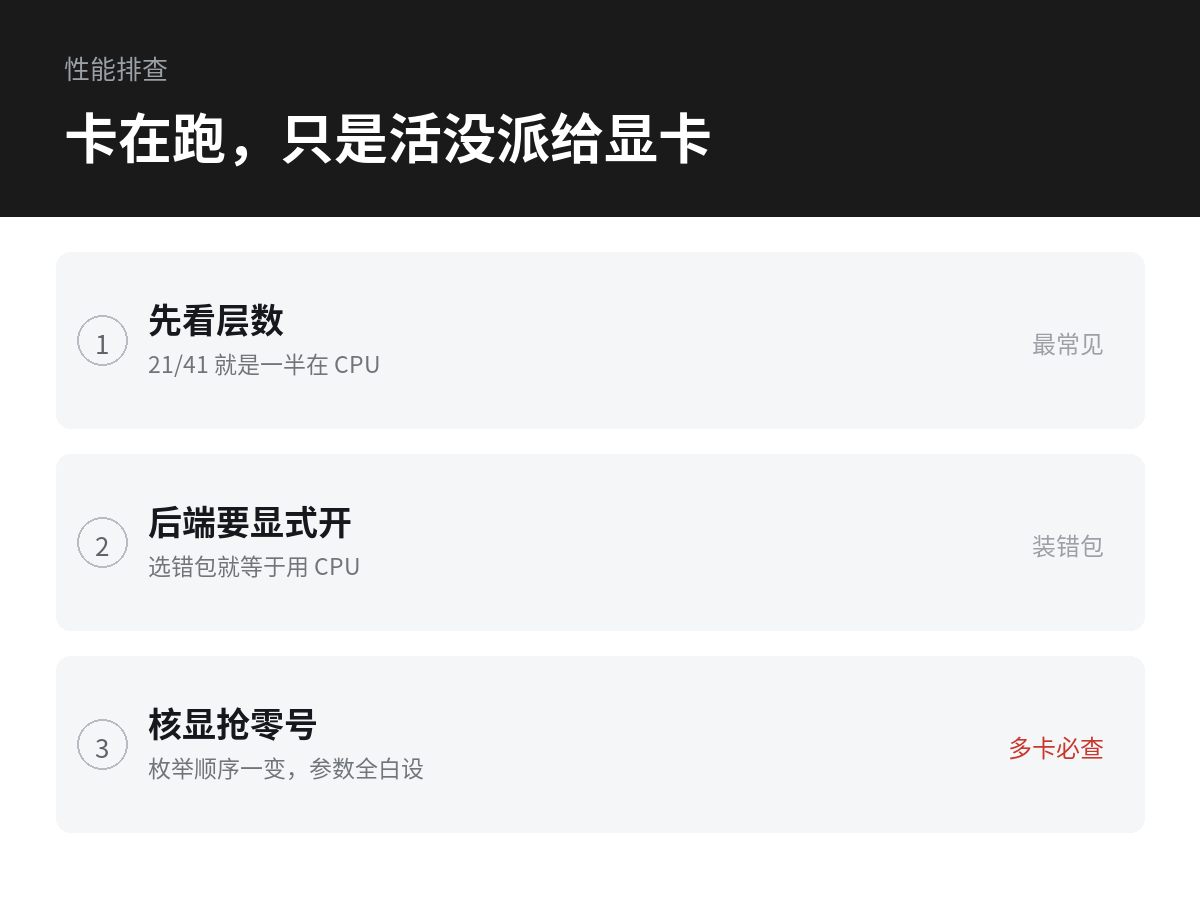
跑模型时 GPU 占用 0%:三处回退路径的定位方法
显存不够导致层回退 CPU、后端没编进二进制、进程把活派给了核显——三类「跑了但没用上卡」的日志特征与判定顺序,含 llama.cpp 日志怎么读、-lv 4 怎么开、Ollama 与 ComfyUI 各自的设备开关。
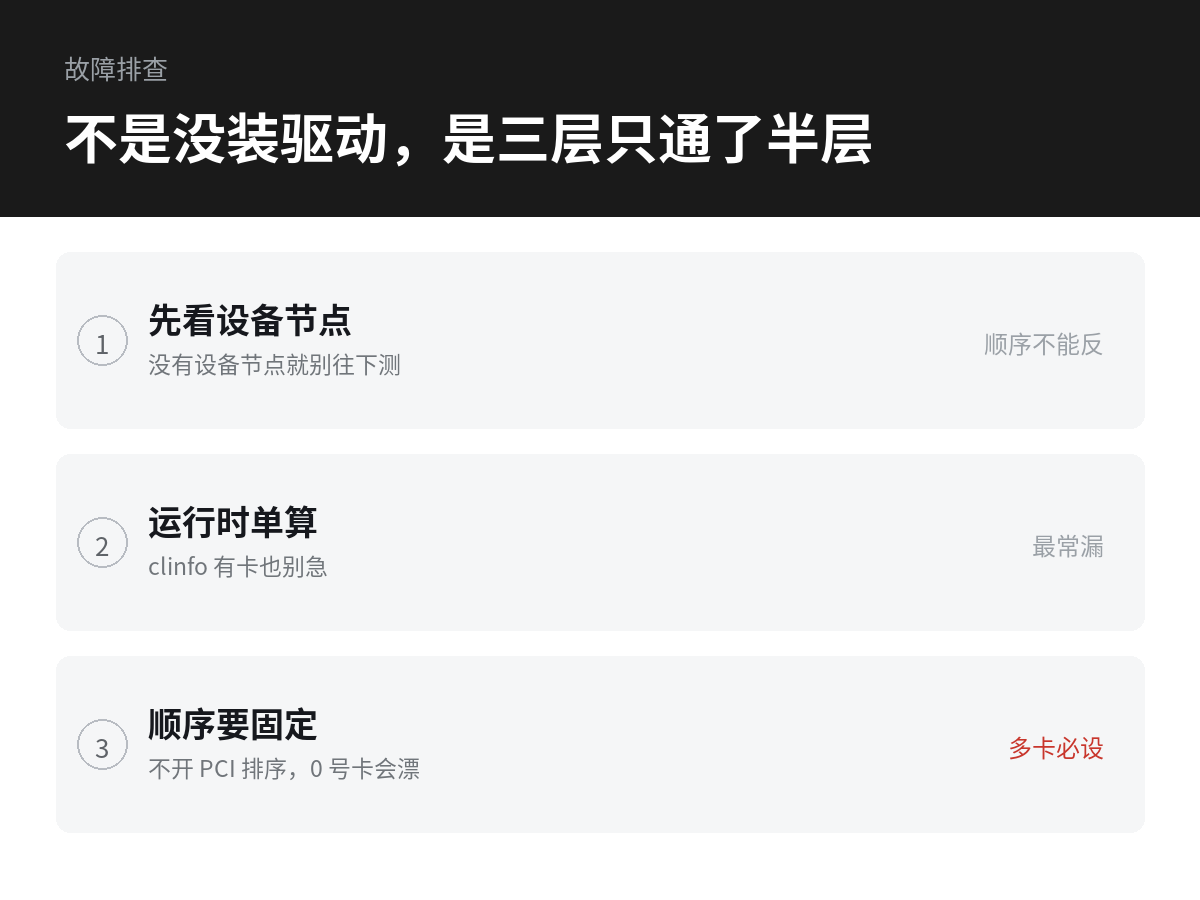
装了 oneAPI 还是找不到 GPU:Level Zero 与设备选择器排查
把「驱动装了」「运行时装了」「应用能看到设备」拆成三层,用 sycl-ls、ze_info 和 ONEAPI_DEVICE_SELECTOR 逐层定位。含多卡指定、核显独显排序、容器 /dev/dri 透传与常见误判。