AI 代理在你站点下单:三层身份凭据抵不过一层行为
Forter 的数据显示,AI 代理订单三个月涨到 7.9 倍,其中八成来自驱动商家自己结账页、日志里和真人一样的浏览器型代理。本文用 39 家站点实测与 8 个会话的日志样本,拆开 UA、IP、签名三层凭据的失效点,说明为什么判据要落到行为上。
11 月 16 日,支付风控公司 Forter 更新了代理订单统计:从 8 月中到 11 月中,它网络上的 AI 代理下单量涨到 7.9 倍。同一份数据里有个更难处理的数字——爬取型代理的订单占比,从 8 月 17 日那一周的 1.2% 升到 11 月 2 日那一周的 80.5%。
三个月前,能给你结构化订单字段的那一类还占绝对多数;现在它只剩两成。
一、能看清的两成,认不出的八成
Forter 把代理分成两类。协议型是 OpenAI 的 ChatGPT Instant Checkout 和 Google,走已经接好的结账协议,商家能拿到结构化、经过验证的订单数据。爬取型是 Muse、Instinct、Grok Bot 和 ChatGPT Agent,用真实浏览器点商家的页面,从商品页一路点到付款按钮。
官方对后者的描述很直接:这类代理“看起来就像一个在网站上点击的购物者”,商家“既不容易区分合法代理和机器人,也看不出真正的买家是谁”。
转折点是 Meta 的 Muse。整个 8 月,OpenAI 一家每星期占着 80% 到 92% 的代理订单;Muse 上线后,11 月 2 日那一周它自己就占了 49%,每天的下单量是 ChatGPT 和 Google 加起来的 2.9 倍。官方给的原因不复杂:协议只能触达接了协议的店,浏览器型代理哪都能买。
规模上还有两组旁证。HUMAN 观测到 Muse 占每日代理请求的 72%,约为 ChatGPT Agent 的 5.2 倍;DataDome 记录它 9 月 22 日到 10 月 1 日的日请求从 80 万涨到 370 万,九天 4.4 倍。
但成交份额仍然很小。eMarketer 在 Muse 上线前给出的预测是,2026 年 AI 平台大约驱动美国零售电商的 1.5%。这两组数放在一起才是完整判断:流量足迹远大于成交份额。按订单占比决定“要不要管”会低估它,按请求量决定“要不要管”会高估紧迫性。真正该看的是它碰到了哪个路径。
还有一个反直觉的数:11 月代理订单均价 204 美元,是真人 89 美元的 2.3 倍,50 美元以下只占三成。人们把代理用在更贵、更需要考虑的购买上。
二、三层凭据,各有各的失效点
第一层:UA 是一行文本,写了也常常没执行
在 robots.txt 里写 User-agent: GPTBot 是最普遍的做法。但它到底部署到什么程度,很少有人量过。
我用一个脚本拉了 52 个站点的 robots.txt,39 个可读(其余是国内网络到不了或直接 403),其中 8 个写了至少一个 AI 爬虫 token,占 20.5%。分区域差别很大:国内 31 个可读站点里只有 3 个写了(9.7%),海外 8 个里 5 个写了(62.5%)。海外样本偏小,方向可参考。
写了的这 8 个,写法本身也有信息量。
| 站点 | 写法 |
|---|---|
| 搜狐 | 19 个 token,18 个是全站拦截 |
| The Verge | 19 个,17 个全拦,GPTBot 与 Amazonbot 只做部分限制 |
| 亚马逊 | 17 个全部全站拦截 |
| WIRED | 15 个全部全站拦截 |
| TechCrunch | 7 个全部全站拦截 |
| 钛媒体 | 4 个,但一条 disallow 都没有 |
| 知乎 | 只写 Google-Extended |
| Notion | 只写 Amazonbot |
两个观察。第一,写了的多数是抄一份长名单再全站 disallow,不是逐个想清楚——搜狐 19 个 token 里 18 个是 Disallow: /,亚马逊 17 个全拦。第二,写得少的信息量更大:知乎只写 Google-Extended,意思是不让 Gemini 拿它训练,GPTBot 照进;钛媒体写了 4 个 token 却一条 disallow 都没有,等于只登记、不执行。
这就是第一层的第一个问题:写了不等于拦得住。TollBit 的数据显示,在欧洲站点上被识别出来的 AI 抓取里,约 15% 打到了明确 disallow 的 URL。
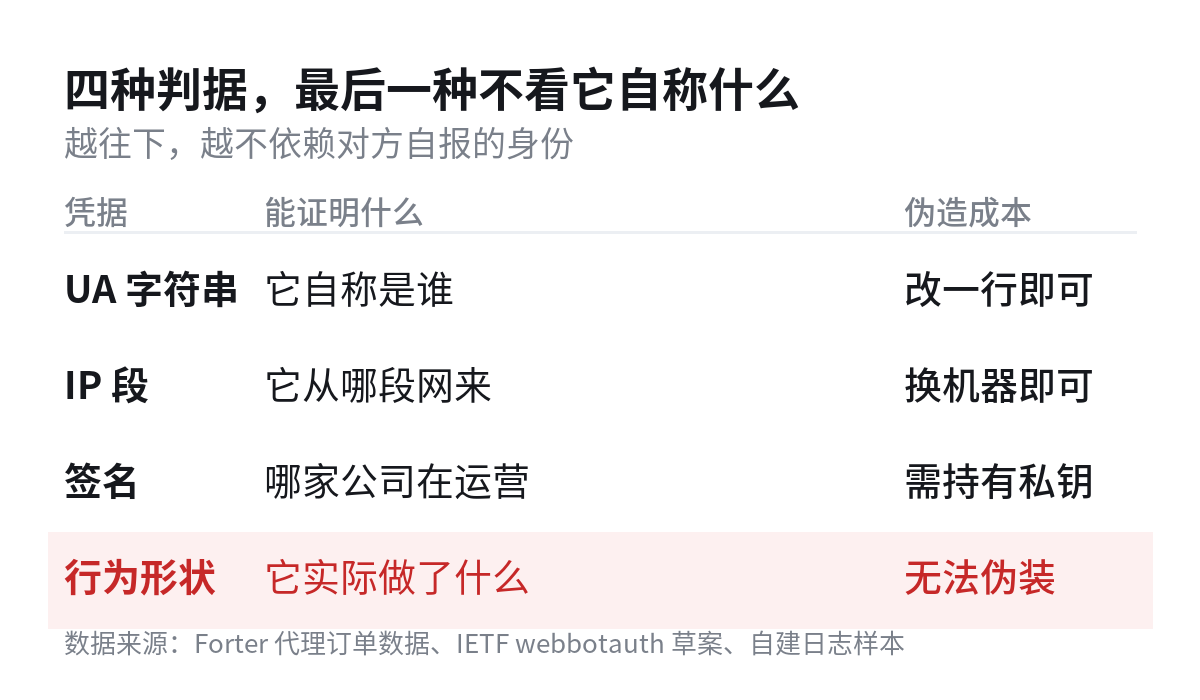
第二个问题是 UA 本身。这行字符串由请求方自己填,谁都能写 GPTBot/1.2。所以按 UA 拦,拦住的是守规矩的那些,拦不住想进来的那些——而想进来的那些正是你要防的。
第三个问题最容易被忽略:一刀切会把曝光一起关掉。OpenAI 自己把抓取拆成三个 UA——GPTBot 收训练语料,OAI-SearchBot 建 ChatGPT 搜索索引,ChatGPT-User 在用户提问时取页面。按官方说明,退出 OAI-SearchBot 就不会出现在 ChatGPT 的搜索回答里,而屏蔽 GPTBot 只是表明不希望内容被训练。这两件事的后果完全不同。
第二层:IP 段用于验真,不用于封禁
GPTBot 和 OAI-SearchBot 至今仍靠公布 IP 段来验证,Web Bot Auth 还没覆盖到它们。公布段解决的是“这个自称 GPTBot 的请求是不是真的”,不是“我要不要放它进来”。
两者用反了都会出事:照着段封,会连带封掉同网段的自家客户和监控探针;把段当白名单放行,等于给整段开了口子。
更麻烦的是段会变。Meta 的 Muse 在 11 月 7 日到 9 日之间把签名密钥目录从 meta.com 迁到了 muse.ai,DataDome 在 11 月 10 日测到它约一半请求已经不带签名。只认旧目录的站点,会从“验证通过”直接掉到“验证失败”——不是来了陌生人,是熟人换了门牌。
第三层:签名能证明谁运营,不能证明谁授权
第三层是 Web Bot Auth。运营方生成一对 Ed25519 密钥,公钥放在自己域名的 /.well-known/http-message-signatures-directory,每个请求带三个头:Signature-Agent 指向目录,Signature-Input 说明签了哪些字段和有效期,Signature 是签名本身。验证方取公钥、核对签名、拒绝过期消息。
进度要说清楚:IETF 在 2025 年 10 月 23 日成立 webbotauth 工作组,主草案 draft-ietf-webbotauth-httpsig-protocol 在 2026 年 10 月 29 日到 rev 01,仍未提交 IESG——原计划是 2026 年 4 月。它是草案,不是标准。
签的一方还很少。OpenAI 给 ChatGPT 的云浏览器签名,Signature-Agent 是 https://chatgpt.com;Meta 的 Muse 签;Exa 的搜索爬虫全签;Google 只对一部分 Google-Agent 请求签,用的是 https://agent.bot.goog,并建议站点继续保留 IP、反查和 UA 检查。验的一方多得多:Cloudflare、Akamai、HUMAN、Vercel、AWS WAF 都能验。
签与验的数量差,决定了规则怎么写。如果写成“没签名就拒绝”,被拒的会包括大部分正常代理。
还有一个边界比覆盖率更值得记住:签名的主体是运营商,不是用户。一个被提示词注入的签名代理,验证照样通过;同一个运营商下某个用户的滥用,和另一个用户的正常使用,签名是同一串字节。签名解决了“冒充”,没解决“越权”。真要绑到人,那是另一层——授权凭据、委托关系,不是签名能给的。
最后是一个自己会造出来的故障。OpenAI 的密钥目录里,exp 是响应时刻加 604800 秒,也就是 7 天。如果验证器按这个值硬缓存目录、对方中途换了目录或换了密钥,你会连续几天全量验证失败。这不是攻击,是缓存策略。目录这类东西按分钟级缓存,别按天。
三、行为层:唯一不看它自称什么的判据
前三层都在问“你是谁”。行为层问的是“你做了什么”,而这件事对方没法靠改一个请求头来伪装。
三个特征够用。一是会话内的静态资源比例——真浏览器会拉 CSS、JS、图片,驱动结账的代理常常只取 HTML,它不需要渲染样式。二是路径的线性度——人会回退、会分叉、会点开又关掉,脚本按固定顺序走。三是到达间隔的变异系数,也就是标准差除以均值:人的间隔是散的,脚本的间隔是齐的。
我按这三条加签名判定写了分类器,用 8 个会话、45 行日志测了一遍。
类别            请求  理由
----------------------------------------------
人类访客           8  3 个静态资源,有回退
人类访客           3  1 个静态资源,有回退
接口客户端         6  全在 /api/ 下
撞库/凭据滥用      9  只打登录页,失败率 100%
浏览器型代理       6  0 静态,CV=0.00
签名代理           4  Signature-Agent 非空
自报爬虫           6  UA 自报 GPTBot
自报爬虫           3  UA 自报 OAI-SearchBot
8 个会话全对,但真正有价值的是分层带来的增益:5 个非人会话里,只看 UA 自报命中 2 个,加上签名头命中 3 个,再加行为和凭据特征才到 5 个。间隔变异系数上,人类桌面会话是 0.59,浏览器型代理是 0.00。
gaps = [b.t - a.t for a, b in zip(hits, hits[1:])]
h = [p for p in paths
     if not is_static(p) and not is_api(p)]
s = [p for p in paths if is_static(p)]
if len(gaps) >= 2:
    cv = stdev(gaps) / mean(gaps)
regular = cv is not None and cv < 0.35
if not s and len(h) >= 3 and regular:
    kind = "浏览器型代理"
写的过程中撞了两个真 bug,都比结论有用。
第一个:nginx 日志里没有签名头时,$http_signature_agent 输出的是 -,不是空字符串。我第一版直接 if sig: 判断,结果 8 个会话全被判成“签名代理”,理由栏一律显示 Signature-Agent=-。缺省值看起来像逻辑错误,排查时最容易被忽略。
第二个更隐蔽:我给 API 路径加了白名单,让纯接口调用不参与浏览器行为判定。但开关只写在提前返回那一支,特征计算里仍然把 API 路径当成了 HTML。关掉开关复测,自家接口客户端就被判成浏览器型代理——3 个良性会话里 1 个误报。这种“开关只作用在一个分支”的错,单看输出很难发现。
第三个不算 bug,但会让人误读输出:中文在等宽字体里占两格,用 :<12 按字符数补齐,“撞库/凭据滥用”那一行的数字会比其他行右移好几格,看起来像数据错位。对齐得按显示宽度算,unicodedata.east_asian_width 判断宽窄就行。
还有一条判据不需要调参,也最可靠:只访问登录入口,且失败率接近 100%。不管它自称 Chrome、自称签名代理,还是什么都不称,这个形状都是滥用。
四、四条能今天就改的规则
第一,按路径分区,不按身份分区。 训练爬虫、搜索爬虫、办事代理、结账动作走四套规则。身份会变、会伪造、会迁移;路径不会。商品页可以放行,结账页要求一次性凭据,库存接口单独限速。
第二,别顺手关掉搜索爬虫。 只写 GPTBot、Google-Extended、Applebot-Extended 就能表明“不用于训练”,同时保留 OAI-SearchBot 和 Googlebot。把整份名单一起 disallow,代价是从 AI 搜索的回答里消失。这两件事在 robots.txt 里本来是分开的,别写成一件事。
第三,结账层不认身份,认凭据。 浏览器型代理点的是你自己的结账页,防线应该在“这笔支付有没有用户授权”,而不是“这个请求是不是机器人”。ChatGPT 的云浏览器会通过 Forwarded 头转发真实用户信号——ASN、国家、locale、时区、UA。风控系统没接这些字段,就会把正常订单判成盗刷。
第四,日志里加一列签名头。 nginx 的 log_format 里加一个 $http_signature_agent,这是你能不能区分“签名代理”和“伪装成浏览器的代理”的唯一前提。没有这一列,后面所有判断都是猜。同时注意反向代理和 WAF 规则不要改写 Signature、Signature-Input、Signature-Agent 三个头——改了签名就验不过,签名代理会被当成陌生流量挑战。
Cloudflare 用户还有一个便宜动作:AI Crawl Control 在所有套餐里都有,能看到每个爬虫的请求量、有没有违反 robots.txt,并把 Search、Agent、Training 三类分开设。注意 2026 年 9 月 15 日之后接入的域名,Training 和 Agent 的默认值是“在有广告的页面上拦截”——这个默认值很多人不知道,可能正在拦掉自己的 AI 搜索流量。老的 “Block AI bots” 开关已弃用,而且现在会连带拦掉混合用途爬虫,该换成新预设了。
边界说明
本文的两处实测都有边界。robots.txt 扫描只覆盖 39 个可读站点,海外样本仅 8 个,且国内网络有多站不可达,比例只作方向参考。日志样本按已知失败模式构造,不是真实站点数据;分类器证明的是判据有效,不是某个准确率数字。签名相关的字段与时间线取自 IETF 草案与公开转述,我本机无法访问 chatgpt.com、muse.ai 与 agent.bot.goog 的密钥目录,604800 这个值来自第三方在 11 月 16 日的两次实测。
资料来源:Forter《AI Agent Order Data》(2026-11-16 更新)、IETF webbotauth 工作组草案、Cloudflare AI Crawl Control 与 Pay Per Crawl 文档、TollBit 抓取合规数据、OpenAI 爬虫说明。
相关阅读:无头浏览器太吃内存 讲的是代理怎么读页面,AI 四小时攻下第一台 讲的是自动化流量怎么找入口,AI 写的 App 能直接上线吗 讲的是发布出去的资产怎么自查。
登录后可点赞、收藏与反馈。