83% 企业算不清 AI 回报:504 份调研里的五个断点
一份覆盖 504 位英国决策者的调研显示,83% 的组织说不清部分 AI 支出的回报,41% 先买工具后找问题,47% 的任务计入校验后反而更慢。本文拆解六个数字之间的因果链,并给出一份五步度量基线。
2026 年 11 月,英国托管服务商 Air IT Group 发布了一份名为《The AI Decision Gap》的调研:504 位组织机构决策者中,83% 无法证明至少一部分 AI 支出带来了可测量的回报。注意措辞——不是「83% 的 AI 投入失败了」,而是「说不清」。这两件事之间的差距,正是本文要拆解的对象:回报缺失的大多数场景,缺的不是模型能力,而是一套事先约定的度量方法。
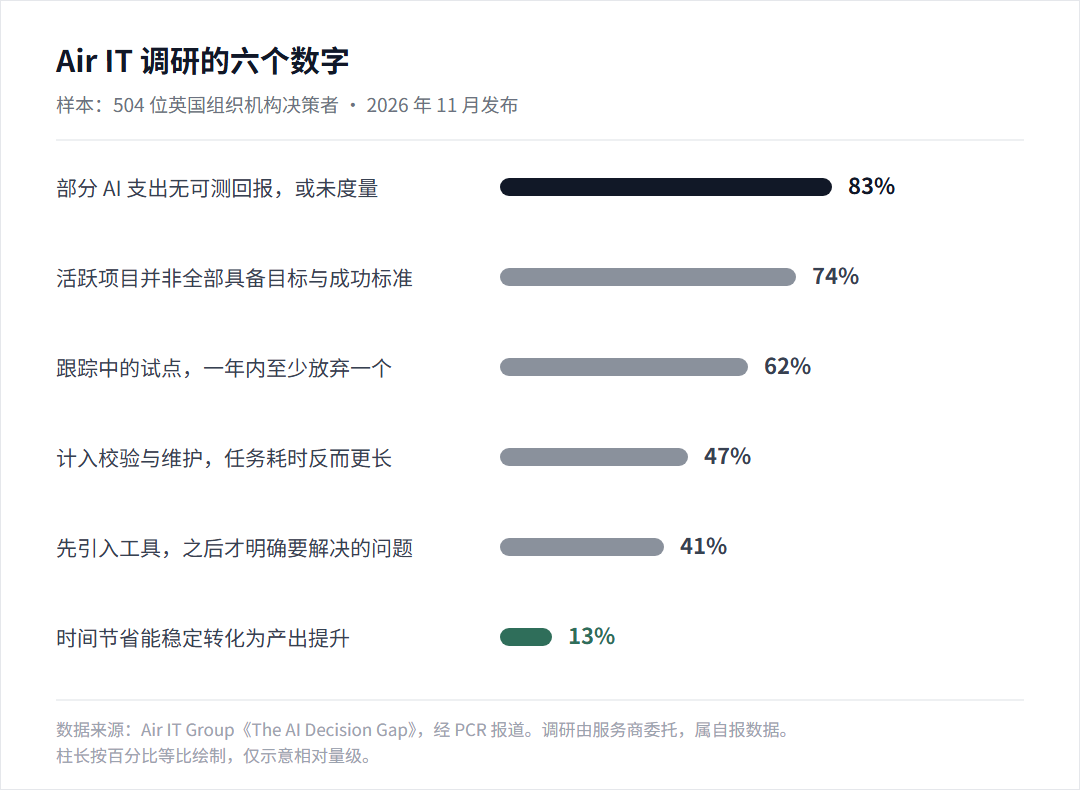
六个数字:先看原始数据
| 指标 | 数值 | 统计口径 |
|---|---|---|
| 部分 AI 支出无可测回报,或根本未度量 | 83% | 全部受访者 |
| 活跃项目并非全部同时具备业务目标与成功标准 | 74% | 至少有一个活跃 AI 项目的受访者 |
| 过去 12 个月放弃过至少一个 AI 试点 | 62% | 正式跟踪 AI 试点者 |
| 计入校验、修正、配置与管理后,任务耗时反而更长 | 47% | 全部受访者 |
| 先引入 AI 工具,之后才明确要解决的问题 | 41% | 全部受访者 |
| 时间节省能稳定转化为产出或效率提升 | 13% | 全部受访者 |
六个数字不是并列关系,而是一条因果链:顺序颠倒导致目标缺失,目标缺失导致无法度量,无法度量导致收益说不清、试点养不活。下面按这条链逐一拆开。
41%:先买工具,再找问题
这是六个数字里最能解释其余几个的一个。超过四成的组织在明确「要解决什么业务问题」之前,就已经把工具买了、用上了。Air IT 把这个现象命名为「AI Decision Gap」——投入与评估能力之间的断层。
顺序颠倒的直接后果是验收标准缺席:没有事先约定的业务问题,就没有可对照的成功定义,回报自然「说不清」。Air IT 集团首席技术官 Lee Johnson 在报告发布时的表述很直白:如果问题和结果从一开始就不清晰,就很难判断 AI 到底有没有创造价值;企业需要先想清楚要达成什么,找到 AI 能产生最大影响的位置,并约定成功如何衡量。
这一条对国内团队同样成立。采购动作往往由预算周期驱动,而不是由问题清单驱动,工具上线日就是关注消退日的开始。
47% 更慢,13% 转化:时间省了不等于产出
47% 的受访者承认,把校验、修正、配置和管理时间算进去之后,AI 让任务或流程变得更慢。这是所有「提效」叙事里最容易被漏记的成本:初稿快了,但验证初稿的时间吃掉了差值。写代码快了,跑测试和排查回归没有快;写文档快了,核对事实和统一口径没有快。
与之对应的另一个数字更能说明问题:只有 13% 表示省下来的时间能稳定转化为可测量的产出增长。首稿速度与最终产出之间,隔着一整套质检、返工和流程重组。组织如果把「省下的时间」直接记成收益而不追问去向,就会持续高估 AI 的回报。
单任务成本怎么算,此前在同一个榜单,单任务成本差 13 倍:Agent 该怎么算账一文里有更细的拆法,结论一致:按任务口径记账,而不是按单价或订阅数记账。
62% 弃过试点:瓶颈不在模型
在正式跟踪试点的组织里,62% 在过去 12 个月放弃过至少一个项目。放弃原因的分布很说明问题:34% 归因于集成困难,29% 归因于员工不采纳,两项合计超过六成——都与模型能力无关。
过去一年模型能力上升的速度有目共睹,Claude Fable 5.2 这一代甚至把编程跑分推到了新的高度,但落地卡点仍然停留在工程集成与组织采纳上。这也解释了为什么「跑分再高」与「回报可测」之间没有必然联系:榜单衡量的是模型上限,试点失败暴露的是系统下限。关于榜单能说明什么、不能说明什么,SuperCLUE 11 月榜:国内模型差的 24 分在哪有专门讨论。
五步度量基线:把 83% 变成可回答的问题
调研给出的方向是清晰的:度量要在花钱之前设计好。落到操作层面,可以压缩成五步:
- 选一个重复发生的任务,先记录基线:当前完成时间、错误率、复核成本,三项都记。
- 在引入任何工具之前,写下成功定义和衡量口径——这是 41% 那个数字的直接教训。
- AI 辅助之后按同一口径重测,校验、返工、配置和管理时间全部计入,不做任何豁免。
- 按任务记账,不按工具订阅数记账;一个工具服务多个任务时拆开算。
- 设定中止条件:连续两个周期无法覆盖基线差值的项目主动放弃,把 62% 的被动弃置变成主动止损。
这五步不需要任何新工具,一张表格就能开始。它的价值不在精确,而在于把「AI 有没有用」从一个立场问题变成一个可核对的数据问题。
数据边界:这份调研能信到什么程度
三点必须说明。其一,调研由 Air IT Group 委托,该公司今年 9 月刚推出面向中小企业的 AI 咨询服务,对「度量缺口」这个叙事有天然的商业动机。其二,样本为 504 位英国组织机构的决策者,地域与组织规模的分层情况未公开。其三,所有数字均为自报数据,没有客观核验。
因此,这些数字适合当作方向提示,而不是精确比例。83% 未必精确,但「先买工具后找问题」「验证成本被漏记」这类结构性问题,在任何市场都不罕见。有意思的是,同一天还有两条新闻与这份调研形成呼应:英格兰银行行长安德鲁·贝利在苏黎世演讲中呼吁对 AI 模型开展更充分的上线前后测试与事件上报;加拿大牵头六国政府,与 Anthropic、微软、OpenAI、Mistral AI 等公司在巴黎签署安全宣言,要求开发者披露能力与局限、支持独立评估。
监管在向「运营保障」靠拢——测试、上报、可核验的证据。企业侧真正缺的其实是同一样东西。模型每个月都在变强,但回答「这笔投入值不值」,至今没有捷径,只有基线。
登录后可点赞、收藏与反馈。