Arc B580 对 RTX 5060 Ti 16G:本地大模型性价比横评
5300 与 2000 的差价,换来 33% 的显存、1.8% 的带宽和 91% 的 prompt 处理。把价格除进去,B580 的每元生成领先 2.3 倍;但默认的 Vulkan 路径会让它在长文档场景被反超。横评后给结论与实测命令。
一张 5100,一张 2000,差价够再买一张 B580 还有找。
Arc B580 12G 与 RTX 5060 Ti 16G 是 2026 年 11 月两个真实存在的选项,价位差两倍半,参数却没有按比例差。
这篇只做横向对比:价格、显存、带宽、能查到的实测、软件栈成熟度。
二手 1500 那一档已经单独写过,这里不重复,只把它当成分母。
先把结论放前面:按"每块钱能出多少 token"算,B580 领先一倍多;按"开箱即用的 prompt 处理"算,5060 Ti 反超一倍多。
差别不在硬件,在你选哪条软件路径。
参数摊开,看钱花在哪
| 项目 | Arc B580 | RTX 5060 Ti 16G |
|---|---|---|
| 参考价(2026-11) | ¥1949–2199 | ¥4650–5300,近期约 ¥5100 |
| 显存 | 12 GB GDDR6 | 16 GB GDDR7 |
| 带宽 | 456 GB/s | 448 GB/s |
| 位宽 | 192-bit | 128-bit |
| 接口 | PCIe 4.0 x8 | PCIe 5.0 x8 |
| 功耗 | 190 W | 180 W |
| tg128(Llama 2 7B Q4_0) | 83.67(SYCL)/ 70.14(Vulkan) | 90.9 |
| pp512(同测试) | 1954(SYCL)/ 621(Vulkan) | 3737 |
B580 的 SYCL 行来自 llama.cpp 讨论区 #23313(2026 年 6 月),Vulkan 与 5060 Ti 行来自社区榜单。
第一眼会注意到带宽几乎一样:456 对 448,差 1.8%。
第二眼才是位宽:192-bit 对 128-bit,差了三分之一。
5060 Ti 用 GDDR7 把窄总线的带宽补了回来。这是这一代的核心取舍:窄位宽、高频率、大显存。
代价在别处。128-bit 的卡在长上下文、大 batch 时更容易被带宽卡住,因为每次读写的突发长度更短。
B580 反过来:位宽够,但显存只有 12 GB,模型一超就得卸载。
接口也值得看一眼。B580 是 PCIe 4.0 x8,5060 Ti 是 PCIe 5.0 x8。
单卡跑推理,两者都够用,因为权重常驻显存、不走总线。
但如果主板是 PCIe 3.0 平台,x8 的链路会更窄,模型加载和层卸载都会变慢。老平台升级的人要留意这一条。
功耗差别不大:190 W 对 180 W,都是单 8-pin。电源要求基本在同一档,550 W 到 600 W 都能带。
买 5060 Ti 要看清容量。它有一个 8 GB 版本,名字几乎一样,价格便宜不少。
8 GB 跑 14B 的 Q4 会直接不够,等于把这张卡的最大卖点砍掉了。下单前确认规格页写的是 16 GB。
价格差 2.5 倍,买到的是 33% 的显存、1.8% 的带宽、9% 的生成速度、91% 的 prompt 处理速度。
按参数算,这笔钱花得不算值。但参数不是全部,下面几节拆开看。
还要提一句市场位置。B580 的首发价是 249 美元,国内成交在 1949 到 2199。
5060 Ti 16G 的首发价是 429 美元,国内成交 4650 到 5300,明显高于折算价。
高出来的部分是 2026 年这轮涨价,不是税费。显卡整体在涨,16 GB 档尤其明显。
两个价位对应两种买法:B580 是"加一张卡试试",5060 Ti 是"这台机器就靠它"。
买法不同,对稳定性的容忍度也不同。这比参数更能解释为什么有人愿意多花三千。
每块钱能买多少 token
把价格除进去,画面会变。
生成速度除以价格:B580 是每千元 41.8 t/s,5060 Ti 是 17.8 t/s。B580 领先 2.3 倍。
prompt 处理除以价格:B580 用 SYCL 是每千元 977 t/s,5060 Ti 是 733。B580 领先 1.3 倍。
但 B580 默认走的是 Vulkan。同样除下来,每千元只有 310 t/s,反过来被 5060 Ti 甩开 2.4 倍。
这三个数字放在一起,说明一件很实际的事:B580 的性价比是有条件的。
条件是你愿意自己跑 llama.cpp 的 SYCL 构建,而不是装个 Ollama 就用。
愿意,B580 在生成和 prompt 两栏都赢;不愿意,B580 只在生成上勉强打平,prompt 上明显吃亏。
这也是两份"性价比结论"能同时成立的原因:分母里算不算你的时间。
按一个人折腾一晚上、第二天还要调驱动来算,那 3000 块的差价其实没那么难接受。
反过来,如果本来就要编 llama.cpp、本来就在追新版后端,那 SYCL 那部分收益是白捡的。
这里没有普适答案,只有"你的时间值多少钱"。
换个算法更直观:3000 的差价按三年摊,每年一千,每月八十多。
如果这八十块能省下每月两小时的折腾,这笔账就划得来;如果不能,就不划算。
还有一个更贴近使用的算法:按你的时间分布加权。
每天只聊天、偶尔问一句,pp 占总时间不到一成,Vulkan 那 621 的劣势几乎感觉不到。
每天做 RAG、喂长文档、让模型读代码库,pp 能占到一半以上,621 与 3737 就是硬伤。
同一张卡,两种用法能得出相反的结论。所以"哪个更值"这个问题,必须先说清楚你每天在干什么。
顺带说一句:per-yuan 这类指标容易被滥用。它假设两张卡的利用率相同,而实际使用里,能跑和不能跑的差别比分母更硬。
所以下一节先看显存,再回头看性价比。
16 GB 是不是那道门槛
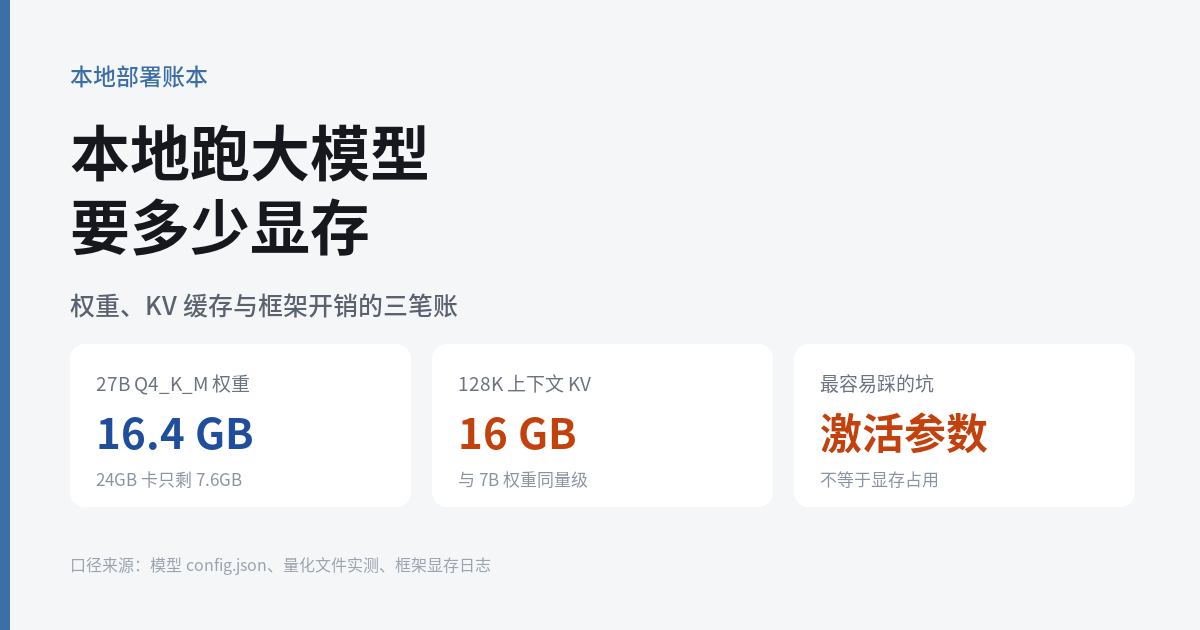
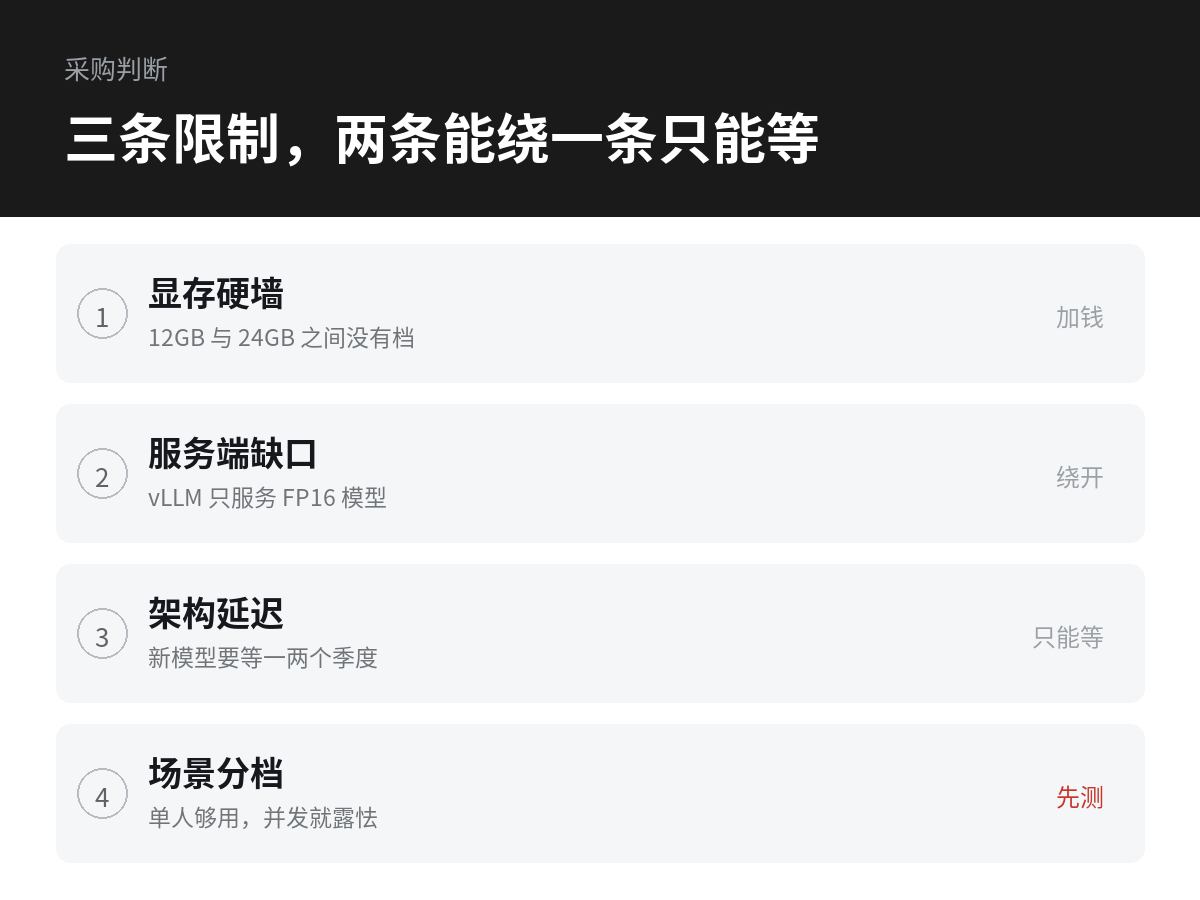
12 GB 与 16 GB 的差别,不在速度,在"能不能跑"。
12 GB 的天花板是 14B 的 Q4:约 8.5 到 9 GB,剩下三 GB 给 KV cache 和运行时。
这三 GB 不经花。8K 上下文下 KV 还能塞进去,16K 就要开量化,32K 基本没戏。
所以 12 GB 的真实定位是"14B 加中等上下文",不是"14B 随便跑"。
16 GB 能往上走一档:27B 的 Q3_K_M 约 15 GB,勉强塞得下;20B 级 MoE 的 4-bit 版本也在 12 到 15 GB 之间。
这不是"跑得快一点",是"原来跑不了的模型现在能跑"。
对每天只跑 7B、8B 的人,这 4 GB 完全不产生价值。
对想试 27B 的人,它是唯一的分界线,没有替代方案。
所以 5060 Ti 的 16 GB 应该按"准入资格"定价,而不是按"多 33% 显存"定价。
还有一条线要考虑:Arc Pro B60 是 24 GB,成交价 5999–6499。
比 5060 Ti 贵九百到一千四,多 8 GB 显存,但带宽还是 456 GB/s,软件栈更生。
如果你的目标是"尽可能大的模型、单人用",B60 的位置比 5060 Ti 更靠前。
如果要的是成熟栈,5060 Ti 更稳,因为 CUDA 那边的坑都被踩过了。
12 GB 也不是完全碰不到 27B。Qwen3.8 27B 的 IQ3_XXS 文件约 10.1 GB,塞得进去。
但塞进去之后只剩不到 2 GB,KV cache 一开就爆。能加载,不等于能对话。
这就是"装得下"和"能用"的区别,12 GB 在这一档只赢前者。
三张卡排下来是:2000 的 12 GB、5100 的 16 GB、6000 的 24 GB。
中间没有 3000 档的 16 GB Arc。这个空档让"加一点预算"的策略失效,只能一次跳两档。
实测数据能查到多少
这一栏必须说清楚,因为两边可查的数据量不对称。
5060 Ti 的用户基数大,同一测试(Llama 2 7B Q4_0、tg128/pp512)的提交多,数字稳定在 90 上下。
B580 的公开数据少,但有几个可用的点:SYCL 下 83.67/1954,Vulkan 下 70.14/621。
另外两个数据点能看出 B580 的性格。
Gemma 4 12B 的 Q4_K_M 在 SYCL 下是 41.34 t/s、pp 1320。
Qwen3-8B 的 Q4_K_M 在 Vulkan 下只有 30.39 t/s、pp 504.72。
12B 的 Gemma 比 8B 的 Qwen 还快,说明差别不在参数量,在 kernel 覆盖。
Qwen 那条路上有些算子没被优化,Gemma 那条路上有。这就是上一节说的"条件"的具体形态。
反过来,5060 Ti 在 Qwen 系列上的同条件数据我没有查到可靠来源,这里就不给数字。
能确定的只有一条:CUDA 上的 kernel 覆盖完整得多,很少出现"同样的卡,换个模型慢一半"这种情况。
榜单的可比性也要打个折。不同提交者的构建版本、驱动、系统都不同。
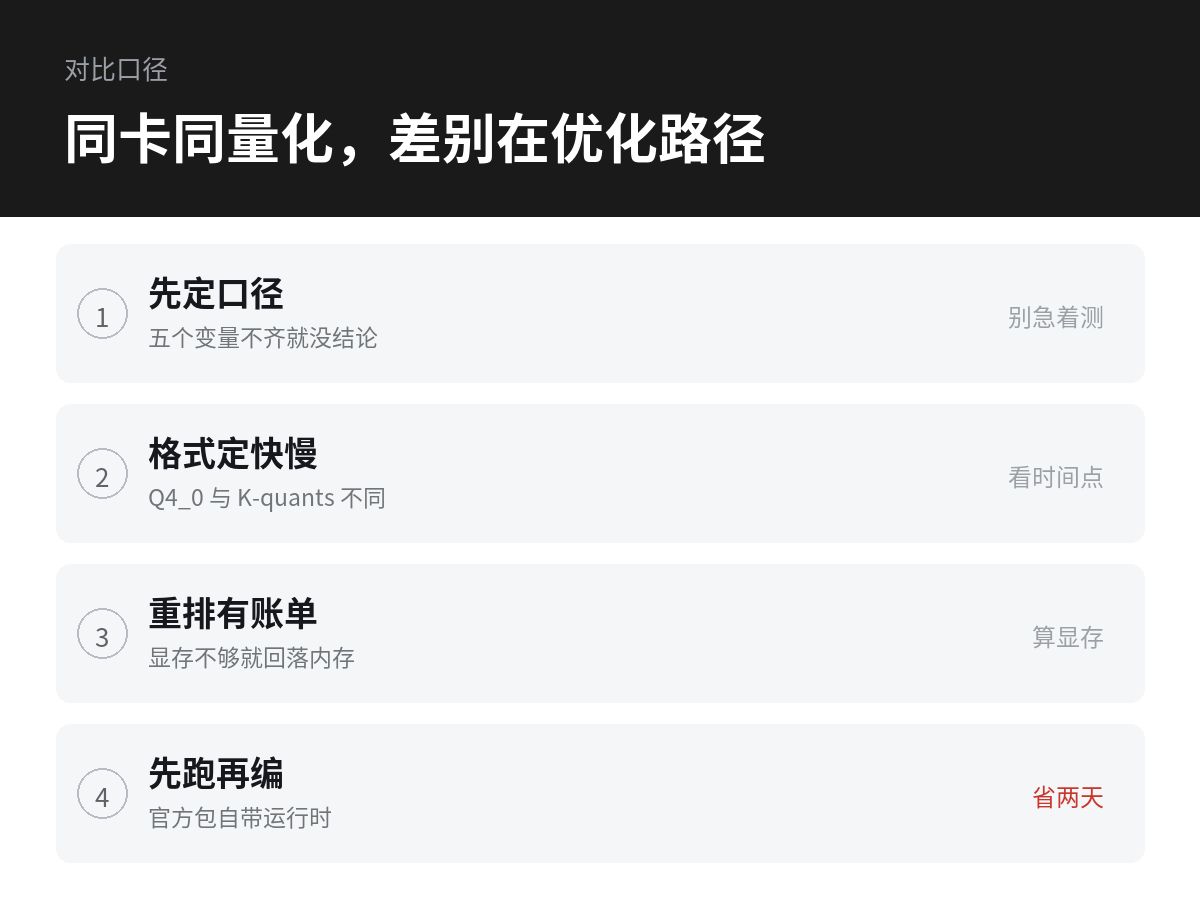
所以跨卡对比只看量级,别抠百分比。真要精确比,得在同一台机器上换卡测。
还有一层:测试条件里的 build 号与驱动版本。SYCL 后端在 2026 年改过好几轮,同一个模型在不同月份能差一倍。
看到没有标注 build 号的数字,就当参考值,别当结论。
B580 那两行尤其如此:70.14 来自 Vulkan 榜单,83.67 来自另一位提交者的 SYCL 测试,中间混着版本差异。
真实的"后端差异"可能比 3.1 倍小,但没有同机同版本的对照,谁也说不清小多少。
这也是为什么本文反复标"同测试"——只有同一模型、同一量化、同一 tg/pp 定义的数字,才值得放在一张表里。
软件栈成熟度
CUDA 这边的优势是可以直接用。
vLLM 在 5060 Ti 上能跑,前提是 CUDA 12.8 以上,否则认不出这张卡。
TensorRT-LLM 也支持,但它的定位是数据中心,消费卡上用属于杀鸡用牛刀,收益不明显。
真正吃 CUDA 红利的是那些"只有 CUDA 实现"的库:flash-attn、各种量化 kernel、大部分自定义节点。
Arc 这边要分两条路看。
llama.cpp 的 SYCL 后端是主路,能跑 GGUF、支持 bf16、有 Windows 预编译包。
性能上它是唯一能吃到 XMX 的路径,pp 能到 1954。
vLLM 的 XPU 后端能跑,但只服务 FP16,且以容器为主。强制 bf16 的模型没有路径。
微调方面,bitsandbytes 从 0.50 起支持 XPU,QLoRA 能跑;flash-attn 没有 XPU 的预编译轮子。
出图方面,两者都能跑。PyTorch 从 2.5 起原生支持 XPU,ComfyUI 会把 Arc 认成 xpu 设备。
但 12 GB 在 1024×1024 上就是舒适区上限,16 GB 能多留一点余量给高分辨率和 ControlNet。
客户端层还有一个容易忽略的点:Ollama 与 LM Studio 在 Arc 上走的是 Vulkan。
也就是说,装得最省事的那两个工具,恰好拿不到 SYCL 的性能。要用 SYCL 只能直接跑 llama.cpp。
驱动也是门槛的一部分。Arc 需要较新的驱动版本,Linux 上还要额外装客户端驱动包。
否则 Ollama 的 Vulkan 路径起不来,只能回落到 CPU,表现为"装了但很慢"。
5060 Ti 这边的要求是 CUDA 12.8 以上,版本不够会直接认不出卡,报错信息还算清楚。
真正拉开差距的是"出问题时能搜到什么"。
5060 Ti 的报错基本都能搜到同款,因为用户多、issue 多、教程多。
B580 的报错经常只有一条 issue,甚至只有讨论区里的一个回复。
这一条的隐性成本最高,因为它不可预测。你不知道下一个坑要花两小时还是两天。
按用途给结论,再自己测一遍
单人推理、跑 7B–14B、愿意自己编 SYCL:B580。每元 token 最高,2.3 倍的差距不是小数。
要开箱即用、经常贴长文档:5060 Ti。默认路径下它的 prompt 处理是 B580 的两倍多。
要跑 27B 或 20B 级 MoE:5060 Ti 或 B60。12 GB 在这一档没有讨论空间。
要做多人服务:5060 Ti。vLLM 的 CUDA 路径成熟,Arc 这边只有 FP16 且多卡不稳。
只是偶尔玩玩、不想折腾:两张都过剩,回到 1500 那一档更合理。
如果预算能到 6000 且只跑单人:B60 的 24 GB 比 5060 Ti 的 16 GB 更能装,代价是软件栈要自己扛。
一句话总结这张对比表:B580 卖的是"每块钱的算力",5060 Ti 卖的是"每小时的确定性"。
两种商品都有人买,只是别拿其中一种的价格去要求另一种。
有两类人不该在这两张卡之间选。
要跑 70B 级模型的,12 GB 和 16 GB 都不够,得看 24 GB 以上或者多卡。
要做多卡训练的,Arc 的多卡路径目前只适合推理,消费卡也没有 NVLink 这类互联。
选了 B580 的话,记住后端的选择比卡的选择更影响体验。这条在别的卡上不成立,在这张卡上成立。
如果不急,等也是一种选择。两张卡的价格都在动,5060 Ti 近期的报价区间从 4650 到 6100。
波动意味着有议价空间,也意味着早买可能买在高点。
最后一步还是自己测。参数表只能排掉明显不合适的选项。
# 通用:先测生成,再测长 prompt
./llama-bench -m your-model.Q4_K_M.gguf -p 512 -n 128 -r 5 -ngl 99
./llama-bench -m your-model.Q4_K_M.gguf -p 4096 -n 128 -r 5 -ngl 99
# Windows,Arc 的 SYCL 预编译包
.\llama-bench.exe -m your-model.Q4_K_M.gguf -p 512 -n 128 -r 5 -ngl 99 -mmp 0两条命令的差值,就是"短对话"和"长文档"的差距。这个比值比绝对速度更能决定日常体验。
再看量化格式。同一模型如果有 Q4_0 版本,跑一遍做对照,能立刻看出 K-quant 的 kernel 有没有跟上。
差出两倍以上,说明你那条后端还没吃到 reorder 优化,先换格式比换卡便宜。
显存档位怎么估,本地跑大模型要多少显存那张表覆盖了 8 档参数与 3 种精度。
预编译包与自编译怎么选,llama.cpp 的 Windows 部署里有对照。
不想写命令行的话,Jan 这类桌面客户端也能接本地后端,但底层仍是同一套 kernel。
登录后可点赞、收藏与反馈。