llama.cpp 的 Vulkan 与 SYCL 在 Arc 上差多少
官方没有同条件对照数据,差距取决于量化格式与硬件代际。本文先固定五个变量,再拆解 SYCL 的 reorder 与 XMX 路径相对 Vulkan 的位置,给出先用现成包验证收益的方法和可复现的 llama-bench 命令。
「Vulkan 和 SYCL 在 Arc 上差多少」这个问题,目前没有一个可以直接引用的数字。官方文档给了两个后端各自的优化记录,但没有同一张卡、同一份代码、同一量化档位下的对照表。
没有对照表不等于没有差异。差异是结构性的,并且可以拆开:哪一段快、在什么量化格式上快、需要满足什么硬件条件。把这三件事分开,比记一个百分比有用。
先固定五个变量,否则测了也白测
LLM 推理的测速里,变量比想象的多。任何一项没对齐,结论就作废。
| 变量 | 为什么必须固定 | 怎么固定 |
|---|---|---|
| 构建版本 | 两个后端都按天在变,跨版本的差异可能大于后端之间的差异 | 记录构建号或提交日期,两边同一天拉取 |
| 量化格式 | Q4_0 与 Q4_K_M 不是同一档,优化命中路径也不同 | 同一个 GGUF 文件,两边共用 |
| 模型 | 架构不同,算子覆盖不同 | 同一个文件,不做任何转换 |
| 上下文深度 | 长上下文会改变 KV cache 与带宽压力 | 用 -d 指定相同深度 |
| 测试类型 | prefill 吃算力,decode 吃带宽,两者不同源 | 用 -p 与 -n 分别测,不要只看合计 |
第五项最容易被忽略。llama-bench 默认跑 pp512 和 tg128 两组,输出里是两行;很多人只看 tg 那一行,然后得出「两个后端差不多」的结论——而真正的差距往往在 pp。
还有两个隐性变量:-fa(Flash Attention)与 KV cache 量化。两边的默认值不一定一致,-fa auto 在不同后端上可能解析成不同结果。测的时候显式写死 -fa on 或 -fa off,别交给自动判断。
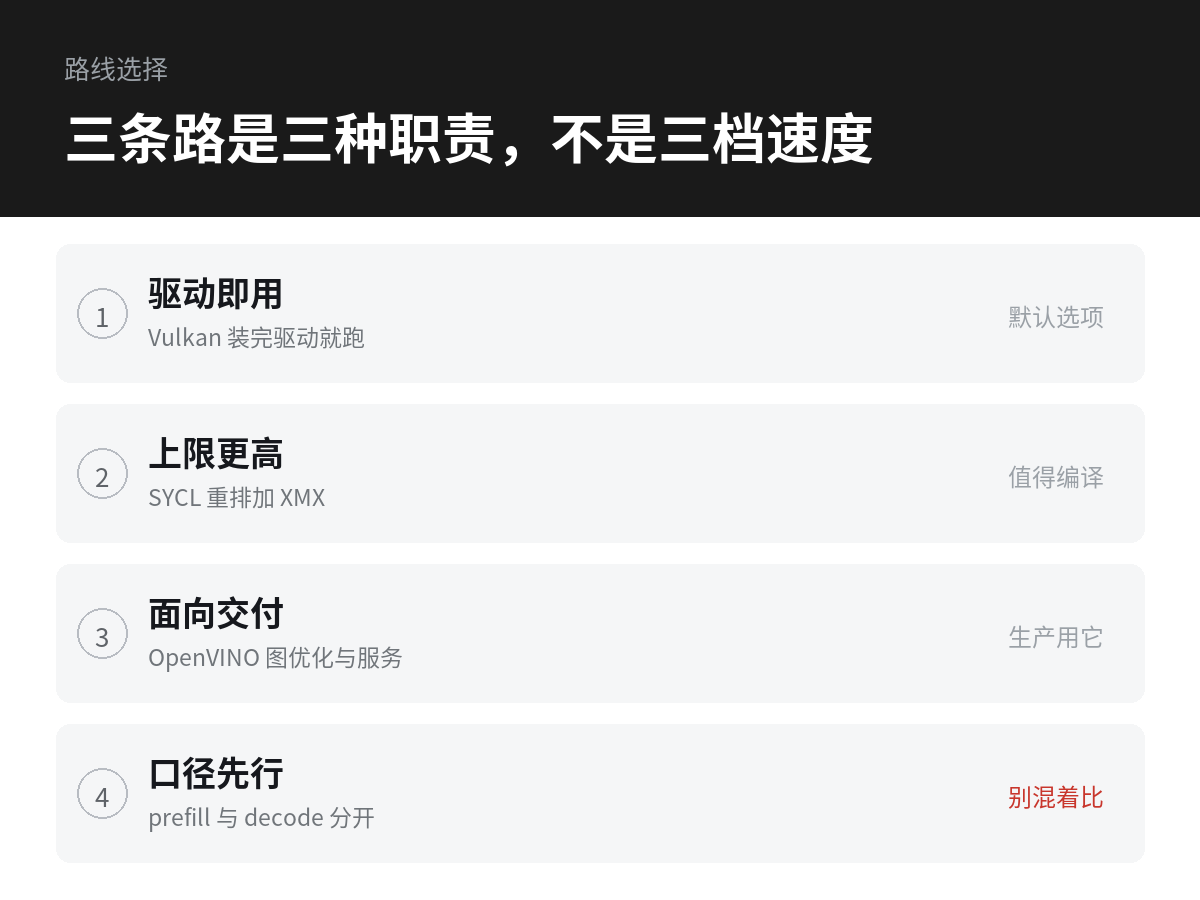
优化路径不一样,所以答案取决于量化格式
这是两个后端最本质的区别,也是「差多少」没法给单一数字的原因。
SYCL 后端有一条 reorder 路径:加载模型时把量化权重重排成设备友好的内部布局,再用 XMX(DPAS)指令做矩阵乘。重排不是无损的开关,它要额外显存、要时间,换来的是 kernel 能吃到硬件矩阵单元。
关键是这条路径覆盖哪些格式,以及什么时候覆盖的。
| 时间 | SYCL 后端的优化 | 覆盖格式 | 文档记录的效果 |
|---|---|---|---|
| 2025.2 | 优化 MUL_MAT | Q4_0 | Arc A770 从 42 t/s 提到 55 t/s(+30%) |
| 2026.03 | 支持 Flash Attention | — | 显存下降,性能影响视模型而定 |
| 2026.04-05 | reorder 扩展到 K-quants | Q4_K、Q5_K、Q6_K、Q8_0 | 官方未给单一数字 |
| 2026.09 | 构建工具链切换到 oneAPI 2026.1 | — | 同一代码在 B570 上 pp 从 434 提到 1331 t/s |
这张表说明一件事:在 2026 年 4 月之前,SYCL 上被专门优化过的格式是 Q4_0,属于老一代的 legacy 量化;K-quants 要到 2026 年 4-5 月才吃到 reorder。
所以如果有人在 2025 年下半年做过对比,得出的结论很可能是「Q4_0 在 SYCL 上明显快」,而在 2026 年 5 月之后重新测,同一张卡上的结论可能反过来——K-quants 在同等体积下质量更好,现在又快,没有理由再选 Q4_0。
这件事对选文件的直接影响是:旧文章推荐的 Q4_0 已经不再是默认最优。同样 4 bit 出头,Q4_K_M 在多数模型上 perplexity 更好,而它在 SYCL 上从 2026 年 4 月起也走 reorder 路径。除非在追极致加载速度或者显存卡得很死,否则没有理由为了那点历史优势继续用 Q4_0。
判断 reorder 有没有生效,有个简单办法:看加载后的显存占用。重排副本会让驻留占用明显超过模型文件体积,差距大致就是副本的大小。如果占用和文件大小几乎一样,说明走的是非重排路径,速度自然上不去。
Vulkan 没有 reorder 这一步。它直接用 GGUF 里的布局,靠 SPIR-V kernel 做通用计算。好处是任何格式都能跑、任何厂商的卡都能跑;代价是没有针对 Xe 核心的专门路径。
Vulkan 在格式支持上还有一处硬缺口:I-quants 只支持一部分。llama.cpp 的 feature matrix 把 Vulkan 的 I-quants 标为 partial,脚注指向 issue #5886,缺的是 IQ3_S 与 IQ1_S。这意味着如果你为了省显存选了 IQ3_S,在 Vulkan 上拿不到对应 kernel,只能由 CPU 或通用路径兜底——不是慢一点,是慢一个数量级。
reorder 不是免费的
SYCL 那些提升有账单,账单开在显存上。
reorder 需要为权重准备一份设备端的重排副本。模型越大、层数越多,这份副本越可观。llama.cpp 为此专门加了一个开关 GGML_SYCL_HOST_MEM_FALLBACK,默认开启,作用是:当显存放不下重排缓冲时,允许回落到主机内存继续推理。
回落意味着数据要过 PCIe。结果是「不崩溃,但明显变慢」——这比直接 OOM 好,但也意味着你以为自己跑在 GPU 上,实际有一部分在主机内存里来回搬。
这个开关还标了一条硬要求:需要 Linux 内核 6.8 以上。Windows 上没有这个机制,显存不够就是不够。
对 12GB 的卡来说,这条边界很实际。7B 的 Q4_K_M 权重约 4.4GB,加上 KV cache、计算缓冲、重排副本,在中长上下文下并不宽裕。如果你在 B580 上把上下文开到 16K 以上,很可能已经触发了回落,而日志里只会显示加载成功。
XMX 路径也有硬件门槛。DPAS 的 Flash Attention kernel 只在 Xe2 及更新的核显/独显上可用,文档点名的是 Arc B 系列、Lunar Lake、Panther Lake、Wildcat Lake,且 KV cache 必须是 q4_0 或 q8_0。A 系列(Alchemist)拿不到这一条。
什么时候值得为 SYCL 折腾编译
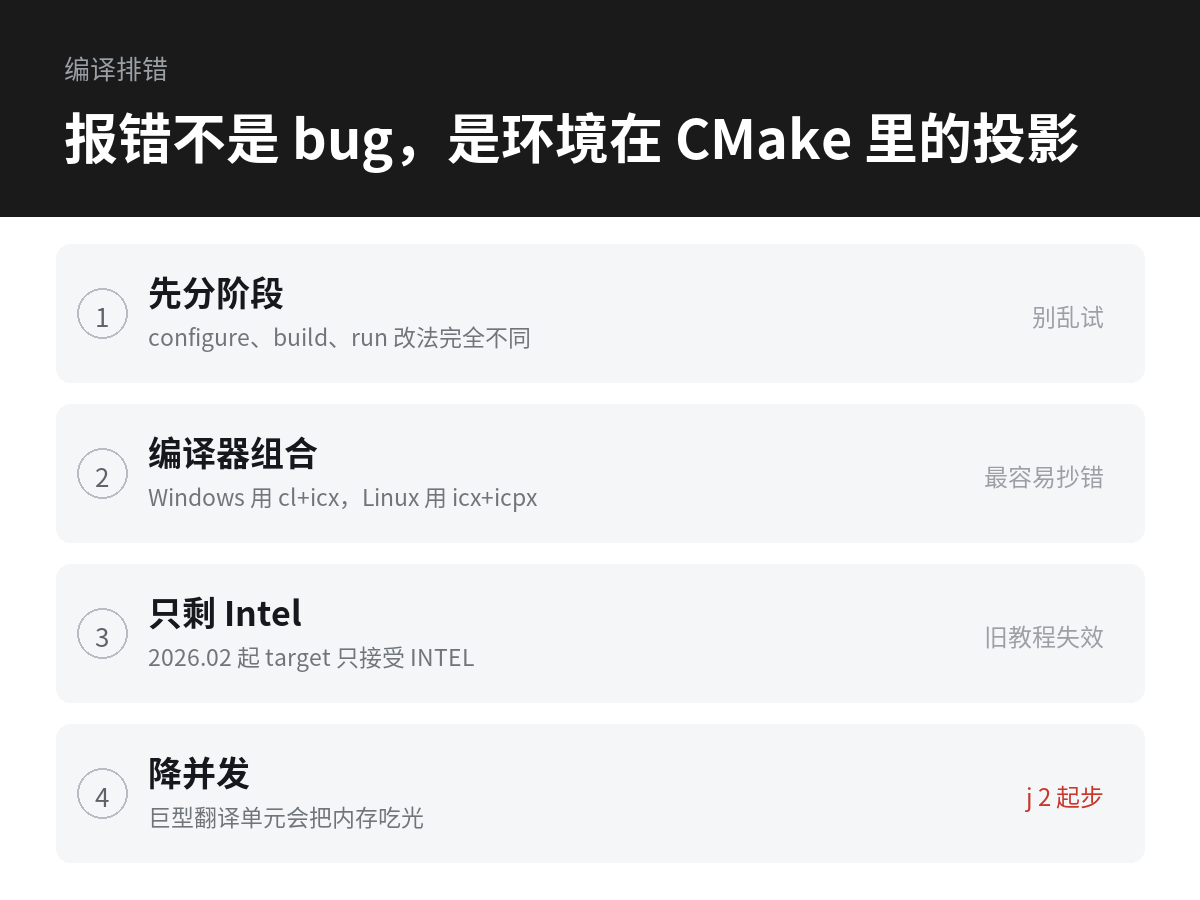
编译 SYCL 版不是装个包,是要装一套工具链、等一次长编译、接受首次启动的 JIT 延迟。值不值得,看你的负载落在哪一格。
值得的情形,有明确特征:
- prompt 长。做 RAG、代码库问答、长文档摘要,输入动辄几千 token,prefill 占大头。这是 SYCL 优势最直接的场景,也是官方那两个 prefill 数字对应的场景。
- 跑 MoE 模型。SYCL 文档里有专门的 XMX gather 路径,把权重直接反量化进矩阵块,官方举例是 Qwen3-30B-A3B 的 UD-IQ3_XXS 在 Arc Pro B60 上 pp512 提升约 50%。Vulkan 没有对应实现。
- 有多张 Arc 卡。SYCL 支持 layer 与 tensor 两种切分;Vulkan 在 feature matrix 里写的是 sequential only,只能顺序切层,谈不上并行。
- 需要量化 KV cache 加 Flash Attention。Xe2 上有现成的 DPAS kernel,条件是
q4_0或q8_0。
不值得的情形同样明确:单卡、短对话、上下文不超过 4K、模型是 7B 级。这类负载里 decode 占主导,而 decode 两个后端差得不多,编译成本很难收回。
还有一条现实约束:如果你用的是 Ollama 或 LM Studio,根本没有 SYCL 选项——它们的 Intel 路径就是 Vulkan。要用 SYCL 只能自己编 llama.cpp,这是排他性的选择,不是加个开关。
先别编:用现成包验证收益
编译之前有一件更省事的事可以做。
llama.cpp 的官方 release 里,Windows 的 SYCL 包自带 SYCL 运行时和依赖 DLL,文档写得很直接:不需要安装 oneAPI,也不需要激活环境。也就是说,想验证「SYCL 在我的卡上到底快多少」,解压一个包就能测,不用碰编译器。
流程是这样:同一个 GGUF,用 release 里的 SYCL 包跑一遍 llama-bench,再用 Vulkan 包跑一遍,参数完全一致。两个数字出来了,再决定要不要为了更细的调优去装 oneAPI 自己编。
这个顺序的价值在于把「试」和「投入」分开。多数人折腾 SYCL 的动力来自别人的数字,而别人的数字大概率不适用——先花二十分钟验证,比花两天配工具链之后才发现没收益要好。
自己编的理由只有两个:要用官方包里没有的开关,或者要用最新提交里的优化。如果只是想跑得快一点,官方包里的改进通常已经够用。
自己测:llama-bench 的用法
llama-bench 是 llama.cpp 自带的测速工具,两个后端共用同一套参数,这是做对照的前提。
# 先确认每个二进制认到了哪些设备
./build-vulkan/bin/llama-bench --list-devices
./build-sycl/bin/llama-bench --list-devices

# 固定模型、固定层数、分别测 prefill 与 decode
./build-vulkan/bin/llama-bench -m model.Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 -fa on
./build-sycl/bin/llama-bench   -m model.Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 -fa on
:: Windows(SYCL 版需先 call setvars.bat)
build-vulkan\bin\llama-bench.exe -m model.Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 -fa on
build-sycl\bin\llama-bench.exe -m model.Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 -fa on几个参数的含义要清楚:-p 是 prompt 长度,-n 是生成长度,设 -n 0 就是只测 prefill;-r 是重复次数,默认 5,结果取平均并给标准差;-fa 显式指定,避免两个后端解析出不同结果;-d 可以指定预填充的上下文深度,测长上下文时必须加。
想一次看多个深度,用逗号分隔,llama-bench 会跑完所有组合:-d 0,4096,8192。
输出默认是 Markdown 表格,两行分别对应 pp512 与 tg128。要留档就加 -o csv 或 -o json,把原始数据存下来——标准差大的时候,平均值没有意义。
# 同一次运行里对比不同量化,注意每个模型都要单独 -m
./build-sycl/bin/llama-bench -m q4_0.gguf -m q4km.gguf -p 512 -n 128 -r 5 -fa on
为什么 Arc 上的差距比别的卡更明显
同样两个后端,放在 NVIDIA 卡上意义不大——CUDA 才是主线,Vulkan 只是备选。放在 Arc 上,差异会被放大,原因是硬件结构。
Xe 架构里有专门做矩阵乘的单元(XMX),它在等宽的数据块上效率极高,但需要数据按特定布局摆好。SYCL 后端可以用 DPAS 指令直接喂它,这正是 reorder 存在的理由:先把权重排成 XMX 喜欢的形状,再让指令去吃。
Vulkan 走的是通用着色器路径。驱动会把 SPIR-V 编译成机器码,能不能用上矩阵单元,取决于驱动的优化能力,而不是 llama.cpp 的控制。用户在这一层没有旋钮可调。
这个差别在 A 系列和 B 系列上还不一样。DPAS 的 Flash Attention kernel 明确要求 Xe2 及更新(Arc B、Lunar Lake、Panther Lake、Wildcat Lake),A 系列拿不到;而 reorder 的 Q4_0 优化早在 2025.2 就覆盖了 A770。所以「A 卡上 SYCL 有多少优势」和「B 卡上 SYCL 有多少优势」是两个不同的问题,不能用同一组结论套。
实测之外的三个变量
就算命令写得一模一样,两次测量也可能对不上。有三个变量不在 llama-bench 的控制范围内。
驱动版本。SYCL 走 Level Zero,Vulkan 走 Vulkan 驱动,两条路径对驱动版本的敏感度不同。升级驱动后两个后端的表现可能朝相反方向变化——这不是猜测,而是两条独立代码路径的必然结果。记录结果时必须带上驱动版本。
操作系统。SYCL 在 Linux 上的成熟度高于 Windows:GGML_SYCL_HOST_MEM_FALLBACK 要求 Linux 内核 6.8 以上,Windows 没有这个机制;Windows 上还要多一层 setvars.bat 的环境注入。同一张卡在两个系统上的相对表现未必一致。
设备选择。机器上同时有核显和独显时,两个后端的默认选择逻辑不同。SYCL 用 ONEAPI_DEVICE_SELECTOR 指定,Vulkan 用 --device 或 GGML_VK_VISIBLE_DEVICES。选错设备测出来的数字毫无意义,而日志里那行设备名很容易被跳过。
这三项加起来,解释了为什么网上流传的对比数字经常互相矛盾:大家测的可能根本不是同一个东西。
读结果时最容易犯的三个错
只看 tg 不看 pp。 两个后端在 decode 上的差距通常小于在 prefill 上的差距。如果你的工作负载是长 prompt,只看 tg 会得出「没必要折腾」的错误结论。
用不同量化对比。 Q4_0 与 Q4_K_M 体积接近但优化路径不同。Q4_0 走的是 2025.2 那条 MUL_MAT 优化,K-quants 要到 2026 年 4 月才有 reorder。拿一个 2025 年的构建测 Q4_K_M,等于让它跑在未优化路径上,结论自然偏向 Q4_0。
忽略首次运行。 SYCL 没有 AOT 编译,第一次启动要 JIT,可能要几十秒甚至几分钟。llama-bench 默认会做预热,但如果你自己写脚本计时,务必把第一次排除掉。
还有一个不算是错误、但值得知道的事实:SYCL 文档明确不建议设置 SYCL_CACHE_PERSISTENT=1。它能加速重复启动,但崩溃后需要手动删掉缓存目录才能恢复。为了省几秒换一个可能卡住的环境,不划算。
顺带说一句标准差。llama-bench 默认重复 5 次并给出 ± 值,这个值超过均值 5% 时,说明系统里有别的负载在抢资源,或者散热触发了降频。这时候的对比结果不可信,要么关掉后台程序重测,要么把 -r 提到 10 次以上再看。
怎么判断自己该不该换
给一个可执行的判断顺序。
先测你自己的负载,不要测别人给的数字。用上面的命令,同一个模型、同一个量化、同样的 -fa,跑一遍两个后端,看 pp 差多少。
然后算收益。如果 pp 的差距在两倍以上,而你的场景里 prefill 占比超过一半,编译成本才可能收回。如果差距在 20% 以内,省下的时间不够补上装工具链和调环境的时间。
最后看边界。显存是否够放重排副本、是不是 Xe2 及更新的卡、有没有第二张卡可以做并行——这三条决定了 SYCL 的优势能不能兑现。不满足的话,即使 pp 数字好看,实际也跑不出来。
具体到显存档位与模型大小的匹配,显存与精度对照表可以先框定范围;24GB 档能跑什么,Qwen3.8-27B 那篇给了实测边界;如果你还没决定用预编译包还是自编译,预编译与自编译的选择里讲了构建号怎么对应。
登录后可点赞、收藏与反馈。